
هر سیستم تصمیمگیری خودکار، از یک بات سادهی بازی شطرنج گرفته تا مدلهای زبانی پیشرفته که با RLHF و الگوریتمهای نوین مثل GRPO آموزش میبینند، بر پایهی یک ساختار ریاضی مشترک ساخته میشود. فرآیند تصمیمگیری مارکوف (MDP) چارچوب استانداردی است که تعامل میان عامل و محیط را فرمولبندی میکند و ابهامات جریان دادههای پیوسته را به متغیرهایی مشخص و قابلحل تبدیل مینماید.
مشکل رایج بسیاری از برنامهنویسان در شروع کار با یادگیری تقویتی، گمشدن میان تنوع الگوریتمها مانند Q-learning یا PPO است؛ در حالی که ریشهی اکثر شکستها در پروژهها نه به الگوریتم، بلکه به مدلسازی نادرست محیط و نادیدهگرفتن فرضیات مارکوف مربوط میشود. با درک دقیق این چارچوب ریاضی پنجگانه، میتوانید هر مسئلهی دنیای واقعی را پیش از نوشتن کد بهدرستی صورتبندی کنید.
تمام مفاهیم پایهای و کدهای این درس کاملاً سبک هستند و برای پیادهسازی و اجرای آنها به سختافزار گرانقیمت یا سرویسهای ابری نیاز ندارید؛ کدهای ارزیابی خطمشی و محیط شبکهای بهراحتی روی پردازندهی استاندارد هر لپتاپ یا سیستمی اجرا میشوند.
فرآیند تصمیمگیری مارکوف (Markov Decision Process یا MDP) از پنج جزء تشکیل شده است: وضعیتها، اکشنها، انتقالها، پاداشها و ضریب تخفیف. هر آنچه در یادگیری تقویتی میبینید — از Q-learning و PPO گرفته تا DPO و GRPO — روی همین ساختار بهینهسازی میکند. این مفهوم را یک بار یاد بگیرید تا ادامهی مباحث یادگیری تقویتی را مثل آب خوردن بخوانید و بفهمید.
صورت مسئله
میخواهید یک بات شطرنج بنویسید؛ یا یک سیستم برنامهریزی موجودی انبار؛ یا یک ایجنت معاملهگر؛ یا حتی حلقهی PPO برای آموزش یک مدل استدلالگر. با چهار حوزهی کاملاً متفاوت روبهرو هستید، اما یک واقعیت شگفتانگیز وجود دارد: هر چهار مورد به یک ساختار ریاضی یکسان تبدیل میشوند.
یادگیری نظارتشده (Supervised Learning) جفتهای (x, y) را در اختیارتان میگذارد و از شما میخواهد تابعی را برازش کنید. در یادگیری تقویتی (Reinforcement Learning) هیچ برچسبی ندارید؛ تنها چیزی که دریافت میکنید جریانی از وضعیتها، اکشنهای انتخابی شما و یک پاداش اسکالر است. آیا این حرکت به برد بازی ختم شد؟ آیا تصمیم برای شارژ انبار هزینهها را کاهش داد؟ آیا آن معامله سودآور بود؟ آیا توکنی که مدل زبانی بزرگ (LLM) تولید کرد، پاداش بالاتری از داور گرفت؟
تا زمانی که این جریان پیوسته را فرمولبندی نکنید، امکان یادگیری از آن وجود ندارد. «آنچه دیدم»، «آنچه انجام دادم»، «آنچه بعداً رخ داد» و «میزان خوب بودن نتیجه»؛ تکتک این مفاهیم باید به موضوعاتی تبدیل شوند که بتوان روی آنها استدلال کرد. این فرمولبندی دقیقاً همان فرآیند تصمیمگیری مارکوف است. تمام الگوریتمهای یادگیری تقویتی در این فاز، از جمله حلقههای RLHF و GRPO در بخش پایانی، روی همین ساختار بهینهسازی انجام میدهند.
مفاهیم کلیدی
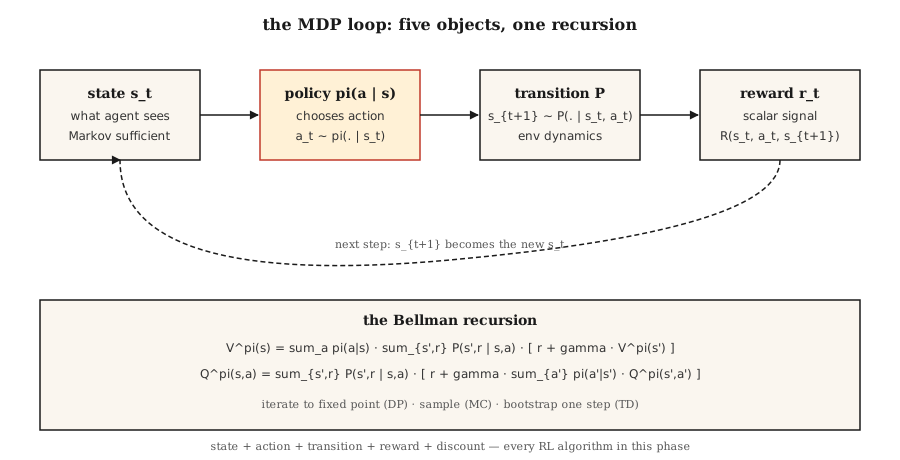
پنج جزء سازنده.
- وضعیتها (States) . هر آنچه ایجنت برای تصمیمگیری نیاز دارد. در دنیای شبکهای (GridWorld)، خانهی جدول؛ در شطرنج، وضعیت صفحهی بازی؛ و در یک LLM، پنجرهی زمینه (context window) به همراه هر حافظهی جانبی.
- اکشنها (Actions) . گزینههای انتخابی. حرکت به بالا/پایین/چپ/راست؛ اجرای یک حرکت در بازی؛ یا تولید یک توکن.
- انتقالها (Transitions) . با فرض وضعیت و اکشن ، توزیع احتمال روی وضعیت بعدی را مشخص میکند. در شطرنج قطعی است، در موجودی انبار تصادفی، و در فرآیند رمزگشایی LLM تقریباً قطعی.
- پاداشها (Rewards) . همان سیگنال اسکالر. برد = +1، باخت = -1. درآمد منهای هزینه. یا جملهی نسبت درستنمایی لگاریتمی در GRPO.
- ضریب تخفیف (Discount) . میزان اهمیت پاداشهای آینده در مقایسه با پاداش فعلی. مقدار افق زمانی حدود 100 گام را میخرد؛ مقدار افقی در حدود 10 گام را.
خاصیت مارکوف (The Markov property) . آینده تنها به وضعیت فعلی وابسته است. اگر اینطور نباشد، بازنمایی وضعیت شما ناقص است؛ این موضوع شکست روش نیست، بلکه ضعف بازنمایی وضعیت است.
خطمشیها و بازدهها. یک خطمشی (policy) وضعیتها را به توزیعی از اکشنها نگاشت میکند. بازده (return) ، مجموع تخفیفخوردهی پاداشهای آینده است. ارزش (value) ، امید ریاضی بازده از وضعیت به بعد تحت خطمشی است. مقدار Q-value ، امید ریاضی بازده با شروع از یک اکشن مشخص است. تمام الگوریتمهای یادگیری تقویتی یکی از این دو را تخمین میزنند و سپس را بر همان اساس بهبود میدهند.
معادلات بلمن (The Bellman equations). معادلات نقطهی ثابتی که زیربنای تمام الگوریتمهای این فاز به شمار میروند:
این معادلات، بازده مورد انتظار را به «پاداش همین گام» بهعلاوهی «ارزش تخفیفخوردهی مقصدی که در آن فرود میآیید» تجزیه میکنند؛ یک رابطهی بازگشتی. تمام الگوریتمهای فاز 9 یا این معادله را تا رسیدن به همگرایی تکرار میکنند (برنامهریزی پویا یا dynamic programming)، یا از آن نمونهبرداری میکنند (مونتکارلو)، یا آن را یک گام جلوتر بوتاسترپ میکنند (تفاضل زمانی یا temporal difference).
پیادهسازی
گام 1: یک MDP قطعی و جمعوجور
یک GridWorld در ابعاد 4×4. ایجنت از بالا-چپ شروع میکند، وضعیت پایانی در پایین-راست قرار دارد، جریمهی هر گام برابر با -1 است و اکشنها شامل {up, down, left, right} هستند. فایل code/main.py را ببینید.
GRID = 4
TERMINAL = (3, 3)
ACTIONS = {"up": (-1, 0), "down": (1, 0), "left": (0, -1), "right": (0, 1)}

def step(state, action):
    if state == TERMINAL:
        return state, 0.0, True
    dr, dc = ACTIONS[action]
    r, c = state
    nr = min(max(r + dr, 0), GRID - 1)
    nc = min(max(c + dc, 0), GRID - 1)
    return (nr, nc), -1.0, (nr, nc) == TERMINAL
تنها پنج خط کد؛ کل محیط همین است. انتقالهای قطعی، جریمهی ثابت برای هر گام، و وضعیت پایانیِ جاذب.
گام 2: اجرای یک خطمشی (Rollout)
خطمشی تابعی است که وضعیت را به توزیع احتمال روی اکشنها نگاشت میکند. سادهترین حالت: انتخاب تصادفی یکنواخت.
def uniform_policy(state):
    return {a: 0.25 for a in ACTIONS}

def rollout(policy, max_steps=200):
    s, total, steps = (0, 0), 0.0, 0
    for _ in range(max_steps):
        a = sample(policy(s))
        s, r, done = step(s, a)
        total += r
        steps += 1
        if done:
            break
return total, stepsخطمشی تصادفی را 1000 بار اجرا کنید. میانگین بازده برای این شبکهی 4×4 حدود -60 تا -80 است. بازده بهینه برابر با -6 است (حرکت روی کوتاهترین مسیر مستقیم به سمت پایین-راست). تمام هدف فاز 9 پر کردن همین فاصله است.
گام 3: محاسبهی دقیق V^π از طریق معادلهی بلمن
برای MDPهای کوچک، معادلهی بلمن یک دستگاه خطی است. وضعیتها را فهرست کنید، امید ریاضی را اعمال کنید و حلقه را آنقدر تکرار کنید تا مقادیر دیگر تغییر نکنند.
def policy_evaluation(policy, gamma=0.99, tol=1e-6):
    V = {s: 0.0 for s in all_states()}
    while True:
        delta = 0.0
        for s in all_states():
            if s == TERMINAL:
                continue
            v = 0.0
            for a, pi_a in policy(s).items():
                s_next, r, _ = step(s, a)
                v += pi_a * (r + gamma * V[s_next])
            delta = max(delta, abs(v - V[s]))
            V[s] = v
        if delta < tol:
            return V
این روش ارزیابی تکراری خطمشی (iterative policy evaluation) نام دارد؛ نخستین الگوریتم کتاب ساتن و بارتو (Sutton & Barto) و پایهی نظری تمام روشهای بعدی یادگیری تقویتی.
گام 4: γ هایپرپارامتری با معنای فیزیکی است
افق زمانی مؤثر تقریباً برابر با است. بنابراین: معادل 10 گام، معادل 100 گام، و معادل 1000 گام خواهد بود.
مقدار خیلی کم باعث رفتار کوتهبینانهی ایجنت میشود. مقدار خیلی زیاد هم تخصیص اعتبار (credit assignment) را نویزی میکند، چون گامهای اولیهی فراوانی در پاداش آیندهی دور شریک میشوند. روش RLHF در مدلهای زبانی معمولاً از استفاده میکند، چرا که اپیزودها کوتاه و محدودند. تسکهای کنترلی از بازهی 0.95–0.99 استفاده میکنند و بازیهای استراتژیک با افق بلند به 0.999 نیاز دارند.
تلهها
- وضعیت غیرمارکوفی (Non-Markovian state). اگر برای تصمیمگیری به سه مشاهدهی قبلی نیاز دارید، «وضعیت» صرفاً مشاهدهی فعلی نیست. راهحل: چیدن فریمها روی هم (DQN در آتاری 4 فریم را استک میکند) یا استفاده از وضعیت بازگشتی (اعمال لایههای LSTM/GRU روی مشاهدات).
- پاداشهای تنک (Sparse rewards). پاداشهایی که فقط با برد داده میشوند، یادگیری را در فضاهای وضعیت بزرگ تقریباً غیرممکن میکنند. پاداشها را شکلدهی کنید (مهندسی سیگنالهای میانی) یا با یادگیری تقلیدی (imitation learning) کار را جلو بیندازید (فاز 9 · 09).
- دور زدن پاداش (Reward hacking). بهینهسازی یک پاداش نیابتی (proxy) اغلب رفتارهای ناهنجاری به بار میآورد. ایجنت قایقرانی OpenAI به جای تمام کردن مسابقه، مدام دور خود میچرخید تا امتیازهای تقویتی را جمع کند. همیشه تابع پاداش را بر اساس نتیجهی هدف نهایی تعریف کنید، نه معیارهای نیابتی.
- تنظیم نادرست ضریب تخفیف. قرار دادن روی تسکهایی با افق نامحدود، ارزش تمام وضعیتها را بینهایت میکند. همیشه یا با یک افق محدود سقف بگذارید یا شرط را رعایت کنید.
- مقیاس پاداش. پاداشهای {+100, -100} در مقایسه با {+1, -1} خطمشی بهینهی یکسانی تولید میکنند، اما اندازهی گرادیانهای آنها از زمین تا آسمان فرق دارد. پیش از فرستادن پاداش به PPO یا DQN، حتماً آن را حولوحوش بازهی
[-1, 1]نرمال کنید.
کاربرد عملی
پایپلاینهای مدرن در سال 2026، پیش از دست زدن به کد، هر مسئلهی یادگیری تقویتی را به یک MDP تبدیل میکنند:
| موقعیت | وضعیت | اکشن | پاداش | γ |
|---|---|---|---|---|
| کنترل رباتیک (حرکت، دستورزی) | زاویهی مفاصل + سرعتها | گشتاورهای پیوسته | شکلدهیشده متناسب با تسک | 0.99 |
| بازیها (شطرنج، گو، پوکر) | صفحهی بازی + تاریخچه | حرکت قانونی | برد = +1 / باخت = -1 | 1.0 (محدود) |
| موجودی انبار / قیمتگذاری | حجم موجودی + تقاضا | مقدار سفارش | درآمد منهای هزینه | 0.95 |
| آموزش RLHF برای مدلهای زبانی | توکنهای کانتکست | توکن بعدی | امتیاز مدل پاداش در انتها | 1.0 (اپیزود حدود 200 توکن) |
| الگوریتم GRPO برای استدلال | پرامپت + پاسخ جزئی | توکن بعدی | امتیاز 0 یا 1 وریفایر در انتها | 1.0 |
پیش از نوشتن هرگونه حلقهی آموزش، پنجتایی MDP را مشخص کنید. بیشتر گزارشهای باگ «یادگیری تقویتی جواب نمیدهد» به فرمولبندی نادرست MDP روی کاغذ برمیگردد.
خروجی نهایی
این محتوا را در فایل outputs/skill-mdp-modeler.md ذخیره کنید:
---
name: mdp-modeler
description: Given a task description, produce a Markov Decision Process spec and flag formulation risks before training.
version: 1.0.0
phase: 9
lesson: 1
tags: [rl, mdp, modeling]
---

Given a task (control / game / recommendation / LLM fine-tuning), output:

1. State. Exact feature vector or tensor spec. Justify Markov property.
2. Action. Discrete set or continuous range. Dimensionality.
3. Transition. Deterministic, stochastic-with-known-model, or sample-only.
4. Reward. Function and source. Sparse vs shaped. Terminal vs per-step.
5. Discount. Value and horizon justification.

Refuse to ship any MDP where the state is non-Markovian without explicit mention of frame-stacking or recurrent state. Refuse any reward that was not defined in terms of the target outcome. Flag any `γ ≥ 1.0` on an infinite-horizon task. Flag any reward range >100x the typical step reward as a likely gradient-explosion source.تمرینها
- ساده. GridWorld ابعاد 4×4 و اجرای خطمشی تصادفی را در
code/main.pyپیادهسازی کنید. آن را برای 10,000 اپیزود اجرا کنید. میانگین و انحراف معیار بازده را گزارش دهید و با بازده بهینه (-6) مقایسه کنید. - متوسط. تابع
policy_evaluationرا با مقادیر برای خطمشی تصادفی یکنواخت اجرا کنید. مقدارVرا برای هر حالت به شکل یک شبکهی 4×4 چاپ کنید. توضیح دهید چرا با بزرگتر شدن ، ارزش وضعیتهای نزدیک به نقطه پایانی سریعتر رشد میکند. - سخت. محیط GridWorld را تصادفی (احتمالاتی) کنید: هر اکشن با احتمال به یکی از جهتهای مجاور بلغزد. خطمشی یکنواخت را دوباره ارزیابی کنید. آیا مقدار
V[start]بهتر میشود یا بدتر؟ چرا؟
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| MDP | «چارچوب یادگیری تقویتی» | چندتایی که در خاصیت مارکوف صدق میکند. |
| وضعیت (State) | «آنچه ایجنت میبیند» | آمارهی بسنده برای پویاییهای آینده تحت کلاس خطمشی انتخابی. |
| خطمشی (Policy) | «رفتار ایجنت» | توزیع شرطی یا نگاشت قطعی . |
| بازده (Return) | «مجموع پاداشها» | مجموع تخفیفخوردهی از گام فعلی به بعد. |
| ارزش (Value) | «میزان خوب بودن وضعیت» | امید ریاضی بازده تحت با شروع از وضعیت . |
| ارزش عمل (Q-value) | «میزان خوب بودن اکشن» | امید ریاضی بازده تحت با شروع از با اولین اکشن . |
| معادله بلمن (Bellman equation) | «رابطهی بازگشتی برنامهریزی پویا» | تجزیهی نقطهی ثابت ارزش یا ارزش Q به پاداش تکگام بهعلاوهی ارزش تخفیفخوردهی وضعیت بعدی. |
| تخفیف | «آینده در برابر حال» | وزن هندسی روی پاداشهای آیندهی دوردست؛ تعیینکنندهی افق مؤثر . |
مطالعهی بیشتر
- کتاب Sutton & Barto (2018). Reinforcement Learning: An Introduction, ویرایش دوم — کتاب مرجع اصلی. فصل 3 به MDPها و معادلات بلمن میپردازد؛ فصل 1 فرضیهی پاداش (reward hypothesis) را مطرح میکند که مبنای تمام درسهای بعدی است.
- کتاب Bellman (1957). Dynamic Programming — خاستگاه معادلهی بلمن.
- مجموعه OpenAI Spinning Up — بخش 1: مفاهیم کلیدی — راهنمای موجز MDP با دیدگاه یادگیری تقویتی عمیق.
- کتاب Puterman (2005). Markov Decision Processes — مرجع تحقیق در عملیات برای بررسی دقیق MDPها و روشهای حل تحلیلی.
- پایاننامهی دکتری Littman (1996). Algorithms for Sequential Decision Making — واضحترین و تمیزترین استخراج MDP به عنوان شاخهای تخصصی از برنامهریزی پویا.