
در یادگیری تقویتی (Reinforcement Learning)، وقتی مدل دقیق محیط یعنی ماتریسهای انتقال و تابع پاداش را در اختیار داریم، نیازی به حدس زدن یا اکتشاف تصادفی از طریق نمونهبرداری نیست. در چنین شرایطی، برنامهریزی پویا (Dynamic Programming یا DP) راهکار بهینه و بدون خطای ریاضی را فراهم میکند و به عنوان ملاک اصلی درستی برای سایر الگوریتمهای تخمینی شناخته میشود.
درک عمیق سازوکار الگوریتمهای تکرار سیاست (Policy Iteration) و تکرار مقدار (Value Iteration) نه تنها پایهی یادگیری مفاهیمی مثل Q-learning و بازیابی رفتار در مدلهای نوین است، بلکه ابزاری ضروری برای اعتبارسنجی و خطایابی کدهای یادگیری تقویتی به شمار میرود. تمام کدهای این درس با کتابخانههای استاندارد پایتون و بدون نیاز به سختافزار خاص یا اتکا به سرویسهای ابری خارجی روی سیستم شخصی قابل اجرا هستند.
برنامهریزی پویا (Dynamic Programming یا DP) همان یادگیری تقویتی (Reinforcement Learning یا RL) است، منتها با تقلب! شما توابع انتقال و پاداش را از قبل میدانید؛ فقط کافی است معادلهی بلمن را آنقدر تکرار کنید تا یا دیگر تغییر نکند. این روش همان معیاری است که تمام روشهای مبتنی بر نمونهبرداری تلاش میکنند به آن نزدیک شوند.
صورت مسئله
یک MDP با مدلی معلوم در اختیار دارید: میتوانید برای هر جفت وضعیت-عمل، مقادیر و را بپرسید. یک مدیر انبار، توزیع تقاضا را میداند. یک بازی تختهای، انتقالهای کاملاً قطعی دارد. یک دنیای شبکهای (GridWorld) هم در چهار خط کد Python خلاصه میشود. یعنی شما یک مدل در دست دارید.
یادگیری تقویتی بدون مدل (Model-free RL نظیر Q-learning، PPO و REINFORCE) برای شرایطی ابداع شد که مدلی ندارید و تنها راهتان، نمونهبرداری از محیط است. اما وقتی مدل را دارید، روشهای سریعتر و بهتری هم هست: برنامهریزی پویا. ریچارد بلمن این روشها را در سال 1957 طراحی کرد. این الگوها هنوز هم معیار درستی کارند؛ وقتی میگویند «سیاست بهینه برای این MDP»، منظور دقیقاً همان سیاستی است که DP خروجی میدهد.
در سال 2026، به سه دلیل به این روشها نیاز دارید. اول، تمام محیطهای جدولی در پژوهشهای یادگیری تقویتی (GridWorld، FrozenLake، CliffWalking) با DP حل میشوند تا سیاست بهینهی مرجع (Gold-standard) به دست آید. دوم، داشتن مقادیر دقیق به شما امکان میدهد روشهای مبتنی بر نمونهبرداری را دیباگ کنید: اگر تخمین Q-learning برای به اندازهی 30% با پاسخ DP اختلاف داشته باشد، کد Q-learning شما باگ دارد. سوم، روشهای مدرن یادگیری تقویتی آفلاین و الگوریتمهای برنامهریزی (MCTS، جستجوی AlphaZero، و RL مبتنی بر مدل در فاز 9 · 10) همگی بهروزرسانی بلمن (Bellman backup) را روی مدلی یادگرفتهشده یا دادهشده تکرار میکنند.
مفاهیم کلیدی
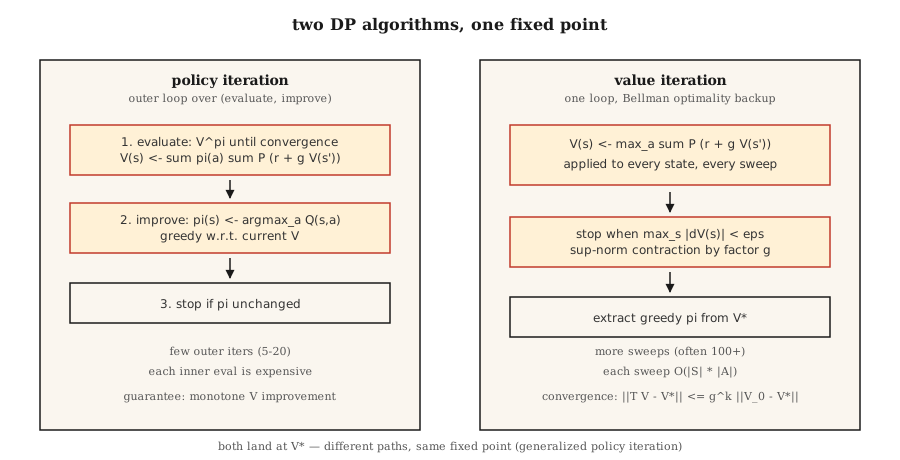
دو الگوریتم، هر دو مبتنی بر تکرار نقطهی ثابت روی بلمن.
تکرار سیاست (Policy Iteration): دو گام زیر را به نوبت آنقدر تکرار میکند تا سیاست دیگر تغییری نکند:
- ارزیابی (Evaluation): برای سیاست دادهشدهی ، با اعمال مکرر تا زمان همگرایی، مقدار را محاسبه کنید.
- بهبود (Improvement): بر اساس ، سیاست را نسبت به حریصانه (Greedy) کنید: .
همگرایی تضمینشده است، زیرا: (الف) هر گام بهبود یا را ثابت نگه میدارد یا مقدار را برای وضعیتی اکیداً افزایش میدهد، (ب) فضای سیاستهای قطعی متناهی است. این الگوریتم معمولاً حتی برای فضاهای وضعیت بزرگ، در حدود 5 تا 20 تکرار حلقهی بیرونی همگرا میشود.
تکرار مقدار (Value Iteration): ارزیابی و بهبود را در یک پیمایش واحد ادغام میکند. معادلهی بهینگی بلمن را اعمال کنید:
این کار را تا زمانی که برقرار شود تکرار کنید. در پایان، با انتخاب عمل حریصانه، سیاست را استخراج کنید. این روش در هر تکرار اکیداً سریعتر است — چون حلقهی ارزیابی درونی ندارد — اما معمولاً برای همگرایی به تکرارهای بیشتری نیاز دارد.
تکرار تعمیمیافتهی سیاست (Generalized Policy Iteration یا GPI): چارچوب یکپارچهساز این مفاهیم. تابع ارزش و سیاست در یک حلقهی بهبود دوطرفه به هم قفل شدهاند؛ هر روشی که هر دوی آنها را به سمت سازگاری متقابل ببرد (تکرار ناهمگام مقدار، تکرار سیاست اصلاحشده، Q-learning، روشهای Actor-Critic، PPO) نمونهای از GPI است.
چرا اهمیت دارد؟ عملگر بلمن در نُرم سوپرمم (Sup-norm) یک انقباض است: . انقباض به معنای وجود نقطهی ثابت یکتا و همگرایی هندسی است. اگر را کنار بگذارید، این تضمین را از دست میدهید — در این صورت به یک افق متناهی یا یک وضعیت پایانی جاذب (Absorbing terminal state) نیاز خواهید داشت.
پیادهسازی از صفر
گام 1: ساخت مدل MDP برای GridWorld
از همان GridWorld اندازهی 4×4 در درس 01 استفاده میکنیم. یک نسخهی تصادفی هم به آن اضافه میکنیم: با احتمال 0.1 ایجنت لیز میخورد و به یک جهت عمود تصادفی میرود.
SLIP = 0.1

def transitions(state, action):
    if state == TERMINAL:
        return [(state, 0.0, 1.0)]
    outcomes = []
    for direction, prob in action_probs(action):
        outcomes.append((apply_move(state, direction), -1.0, prob))
    return outcomes
تابع transitions(s, a) فهرستی از (s', r, p) را برمیگرداند. کل مدل همین است.
گام 2: ارزیابی سیاست
به ازای یک سیاست π(s) = {action: prob}، معادلهی بلمن را آنقدر تکرار کنید تا دیگر تغییر نکند:
def policy_evaluation(policy, gamma=0.99, tol=1e-6):
    V = {s: 0.0 for s in states()}
    while True:
        delta = 0.0
        for s in states():
            v = sum(pi_a * sum(p * (r + gamma * V[s_prime])
                              for s_prime, r, p in transitions(s, a))
                   for a, pi_a in policy(s).items())
            delta = max(delta, abs(v - V[s]))
            V[s] = v
        if delta < tol:
            return V
گام 3: بهبود سیاست
سیاست را با سیاست حریصانه نسبت به جایگزین کنید. اگر تغییری نکرد، خروجی را برگردانید؛ به نقطهی بهینه رسیدهایم.
def policy_improvement(V, gamma=0.99):
    new_policy = {}
    for s in states():
        best_a = max(
            ACTIONS,
            key=lambda a: sum(p * (r + gamma * V[s_prime])
                              for s_prime, r, p in transitions(s, a)),
        )
        new_policy[s] = best_a
    return new_policy
گام 4: اتصال بخشها به یکدیگر
def policy_iteration(gamma=0.99):
    policy = {s: "up" for s in states()}   # arbitrary start
    for _ in range(100):
        V = policy_evaluation(lambda s: {policy[s]: 1.0}, gamma)
        new_policy = policy_improvement(V, gamma)
        if new_policy == policy:
            return V, policy
        policy = new_policy
همگرایی معمول روی شبکهی 4×4: بین 4 تا 6 تکرار در حلقهی بیرونی. خروجی شامل و سیاستی است که تعداد گامها را اکیداً کاهش میدهد.
گام 5: تکرار مقدار (نسخهی تکحلقهای)
def value_iteration(gamma=0.99, tol=1e-6):
    V = {s: 0.0 for s in states()}
    while True:
        delta = 0.0
        for s in states():
            v = max(sum(p * (r + gamma * V[s_prime])
                       for s_prime, r, p in transitions(s, a))
                   for a in ACTIONS)
            delta = max(delta, abs(v - V[s]))
            V[s] = v
        if delta < tol:
            break
    policy = policy_improvement(V, gamma)
    return V, policy
همان نقطهی ثابت، با خطوط کد کمتر.
خطاهای رایج
- فراموش کردن وضعیتهای پایانی: اگر بلمن را روی یک وضعیت جاذب اعمال کنید، باز هم «بهترین عملی» را برمیگزیند که هیچ تغییری ایجاد نمیکند. با شرط
if s == terminal: V[s] = 0جلوی این کار را بگیرید. - نُرم سوپرمم در برابر L2 برای همگرایی: از
max |V_new - V|استفاده کنید، نه میانگین. تضمین نظری الگوریتم روی نُرم سوپرمم است. - بهروزرسانی درجا (In-place) در برابر همگام (Synchronous): بهروزرسانی در جای
V[s](روش Gauss-Seidel) سریعتر از نگهداری یک دیکشنری مجزایV_new(روش Jacobi) همگرا میشود. کدهای محیط عملیاتی از روش درجا استفاده میکنند. - تساوی میان سیاستها (Policy ties): اگر دو عمل مقدار Q برابری داشته باشند، دستور
argmaxممکن است در هر تکرار تساوی را به شکلی متفاوت بشکند و بررسی «پایداری سیاست» دچار نوسان شود. از روشی پایدار برای شکستن تساویها استفاده کنید (مثلاً انتخاب اولین عمل طبق ترتیبی ثابت). - انفجار فضای وضعیت: الگوریتم DP در هر پیمایش دارای پیچیدگی است. این روش تا حدود 10⁷ وضعیت جواب میدهد. فراتر از آن، به تقریب تابع (Function approximation) نیاز دارید (از فاز 9 · 05 به بعد).
استفاده در پروژههای واقعی
در سال 2026، برنامهریزی پویا هم مبنای سنجش درستی است و هم حلقهی درونی الگوریتمهای برنامهریزی (Planners):
| کاربرد | روش |
|---|---|
| حل دقیق یک MDP جدولی کوچک | تکرار مقدار (سادهتر) یا تکرار سیاست (تکرارهای بیرونی کمتر) |
| اعتبارسنجی پیادهسازی Q-learning یا PPO | مقایسه با بهینهی حاصل از DP در یک محیط آزمایشی |
| یادگیری تقویتی مبتنی بر مدل (فاز 9 · 10) | بهروزرسانی بلمن روی مدل انتقال یادگرفتهشده |
| برنامهریزی در AlphaZero و MuZero | جستجوی درختی مونتکارلو (MCTS) = بهروزرسانی ناهمگام بلمن |
| یادگیری تقویتی آفلاین (CQL، IQL) | تکرار محافظهکارانهی Q — همان DP همراه با جریمه روی عملهای خارج از توزیع (OOD) |
هر بار که میشنوید «تابع ارزش بهینه»، منظور دقیقاً «نقطهی ثابت DP» است. وقتی نمادهای یا را در مقالهای دیدید، همین حلقه را تجسم کنید.
خروجی این درس
این کد را با نام outputs/skill-dp-solver.md ذخیره کنید:
---
name: dp-solver
description: Solve a small tabular MDP exactly via policy iteration or value iteration. Report convergence behavior.
version: 1.0.0
phase: 9
lesson: 2
tags: [rl, dynamic-programming, bellman]
---

Given an MDP with a known model, output:

1. Choice. Policy iteration vs value iteration. Reason tied to |S|, |A|, γ.
2. Initialization. V_0, starting policy. Convergence sensitivity.
3. Stopping. Sup-norm tolerance ε. Expected number of sweeps.
4. Verification. V*(s_0) computed exactly. Greedy policy extracted.
5. Use. How this baseline will be used to debug/evaluate sampling-based methods.

Refuse to run DP on state spaces > 10⁷. Refuse to claim convergence without a sup-norm check. Flag any γ ≥ 1 on an infinite-horizon task as a guarantee violation.تمرینها
- ساده. تکرار مقدار را روی GridWorld اندازهی 4×4 با شرط اجرا کنید. تا رسیدن به شرط چند پیمایش لازم است؟ مقدار را در قالب یک شبکهی 4×4 چاپ کنید.
- متوسط. تکرار سیاست را با تکرار مقدار روی GridWorld تصادفی (با احتمال لغزش
0.1) مقایسه کنید. این موارد را بشمارید: تعداد پیمایشها، زمان واقعی اجرا (Wall-clock time)، و مقدار نهایی . کدام روش از نظر تعداد تکرار سریعتر همگرا میشود؟ از نظر زمان واقعی چطور؟ - سخت. الگوریتم تکرار سیاست اصلاحشده (Modified policy iteration) را پیادهسازی کنید: در مرحلهی ارزیابی، به جای تکرار تا همگرایی کامل، فقط پیمایش اجرا کنید. نمودار خطای را برحسب برای مقادیر مختلف رسم کنید. این منحنی چه نکتهای را دربارهی موازنهی ارزیابی/بهبود به شما میگوید؟
اصطلاحات کلیدی
| اصطلاح | در گفتگوها چه میگویند | معنای دقیق آن چیست |
|---|---|---|
| تکرار سیاست (Policy iteration) | «الگوریتم DP» | تناوب بین ارزیابی () و بهبود (حریصانه کردن نسبت به ) تا زمانی که سیاست دیگر تغییر نکند. |
| تکرار مقدار (Value iteration) | «نسخهی سریعتر DP» | اعمال بهروزرسانی بهینگی بلمن در یک پیمایش؛ به شکل هندسی به همگرا میشود. |
| عملگر بلمن (Bellman operator) | «معادلهی بازگشتی» | ؛ یک انقباض در نُرم سوپرمم است. |
| انقباض (Contraction) | «دلیل همگرایی DP» | هر عملگر با شرط نقطهی ثابت یکتایی دارد. |
| تکرار تعمیمیافتهی سیاست (GPI) | «همهچیز همان DP است» | Generalized Policy Iteration: هر روشی که و را به سوی سازگاری متقابل ببرد. |
| بهروزرسانی همگام (Synchronous update) | «به سبک ژاکوبی (Jacobi)» | استفاده از قدیمی در کل طول یک پیمایش؛ تحلیلپذیری شفاف اما کندتر. |
| بهروزرسانی درجا (In-place update) | «به سبک گاوس-سایدل (Gauss-Seidel)» | استفاده از همزمان با بهروزرسانی آن؛ در عمل سریعتر همگرا میشود. |
برای مطالعهی بیشتر
- Sutton & Barto (2018). Ch. 4 — Dynamic Programming — ارائهی استاندارد و مرجع تکرار سیاست و تکرار مقدار.
- Bertsekas (2019). Reinforcement Learning and Optimal Control — بررسی دقیق و موشکافانهی براهین مربوط به نگاشتهای انقباضی.
- Puterman (2005). Markov Decision Processes — تکرار سیاست اصلاحشده و تحلیل همگرایی آن.
- Howard (1960). Dynamic Programming and Markov Processes — مقالهی اصلی معرف تکرار سیاست.
- Bertsekas & Tsitsiklis (1996). Neuro-Dynamic Programming — پلی میان DP و DP تقریبی / یادگیری تقویتی عمیق که در تمام درسهای بعدی به کار میرود.