
در دهههای گذشته، محیط بازیها همواره آزمایشگاه اصلی بزرگترین جهشهای یادگیری تقویتی (RL) بودهاند؛ از شکست قهرمان تختهنرد با TD-Gammon تا فتح گو و شطرنج با AlphaZero و تسلط بر بازیهای ناشناخته با MuZero. اما نقطه عطف امروز، پیوند این الگوریتمها با جهان مدلهای زبانی بزرگ (LLM) است؛ جایی که حل مسائل ریاضی، کدنویسی و زنجیرههای تفکر منطقی دقیقاً شبیه یک بازی شبیهسازی میشوند.
مدل DeepSeek-R1 در سال 2025 نشان داد که همان اصول بازی با خود و هدایت خطمشی، این بار در قالب الگوریتم بهینهسازی خطمشی نسبی گروه (GRPO)، میتواند استدلال پیچیده را بدون نیاز به دادههای سنگین نظارتشده از صفر به مدلهای زبانی بیاموزد. درک این مسیر مشترک میان بازیها و استدلال متنی، دیدی عمیق و کاربردی از روندهای نوین هوش مصنوعی به شما میدهد.
با این حال، اجرای آزمایشهای مقیاسبزرگ در حوزههایی مثل MuZero نیازمند توان پردازشی بسیار سنگینی است که اجاره یا دسترسی به GPUهای ابری خارجی برای کاربران داخل ایران دشوار و پرهزینه محسوب میشود. خوشبختانه منطق بنیادین این الگوریتمها را میتوان در قالب آزمایشهای سبک، مدلهای مینیاتوری یا بررسی تحلیلی پیادهسازی و بدون نیاز به کلاسترهای گرانقیمت بهطور کامل درک کرد.
سال 1992: الگوریتم TD-Gammon قهرمانان انسانی تختهنرد را صرفاً با یادگیری تفاضل زمانی (TD) شکست داد. سال 2016: AlphaGo لی سدول (Lee Sedol) را مغلوب کرد. سال 2017: AlphaZero بازیهای شطرنج، شوگی و گو را از صفر فتح کرد. سال 2025: DeepSeek-R1 ثابت کرد که همین دستورالعمل، با جایگزینی GRPO بهجای PPO، روی استدلال هم جواب میدهد. بازیها معیاری هستند که تکتک جهشهای این برهه را به پیش راندهاند.
صورت مسئله
بازیها هر آنچه یادگیری تقویتی (RL) میخواهد در خود دارند: پاداش شفاف (برد/باخت)، اپیزودهای بیپایان (ریست شدن از طریق بازی با خود یا self-play)، شبیهسازی بینقص (خودِ بازی همان شبیهساز است)، فضاهای اکشن گسسته یا پیوستهٔ کوچک، و ساختار چندایجنت که تابآوری در برابر حریف (adversarial robustness) را ناگزیر میکند.
تمامی جهشهای بزرگ یادگیری تقویتی روی همین بازیها محک خوردند: الگوریتم TD-Gammon (تختهنرد، 1992)، Atari-DQN (سال 2013)، AlphaGo (سال 2016)، AlphaZero (سال 2017)، OpenAI Five (بازی Dota 2، سال 2019)، AlphaStar (بازی StarCraft II، سال 2019)، MuZero (مدل یادگرفتهشده، 2019)، AlphaTensor (ضرب ماتریس، 2022)، AlphaDev (الگوریتمهای مرتبسازی، 2023) و DeepSeek-R1 (استدلال ریاضی، 2025)؛ که این آخری تازهترین نمایش اثبات کارآمدی تکنیکهای RL بازیمحور روی متن است.
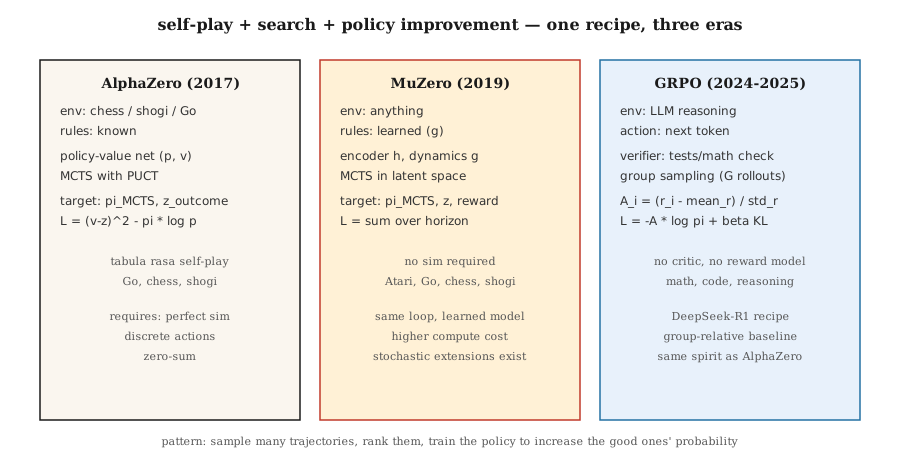
این درس مروری دارد بر سه معماری جریانساز — یعنی AlphaZero و MuZero و GRPO — آن هم از دریچهای واحد: بازی با خود + جستجو + بهبود خطمشی (policy improvement). هر معماری نسخهی قبلی را تعمیم میدهد؛ بهویژه GRPO که در واقع همان دستورالعمل AlphaZero روی استدلال مدلهای زبانی بزرگ (LLM) است؛ با توکنها بهعنوان اکشن و اعتبارسنجی ریاضیاتی بهعنوان سیگنال برد.
مبانی نظری
حلقهی واحد.
while True:
    trajectory = self_play(current_policy, search)     # play game against self
    policy_target = search.improved_policy(trajectory) # search improves raw policy
    policy_net.update(policy_target, value_target)     # supervised on search output
AlphaZero (سال 2017). مقالهی سیلور و همکاران (Silver et al). با فرض وجود یک بازی (شطرنج، شوگی، گو) با قوانین مشخص:
- شبکهی خطمشی-ارزش (Policy-value network): یک برج واحد ، که در آن یک پیشین (prior) روی حرکتهای مجاز است و نتیجهی مورد انتظار از بازی.
- جستجوی درختی مونتکارلو (MCTS): در هر حرکت، درختی از ادامههای ممکن بازی گسترش مییابد. از بهعنوان پیشین + مقدار راهانداز (bootstrap) استفاده میشود. گرهها با معیار UCB (معیار PUCT) انتخاب میشوند: .
- بازی با خود (Self-play): ایجنت مقابل خودش بازی میکند. در حرکت ، توزیع بازدید MCTS یعنی هدف آموزشی خطمشی میشود.
- تابع زیان (loss): . که در آن نتیجهی نهایی بازی است (1+ / 0 / 1-).
بدون ذرهای دانش انسانی؛ بدون هیچ ابتکار شهودی دستساز (heuristics). یک دستورالعمل واحد که پس از چند ده میلیون دست بازی با خود برای هر بازی، به تسلط کامل در شطرنج، شوگی و گو رسید.
MuZero (سال 2019). مقالهی شریتویزِر و همکاران (Schrittwieser et al). شرط دانستن قوانین را برمیدارد:
- بهجای محیط ثابت، یک مدل پویایی نهفته (latent dynamics model) یعنی یاد گرفته میشود:
- : مشاهده را به وضعیت نهفته کدگذاری میکند.
- : وضعیت نهفتهی بعدی + پاداش را پیشبینی میکند.
- : پیشین خطمشی + ارزش را پیشبینی میکند.
- جستجوی MCTS داخل همین فضای نهفتهی یادگرفتهشده اجرا میشود؛ با همان جستجو و همان حلقهی آموزش.
- روی گو، شطرنج، شوگی و همچنین آتاری کار میکند؛ یک الگوریتم واحد، بدون هیچ دانشی از قوانین بازی.
Stochastic MuZero (سال 2022). پویایی تصادفی و گرههای شانس را اضافه میکند و به بازیهای همردهی تختهنرد تعمیم مییابد.
Muesli و Gumbel MuZero (سالهای 2022 تا 2024). بهبودهایی در بهرهوری نمونهها (sample efficiency) و جستجوی قطعی.
GRPO (سالهای 2024 تا 2025). دستورالعمل DeepSeek-R1. همان حلقهی AlphaZero-گونه که روی استدلال مدلهای زبانی پیاده شده است:
-
«بازی»: حل یک مسئلهی ریاضی، برنامهنویسی یا استدلال. «برد» = اعتبارسنج (پاس شدن تست یا تطابق پاسخ عددی) مقدار 1 را برگرداند.
-
خطمشی: همان LLM. اکشنها: توکنها. وضعیت: پرامپت + پاسخ تولیدشده تا این لحظه.
-
بدون منتقد (نقاد یا critic به سبک PPO یعنی ). در عوض، برای هر پرامپت، تعداد خروجی از خطمشی نمونهبرداری میشود. پاداش هر کدام محاسبه میگردد. سپس از مزیت نسبی گروه (group-relative advantage) یعنی بهعنوان سیگنال برای بهروزرسانی به سبک REINFORCE استفاده میشود.
-
جریمهی واگرایی کولبک-لایبلر (KL) نسبت به خطمشی مرجع برای جلوگیری از انحراف مدل (مشابه RLHF).
-
تابع زیان کامل:
بدون مدل پاداش آموزشدیده، بدون منتقد و بدون MCTS. یک اعتبارسنج مبتنی بر قاعده پاداش را فراهم میکند، خط مبنای نسبی گروه جایگزین منتقد میشود و مرحلهی جستجو کلاً کنار میرود. این روش در بنچمارکهای استدلال، کیفیتی همتراز یا فراتر از PPO-RLHF را با کسری از هزینهی پردازشی ارائه میدهد.
دستورالعمل کامل R1. مدل DeepSeek-R1 (سال 2025) در واقع دو مدل در قالب یک مقاله است:
- R1-Zero. شروع از مدل پایهی DeepSeek-V3، بدون هیچ SFT. اعمال مستقیم GRPO با دو مؤلفهی پاداش: پاداش دقت (مبتنی بر قاعده — آیا پاسخ نهایی به عدد درست پارس شد یا کد تستهای واحد را پاس کرد) و پاداش فرمت (آیا زنجیرهی تفکر در تگهای
<think>…</think>قرار گرفته است یا نه). طی هزاران گام، میانگین طول پاسخ از حدود 100 توکن به حدود 10,000 توکن افزایش مییابد و نمرات بنچمارکهای ریاضی به نزدیکی سطوح o1-preview میرسد. مدل استدلال را از صفر یاد میگیرد. نقطهضعف: زنجیرههای تفکر آن اغلب ناخوانا هستند، زبانها را قاطی میکنند و ظرافت نگارشی ندارند. - R1. حل مشکلات خوانایی R1-Zero با یک پایپلاین چهار مرحلهای:
- SFT استارت اولیه (Cold-start). جمعآوری چند هزار نمونهی زنجیرهی تفکر (CoT) طولانی با فرمت تمیز، و فاینتیون نظارتشدهی مدل پایه روی آنها. این کار یک نقطهی شروع خوانا فراهم میکند.
- GRPO استدلالمحور. اعمال GRPO با پاداشهای دقت و فرمت، بههمراه یک پاداش سازگاری زبانی برای جلوگیری از تغییر ناگهانی زبان (code-switching).
- نمونهبرداری طردی (Rejection sampling) + دور دوم SFT. نمونهبرداری از حدود 600K مسیر استدلال از روی چکپوینت RL، نگهداشتن فقط مواردی با پاسخ نهایی درست و CoT خوانا، و ترکیب آنها با حدود 200K نمونهی SFT غیر استدلالی (نگارش، پرسش و پاسخ، خودآگاهی). سپس فاینتیون مجدد مدل پایه.
- GRPO تمامعیار (Full-spectrum). یک دور دیگر RL شامل استدلال (پاداشهای مبتنی بر قاعده) و همراستاسازی عمومی (پاداشهای ترجیحمحور برای مفید و بیضرر بودن).
نتیجه در AIME و MATH-500 با o1 برابری میکند، آن هم با وزنهای باز (open weights)، و آنقدر سبک که بتوان تقطیرش کرد. همان مقاله شش مدل متراکم (dense) تقطیرشده (از Qwen-1.5B تا Llama-70B) را نیز با SFT روی ردپای استدلالهای R1 عرضه میکند — بدون اعمال RL روی مدل دانشآموز. تقطیر دانش یک مدل معلم قدرتمند حاصل از RL همواره در مقیاس مدل دانشآموز عملکرد بهتری نسبت به آموزش RL از صفر دارد.
چرا GRPO بهجای PPO برای استدلال؟ مقالهی DeepSeekMath (فوریه 2024) سه دلیل میآورد: (1) عدم نیاز به آموزش شبکهی ارزش که حافظه را نصف میکند؛ (2) خط مبنای گروهی بهطور طبیعی با پاداش تنک انتهای مسیر (sparse reward) در مسائل استدلالی هماهنگ است؛ (3) نرمالسازی بهازای هر پرامپت باعث میشود مزیتها میان مسائلی با دشواریهای کاملاً متفاوت قابل مقایسه شوند؛ کاری که تکمنتقد PPO از پس آن برنمیآید.
بدون جستجو در برابر متکی به جستجو. مسیر بازیها دو شاخه شده است:
- بازیهای با اطلاعات کامل و افق بلند (گو، شطرنج): همچنان مبتنی بر جستجو؛ AlphaZero و MuZero دست بالا را دارند.
- استدلال در LLM: هنوز خبری از MCTS در محیط عملیاتی (production) نیست؛ فعلاً GRPO روی تمام خروجیها (rollouts) و Best-of-N در زمان استنتاج بهکار میرود. مدلهای پاداش فرایند (PRM) از احتمال بازگشت جستجوی گامبهگام خبر میدهند.
پیادهسازی از صفر
کد موجود در code/main.py یک نسخهی مینیاتوری از GRPO را پیاده میکند: یک مسئلهی راهزن چنددست (bandit) با چندین گروه از نمونهها. الگوریتم دقیقاً همان الگوریتم روی LLM است؛ فقط خطمشی و محیط سادهتر شدهاند. این کد مفهوم تابع زیان و مزیت نسبی گروه را میآموزد؛ همان نوآوری سال 2024 تیم DeepSeekMath.
گام 1: یک محیط اعتبارسنج کوچک
QUESTIONS = [
    {"prompt": "q1", "correct": 3},
    {"prompt": "q2", "correct": 1},
]

def verify(prompt_idx, answer_token):
    return 1.0 if answer_token == QUESTIONS[prompt_idx]["correct"] else 0.0
در کاربرد واقعی GRPO، اعتبارسنجْ تستهای واحد را اجرا میکند یا برابری ریاضی را میسنجد.
گام 2: خطمشی: سافتمکس روی K توکن پاسخ بهازای هر پرامپت
def policy_probs(theta, p_idx):
    return softmax(theta[p_idx])
معادل خروجی لایهی نهایی یک LLM شرطیشده روی پرامپت.
گام 3: نمونهبرداری گروهی و مزیت نسبی گروه
def grpo_step(theta, p_idx, G=8, beta=0.01, lr=0.1, rng=None):
probs = policy_probs(theta, p_idx)
samples = [sample(probs, rng) for _ in range(G)]
rewards = [verify(p_idx, s) for s in samples]
mean_r = sum(rewards) / G
std_r = stddev(rewards) + 1e-8
advs = [(r - mean_r) / std_r for r in rewards]
for a, A in zip(samples, advs):
grad = onehot(a) - probs
for i in range(len(probs)):
theta[p_idx][i] += lr * A * grad[i]
# جریمهٔ KL: کشیدن theta بهسمت مرجع
for i in range(len(probs)):
theta[p_idx][i] -= beta * (theta[p_idx][i] - reference[p_idx][i])مزیت نسبی گروه همان ترفند سال 2024 دیپسیک است. نیازی به منتقد نیست؛ «خط مبنا» همان میانگین گروه است و نرمالسازی با انحراف معیار گروه انجام میشود.
گام 4: مقایسه با خط مبنای REINFORCE (بدون ارزش)
همان ساختار، همان منابع پردازشی، با الگوریتم سادهی REINFORCE. الگوریتم GRPO سریعتر و بسیار پایدارتر همگرا میشود.
گام 5: رصد انتروپی و KL
همان معیارهای تشخیصی RLHF: میانگین KL تا مرجع، انتروپی خطمشی، و روند پاداش در طول زمان. بهمحض تثبیت این معیارها، آموزش کامل شده است.
چالشها و خطاهای رایج
- تقلب در پاداش از طریق دور زدن اعتبارسنج (Reward hacking). الگوریتم GRPO این ریسک RLHF را به ارث میبرد: اگر اعتبارسنج اشتباه داشته باشد یا دورزدنی باشد، LLM آن رخنه را پیدا میکند. طراحی اعتبارسنجهای مقاوم (چندین تست مختلف، اثباتهای صوری) اهمیت حیاتی دارد.
- اندازهی بیش از حد کوچک گروه. واریانس خط مبنای میانگین گروه متناسب با تغییر میکند (خطای استاندارد آن مانند ). در اندازههای کمتر از ، سیگنال مزیت پر از نویز است؛ انتخاب استاندارد مقادیر تا 64 است.
- سوگیری طول (Length bias). خروجیهای LLM با طولهای متفاوت، لگاریتم احتمالهای متفاوتی دارند. باید بر تعداد توکنها نرمالسازی کنید، از log-prob کل توالی استفاده کنید یا خروجی را در حداکثر طول مشخصی برش بزنید.
- دورهای باطل در بازی با خود (Pure self-play cycles). آموزش به سبک AlphaZero در بازیهایی با مجموع غیرصفر ممکن است در چرخههای برتریِ بیپایان گیر بیفتد. برای رفع این مشکل از مجموعهای متنوع از حریفان (league play، درس 10) استفاده میشود.
- عدم تطابق خطمشی و جستجو (Search-policy mismatch). الگوریتم AlphaZero خطمشی را طوری آموزش میدهد که خروجی جستجو را شبیهسازی کند. اگر شبکهی خطمشی برای بازنمایی توزیع حاصل از جستجو خیلی کوچک باشد، آموزش متوقف میشود.
- کف پردازش لازم (Compute floor). مدلهای MuZero و AlphaZero پردازش فوقالعاده سنگینی میخواهند. یک دور بررسی مقایسهای (ablation) اغلب به صدها ساعت GPU نیاز دارد. برای یادگیری میتوانید از نسخههای مینیاتوری (مثل AlphaZero روی بازی Connect Four) استفاده کنید.
- پوشش اعتبارسنج. تستهای واحدی که به یک راهحل باگدار نمرهی قبولی بدهند، همان باگ را در مدل تقویت میکنند. اعتبارسنجهایی بسازید که حالتهای حدی (edge cases) را پیدا کنند.
استفاده از ابزارهای واقعی
چشمانداز یادگیری تقویتی در حوزهی بازیها در سال 2026 بر اساس دامنه:
| دامنه | روش غالب |
|---|---|
| بازیهای تختهای دونفره با مجموع صفر (گو، شطرنج، شوگی) | AlphaZero / MuZero / KataGo |
| بازیهای کارتی با اطلاعات ناقص (پوکر) | CFR + یادگیری عمیق (DeepStack، Libratus، Pluribus) |
| بازیهای پیکسلی و آتاری | Muesli / MuZero / IMPALA-PPO |
| بازیهای استراتژی چندنفرهی بزرگ (Dota، StarCraft) | PPO + بازی با خود + لیگ (OpenAI Five، AlphaStar) |
| استدلال ریاضی و کدنویسی LLM | GRPO (مدلهای DeepSeek-R1، Qwen-RL و بازتولیدهای متنباز) |
| همراستاسازی LLM | DPO / RLHF-PPO (نه GRPO؛ چراکه اعتبارسنج ترجیحمحور است نه قابل وارسی قطعی) |
| رباتیک | PPO + تصادفیسازی دامنه (DR) (از جنس بازی نیست، ولی از همان ابزارهای گرادیان خطمشی بهره میبرد) |
| مسائل ترکیبیاتی | مشتقات AlphaZero (مانند AlphaTensor و AlphaDev) |
این دستورالعمل — بازی با خود، بهبود متکی به جستجو، و تقطیر خطمشی — از متن تا پیکسل و کنترل فیزیکی را در بر میگیرد. روش GRPO تازهترین عضو این خانواده است و موارد بیشتری نیز در راهند.
خروجی این درس
این مستندات را در مسیر outputs/skill-game-rl-designer.md ذخیره کنید:
---
name: game-rl-designer
description: Design a game-RL or reasoning-RL training pipeline (AlphaZero / MuZero / GRPO) for a given domain.
version: 1.0.0
phase: 9
lesson: 12
tags: [rl, alphazero, muzero, grpo, self-play]
---

Given a target (perfect-info game / imperfect-info / Atari / LLM reasoning / combinatorial), output:

1. Environment fit. Known rules? Markov? Stochastic? Multi-agent? Informs AlphaZero vs MuZero vs GRPO.
2. Search strategy. MCTS (PUCT with learned prior), Gumbel-sampled, best-of-N, or none.
3. Self-play plan. Symmetric self-play / league / offline data / verifier-generated.
4. Target signal. Game outcome / verifier reward / preference / learned model. Include robustness plan.
5. Diagnostics. Win rate vs baseline, ELO curve, verifier pass rate, KL to reference.

Refuse AlphaZero on imperfect-info games (route to CFR). Refuse GRPO without a trusted verifier. Refuse any game-RL pipeline without a fixed baseline opponent set (self-play ELO is uncalibrated otherwise).تمرینها
- ساده. مدل راهزن GRPO را در
code/main.pyپیادهسازی کنید. آن را روی 2 پرامپت با 4 توکن پاسخ برای هر کدام آموزش دهید. با در کمتر از 1,000 بهروزرسانی همگرا شوید. - متوسط. الگوریتمهای PPO (نسخهی برشخورده یا clipped) و REINFORCE ساده را جایگزین کنید. بهرهوری نمونهها و واریانس پاداش را روی همین مدل راهزن با GRPO مقایسه کنید.
- سخت. مسئله را به یک «زنجیرهی استدلال» با طول 2 گسترش دهید: ایجنت دو توکن تولید میکند و اعتبارسنج به کل جفت پاداش میدهد. ارزیابی کنید که GRPO چگونه تخصیص اعتبار (credit assignment) را در توالیهای دوگامی مدیریت میکند. (راهنمایی: مزیت گروهی را بهازای توالی کامل محاسبه کرده و به هر دو موقعیت توکن انتشار دهید.)
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای دقیق فنی |
|---|---|---|
| MCTS | «جستجوی درختی با شبکهی یادگرفتهشده» | جستجوی درختی مونتکارلو؛ انتخاب مبتنی بر UCB1/PUCT با پیشینهای یادگرفتهشده. |
| AlphaZero | «بازی با خود + MCTS» | شبکهی خطمشی-ارزش که برای تطابق با تعداد بازدیدهای MCTS و نتیجهی نهایی بازی آموزش میبیند. |
| MuZero | «AlphaZero با مدل یادگرفتهشده» | همان حلقه، ولی درون فضای نهفته از طریق مدل پویاییِ یادگرفتهشده. |
| GRPO | «PPO بدون نقاد» | بهینهسازی خطمشی نسبی گروه (Group Relative Policy Optimization)؛ الگوریتم REINFORCE همراه با خط مبنای میانگین گروه + جریمهی KL. |
| PUCT | «معیار UCB در AlphaZero» | فرمول — ایجاد تعادل بین تخمین ارزش و توزیع پیشین. |
| بازی با خود (Self-play) | «ایجنت علیه گذشتهی خود» | رویکرد استاندارد در بازیهای مجموعصفر؛ سیگنال آموزشی متقارن فراهم میکند. |
| لیگ (League play) | «بازی با خود مبتنی بر جمعیت» | نمونهبرداری از ایجنتهای گذشته، حال و حریفان بهرهبردار (exploiters) بهعنوان رقیب. |
| پاداش اعتبارسنج (Verifier reward) | «یادگیری تقویتی قابل راستیآزمایی» | پاداش از یک بررسیکنندهی قطعی دریافت میشود (پاس شدن تستها، انطباق پاسخ نهایی). |
| پاداش فرایند (Process reward) | «PRM» | امتیازدهی به تکتک مراحل استدلال، نه فقط نتیجهی نهایی. |
برای مطالعهی بیشتر
- سیلور و همکاران (2017). تسلط بر بازی گو بدون دانش انسانی (AlphaGo Zero).
- سیلور و همکاران (2018). الگوریتمی عمومی از یادگیری تقویتی که با بازی با خود به شطرنج، شوگی و گو مسلط میشود (AlphaZero).
- شریتویزِر و همکاران (2020). تسلط بر آتاری، گو، شطرنج و شوگی با برنامهریزی بهکمک مدلی یادگرفتهشده (MuZero).
- وینیالز و همکاران (2019). دستیابی به سطح استادبزرگ در بازی StarCraft II (مدل AlphaStar).
- تیم DeepSeek-AI (سال 2024). گزارش فنی DeepSeekMath: جابجایی مرزهای استدلال ریاضی در مدلهای زبانی باز (GRPO) — مقالهای که الگوریتم GRPO و خط مبنای نسبی گروه را معرفی کرد.
- تیم DeepSeek-AI (سال 2025). مدل DeepSeek-R1: تقویت توانایی استدلال در مدلهای زبانی از طریق یادگیری تقویتی — دستورالعمل کامل چهارمرحلهای R1 همراه با ارزیابی مدل R1-Zero.
- براون و همکاران (2019). هوش مصنوعی فوقانسانی برای پوکر چندنفره (Pluribus) — روش CFR بههمراه یادگیری عمیق در مقیاس بزرگ.
- تِزارو (1995). یادگیری تفاضل زمانی و TD-Gammon — مقالهای که سرآغاز تمام این دستاوردها بود.
- کتابخانهی Hugging Face TRL — کلاس GRPOTrainer — مرجع عملیاتی برای اعمال GRPO بههمراه توابع پاداش سفارشی.
- تیم Qwen (سال 2024). پروژهی Qwen2.5-Math — پیادهسازی مجدد GRPO — بازتولید متنباز از دستورالعمل R1 در مقیاسهای مختلف.
- ساتن و بارتو (2018). فصل 17 — مرزهای یادگیری تقویتی — تشریح ساختار بازی با خود، جستجو و «پاداش طراحیشده» در کتاب مرجع، که R1 آن را در مقیاس LLM عملیاتی کرده است.