
در یادگیری تقویتی کلاسیک، دو چالش اصلی وجود دارد: روش برنامهنویسی پویا به مدل ریاضی و ماتریس احتمالات محیط وابسته است که در دنیای واقعی بهندرت در دسترس داریم؛ از سوی دیگر روش مونتکارلو نیازمند پایان کامل هر اپیزود است و واریانس بالای آن سرعت آموزش را بهشدت کند میکند. یادگیری تفاوت زمانی (Temporal Difference یا TD) پل پیوند میان این دو دیدگاه است که به ایجنت اجازه میدهد پس از هر گام و بدون نیاز به شناخت مدل، با تکیه بر تخمینهای فعلی خود یادگیری را پیش ببرد.
درک عمیق الگوریتمهای پایهای تفاوت زمانی نظیر Q-learning و SARSA سنگ بنای درک روشهای پیشرفتهی یادگیری تقویتی عمیق مانند DQN، PPO و SAC است. کدنویسی این روشها در حالت جدولی بسیار سبک است و بدون نیاز به سختافزار محاسباتی سنگین، روی سیستمهای شخصی معمولی اجرا میشود؛ مهارتی پایه که فهم شما را از نحوهی شکلگیری سیگنالهای خطای TD دقیق و شفاف میکند.
روش مونتکارلو تا پایان اپیزود (Episode) منتظر میماند. روش یادگیری تفاوت زمانی (Temporal Difference یا TD) بعد از هر گام و با بوتاسترپ تخمین مقدار بعدی، مقدارها را بهروزرسانی میکند. الگوریتم Q-learning خارج از خطمشی (Off-policy) و خوشبینانه است؛ الگوریتم SARSA درون خطمشی (On-policy) و محتاط است. هر دو فقط در یک خط کد خلاصه میشوند و زیربنای تمام روشهای یادگیری تقویتی عمیق در این فاز هستند.
صورت مسئله
روش مونتکارلو جواب میدهد، اما دو شرط پرهزینه دارد: اپیزودها حتماً باید تمام شوند، و تازه پس از مشخصشدن بازدهی نهایی بهروزرسانی را انجام میدهد. اگر اپیزود شما 1000 گام باشد، مونتکارلو 1000 گام منتظر میماند تا چیزی را بهروز کند. این روش واریانس بالا، تورش (Bias) کم و در عمل سرعت پایینی دارد.
برنامهنویسی پویا (Dynamic programming) ویژگیهای کاملاً متضادی دارد: بهروزرسانیهای بوتاسترپشده با واریانس صفر، اما نیازمند مدلی مشخص از محیط.
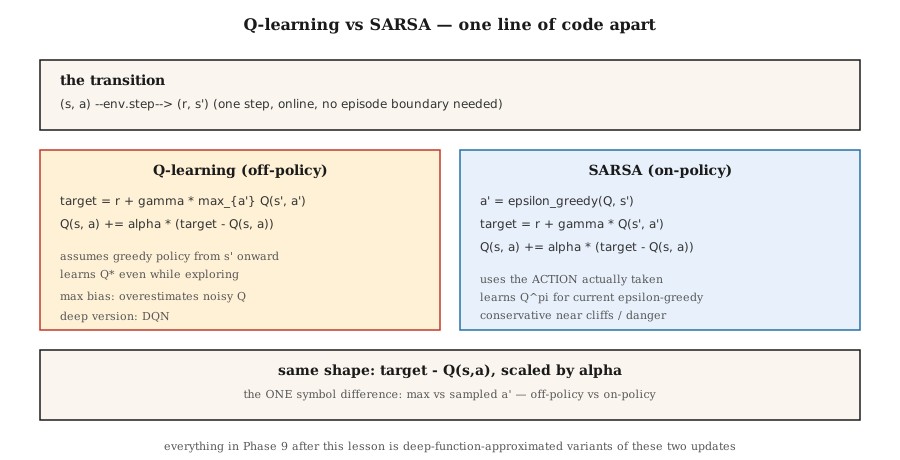
یادگیری تفاوت زمانی (TD) حد واسط این دو است. از دل یک انتقال تکی ، هدفی تکگام میسازد و را کمی به سمت آن هل میدهد. نه به مدل نیازی هست، نه به اپیزودهای کامل. استفاده از یک تقریبی در سمت راست معادله تورش ایجاد میکند، اما واریانس را در مقایسه با مونتکارلو بهشدت پایین میآورد و از همان گام نخست، بهروزرسانیها را آنلاین انجام میدهد.
این همان نقطهی عطفی است که تمام روشهای یادگیری تقویتی نوین (DQN، A2C، PPO و SAC) بر مدار آن میچرخند. ادامهی فاز 9 در واقع لایههایی از تقریب تابع و ترفندهایی است که بر پایهی همین بهروزرسانی تکگام TD بنا شدهاند؛ بهروزرسانیای که در این درس خودتان خواهید نوشت.
مبانی نظری
بهروزرسانی TD(0) برای V:
عبارت داخل قلاب، همان خطای تفاوت زمانی یا خطای TD بنام است؛ معادل آنلاین در روش مونتکارلو. برای همگرایی، باید در شرایط رابینز-مونرو (، ) صدق کند و از تمام حالتها بینهایت بار بازدید شود.
الگوریتم Q-learning. روشی از نوع TD و خارج از خطمشی برای مسئلهی کنترل:
عملگر max فرض میکند که از حالت به بعد، خطمشی حریصانه (Greedy) دنبال خواهد شد؛ صرفنظر از اینکه ایجنت در واقعیت چه عملی انجام میدهد. این تفکیک باعث میشود Q-learning تابع را یاد بگیرد، در حالی که ایجنت با استراتژی ε-greedy مشغول کاوش است. منیه و همکاران (2015) این ایده را به یادگیری عمیق Q روی بازیهای آتاری تعمیم دادند (درس 05).
الگوریتم SARSA. روشی از نوع TD و درون خطمشی:
نام آن از تاپل گرفته شده است. الگوریتم SARSA از عملی () استفاده میکند که ایجنت در گام بعدی در عمل انجام میدهد، نه عمل حاصل از argmax حریصانه. این روش به برای همان خطمشی ε-greedy جاری () همگرا میشود که در حد به تبدیل خواهد شد.
تفاوت در مسئلهی حرکت روی لبهی پرتگاه (Cliff-walking). در مسئلهی کلاسیک پرتگاه (سقوط در پرتگاه = پاداش 100-)، الگوریتم Q-learning مسیر بهینه را دقیقاً در امتداد لبهی پرتگاه یاد میگیرد، اما حین کاوش گهگاه جریمه میشود. در مقابل، SARSA مسیری امنتر با یک گام فاصله از لبه را یاد میگیرد، چرا که نویز ناشی از کاوش را در مقدار Q لحاظ میکند. با آموزش بیشتر، هر دو در نهایت در به حالت بهینه میرسند. در عمل این نکته مهم است: وقتی در فاز استقرار هنوز کاوش وجود دارد، رفتار SARSA محافظهکارانهتر خواهد بود.
الگوریتم Expected SARSA. جایگزین کردن با امید ریاضی آن تحت :
واریانس این روش از SARSA کمتر است (خبری از نمونهبرداری از نیست)، اما همان هدف درون خطمشی را دارد. در کتابهای مرجع امروزی، این روش معمولاً گزینهی پیشفرض است.
روشهای n-step TD و TD(λ). با تأخیر در بوتاسترپ به مدت گام، میان TD(0) و مونتکارلو درونیابی میکنیم. در حالت همان TD است و در به مونتکارلو تبدیل میشود. روش TD(λ) با وزنهای هندسی از تمام میانگین میگیرد. در بیشتر روشهای یادگیری تقویتی عمیق، مقدار بین 3 تا 20 انتخاب میشود.
پیادهسازی
گام 1: پیادهسازی SARSA روی خطمشی ε-greedy
def sarsa(env, episodes, alpha=0.1, gamma=0.99, epsilon=0.1):
    Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})

    def choose(s):
        if random() < epsilon:
            return choice(ACTIONS)
        return max(Q[s], key=Q[s].get)

    for _ in range(episodes):
        s = env.reset()
        a = choose(s)
        while True:
            s_next, r, done = env.step(s, a)
            a_next = choose(s_next) if not done else None
            target = r + (gamma * Q[s_next][a_next] if not done else 0.0)
            Q[s][a] += alpha * (target - Q[s][a])
            if done:
                break
            s, a = s_next, a_next
    return Q
تنها هشت خط کد. تنها تفاوت آن با Q-learning در خط مربوط به مقدار هدف (Target) است.
گام 2: پیادهسازی Q-learning
def q_learning(env, episodes, alpha=0.1, gamma=0.99, epsilon=0.1):
    Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})
    for _ in range(episodes):
        s = env.reset()
        while True:
            a = choose(s, Q, epsilon)
            s_next, r, done = env.step(s, a)
            target = r + (gamma * max(Q[s_next].values()) if not done else 0.0)
            Q[s][a] += alpha * (target - Q[s][a])
            if done:
                break
            s = s_next
    return Q
عملگر max مقدار هدف را از رفتار ایجنت جدا میکند. تمام تفاوت میان روش درون خطمشی و خارج از خطمشی در همین یک عملگر خلاصه میشود.
گام 3: منحنیهای یادگیری
میانگین بازدهی را به ازای هر 100 اپیزود ثبت کنید. الگوریتم Q-learning روی محیط ساده و معین GridWorld سریعتر همگرا میشود؛ اما SARSA در مسئلهی لبهی پرتگاه محتاطانهتر عمل میکند. روی محیط 4×4 GridWorld موجود در code/main.py، هر دو روش بعد از حدود 2000 اپیزود با به عملکردی نزدیک به بهینه میرسند.
گام 4: مقایسه با مقدار واقعی DP
الگوریتم تکرار مقدار (Value iteration از درس 02) را اجرا کنید تا به دست آید. مقدار را بررسی کنید. یک ایجنت جدولی مناسب مبتنی بر TD، بعد از 10000 اپیزود روی محیط 4×4 GridWorld به اختلافی در حدود 0.5~ میرسد.
دامها و خطاهای رایج
- مقادیر اولیهی Q سرنوشتسازند. مقداردهی اولیهی خوشبینانه ( برای تسکی با پاداشهای منفی) ایجنت را به کاوش ترغیب میکند. مقداردهی بدبینانه میتواند خطمشی حریصانه را تا ابد در تله بیندازد.
- زمانبندی نرخ یادگیری (α schedule). نرخ یادگیری ثابت برای مسائل نامانا (Non-stationary) کاملاً مناسب است. کاهش تدریجی از نظر تئوری همگرایی را تضمین میکند، اما در عمل بسیار کند پیش میرود؛ مقدار را در بازهی
[0.05, 0.3]ثابت نگه دارید و منحنی یادگیری (Learning Curve) را زیر نظر بگیرید. - زمانبندی نرخ کاوش (ε schedule). کار را با مقداری بالا شروع کنید () و آن را تا کاهش دهید. شرط "GLIE" (حریصانه در بینهایت همراه با کاوش نامحدود) پیششرط لازم برای همگرایی است.
- تورش بیشینهسازی (Max bias) در Q-learning. وقتی نویزی باشد، عملگر
maxدچار تورش مثبت میشود و مقادیر را بیشتر از حد برآورد میکند. الگوریتم Double Q-learning هسلت (که در DDQN درس 05 به کار رفته) این نقص را با دو جدول Q حل میکند. - اپیزودهای بیپایان. روش TD بدون حالتهای پایانی هم توانایی یادگیری دارد، اما یا باید سقفی برای گامها تعیین کنید یا بوتاسترپ را در آن سقف به درستی مدیریت کنید. رویکرد استاندارد این است: رسیدن به سقف گامها را وضعیت پایانی در نظر نگیرید و به بوتاسترپ ادامه دهید.
- هش کردن وضعیتها (State hashing). اگر وضعیتها بهشکل تاپل یا تنسور (Tensor) هستند، حتماً از کلیدهای قابل هش استفاده کنید (از تاپل استفاده کنید، نه لیست؛ اعداد اعشاری تاپلها را هم گرد کنید و مقادیر خام را نگه ندارید).
کاربردها
چشمانداز روشهای TD در سال 2026:
| تسک | روش | دلیل انتخاب |
|---|---|---|
| محیطهای جدولی کوچک | Q-learning | خطمشی بهینه را مستقیماً یاد میگیرد. |
| سیستمهای حساس به ایمنی (درون خطمشی) | SARSA / Expected SARSA | در طول فاز کاوش محتاط و ایمن است. |
| وضعیتهای ابعاد بالا | DQN (فاز 9 · 05) | شبکهی عصبی تابع Q به همراه بازپخش تجربه (Replay) و شبکهی هدف. |
| فضاهای عمل پیوسته | SAC / TD3 (فاز 9 · 07) | بهروزرسانی TD روی شبکهی Q؛ شبکهی خطمشی اکشنها را تولید میکند. |
| یادگیری تقویتی روی مدلهای زبانی بزرگ (بر پایهی مدل پاداش) | PPO / GRPO (فاز 9 · 08، 12) | ساختار Actor-Critic با تخمین مزیت به سبک TD از طریق GAE. |
| یادگیری تقویتی آفلاین | CQL / IQL (فاز 9 · 08) | همان Q-learning به همراه منظمسازی (Regularization) محافظهکارانه. |
نود درصد مباحث یادگیری تقویتی که در مقالات سال 2026 میخوانید، بهنوعی نسخههای توسعهیافتهی Q-learning یا SARSA هستند. قبل از ورود به مفاهیم عمیقتر، باید این بهروزرسانیهای جدولی را کاملاً با سرانگشتانتان لمس کرده باشید.
ذخیرهی خروجی
کد را در مسیر outputs/skill-td-agent.md ذخیره کنید:
---
name: td-agent
description: Pick between Q-learning, SARSA, Expected SARSA for a tabular or small-feature RL task.
version: 1.0.0
phase: 9
lesson: 4
tags: [rl, td-learning, q-learning, sarsa]
---

Given a tabular or small-feature environment, output:

1. Algorithm. Q-learning / SARSA / Expected SARSA / n-step variant. One-sentence reason tied to on-policy vs off-policy and variance.
2. Hyperparameters. α, γ, ε, decay schedule.
3. Initialization. Q_0 value (optimistic vs zero) and justification.
4. Convergence diagnostic. Target learning curve, `|Q - Q*|` check if DP is possible.
5. Deployment caveat. How will exploration behave at inference? Is SARSA's conservatism needed?

Refuse to apply tabular TD to state spaces > 10⁶. Refuse to ship a Q-learning agent without a max-bias caveat. Flag any agent trained with ε held at 1.0 throughout (no exploitation phase).تمرینها
- ساده. الگوریتمهای Q-learning و SARSA را روی محیط 4×4 GridWorld پیاده کنید. منحنیهای یادگیری (میانگین بازدهی به ازای هر 100 اپیزود) را در طول 2000 اپیزود رسم کنید. کدامیک زودتر همگرا میشود؟
- متوسط. یک محیط حرکت روی لبهی پرتگاه بسازید (ابعاد 4×12 که در آن خانههای سطر آخر پرتگاه هستند، ورود به آنها پاداش 100- دارد و ایجنت را به نقطهی شروع برمیگرداند). خطمشیهای نهایی Q-learning و SARSA را مقایسه کنید. از مسیرهایی که هر کدام طی میکنند تصویر بگیرید. کدام مسیر فاصلهی کمتری تا پرتگاه دارد؟
- سخت. الگوریتم Double Q-learning را پیادهسازی کنید. در محیط GridWorld با پاداش نویزی (نویز گوسی که به پاداش هر گام اضافه میشود)، نشان دهید که Q-learning مقدار را بهشکل محسوسی بیش از حد برآورد میکند، در حالی که Double Q-learning چنین خطایی ندارد.
اصطلاحات کلیدی
| اصطلاح | در گفتار روزمره | مفهوم فنی و دقیق |
|---|---|---|
| خطای تفاوت زمانی (TD error) | «سیگنال بهروزرسانی» | ، خطای باقیماندهی حاصل از بوتاسترپ. |
| روش TD(0) | «روش TD تکگام» | بهروزرسانی بعد از هر انتقال، صرفاً با استفاده از تخمین حالت بعدی. |
| الگوریتم Q-learning | «الفبای RL خارج از خطمشی» | بهروزرسانی TD با عملگر max روی اکشنهای حالت بعدی؛ فارغ از خطمشی رفتاری، را میآموزد. |
| الگوریتم SARSA | «نسخهی درون خطمشی Q-learning» | بهروزرسانی TD با اکشن واقعی بعدی؛ تابع را برای خطمشی ε-greedy فعلی یاد میگیرد. |
| الگوریتم Expected SARSA | «همان SARSA با واریانس پایین» | جایگزینی نمونهی تصادفی با امید ریاضی آن تحت π. |
| مفهوم GLIE | «زمانبندی اصولی برای کاوش» | حریصانه در بینهایت همراه با کاوش نامحدود (Greedy in the Limit with Infinite Exploration)؛ شرط لازم برای همگرایی Q-learning. |
| بوتاسترپ (Bootstrapping) | «استفاده از تخمین فعلی در مقدار هدف» | تفاوت بنیادی TD و مونتکارلو؛ منشأ ایجاد تورش، اما عامل اصلی کاهش واریانس (Variance reduction) چشمگیر. |
| تورش بیشینهسازی (Maximization bias) | «بیشبرآوردی در Q-learning» | عملگر max روی تخمینهای نویزی تورش رو به بالا دارد؛ این مشکل با Double Q-learning حل میشود. |
برای مطالعهی بیشتر
- واتکینز و دایان (1992). Q-learning — مقالهی مرجع و اثبات همگرایی این الگوریتم.
- ساتون و بارتو (2018). فصل 6 — یادگیری تفاوت زمانی — پوشش TD(0)، SARSA، Q-learning و Expected SARSA.
- هسلت (2010). Double Q-learning — ارائهی راهکاری برای رفع مشکل تورش بیشینهسازی.
- سیین، هسلت، وایتسون، ویرینگ (2009). تحلیل نظری و تجربی Expected SARSA — انگیزهها و مبانی الگوریتم Expected SARSA.
- رامری و نیرانجان (1994). Q-learning آنلاین با سیستمهای پیوندگرا — مقالهای که اصطلاح SARSA را پایهگذاری کرد (آن زمان "modified connectionist Q-learning" نامیده میشد).
- ساتون و بارتو (2018). فصل 7 — بوتاسترپ چندگامه (n-step Bootstrapping) — تعمیم TD(0) به TD(n)؛ مسیری که از Q-learning به ردهای شایستگی (Eligibility traces) و در ادامه به GAE در الگوریتم PPO منتهی میشود.