
در روشهای مرسوم یادگیری تقویتی مثل Q-learning، تمرکز روی تخمین تابع ارزش است و تصمیمها با انتخاب بیشینهی ارزش اتخاذ میشوند. اما وقتی با فضاهای پیوسته روبهرو هستید یا نیاز به سیاستی تصادفی دارید، این فرمولبندی به بنبست میخورد. گرادیان سیاست (Policy Gradient) این محدودیت را با پارامتریسازی مستقیم خودِ سیاست و بهینهسازی آن با صعود گرادیانی حل میکند.
الگوریتم REINFORCE نقطهی آغاز این مسیر است؛ زیربنای ریاضیاتی تمام روشهای مدرن ترازسازی مدلهای زبانی مانند PPO، GRPO و DPO بر همین قضیه استوار است. درک شهودی و پیادهسازی این الگوریتم از صفر به شما کمک میکند سازوکار واقعی حلقههای یادگیری تقویتی در LLMها را از پشت صحنه کدهای آماده عمیقاً بشناسید.
برای اجرای کدهای این درس و آزمایش آن روی محیطهای پایهای نیازی به سرورهای ابری گرانقیمت یا پردازندههای گرافیکی خارجی نیست؛ تمام پیادهسازیها و شبیهسازیها بهراحتی روی CPU سیستم شخصی شما اجرا میشوند.
تخمین ارزش را کنار بگذارید. سیاست (policy) را مستقیماً پارامتری کنید، گرادیان بازده مورد انتظار را به دست آورید و در جهت صعود گام بردارید. ویلیامز (1992) این ایده را در قالب یک قضیه فرمولبندی کرد؛ همان بنیانی که PPO، GRPO و تمام حلقههای یادگیری تقویتی در مدلهای زبانی بزرگ (LLM) بر پایهی آن وجود دارند.
صورت مسئله
روشهای Q-learning و DQN تابع ارزش (value) را پارامتری میکنند و اکشنها با argmax Q انتخاب میشوند. این رویکرد برای اکشنها و حالتهای گسسته خوب جواب میدهد؛ اما وقتی اکشنها پیوسته باشند (چطور روی گشتاور در یک فضای 10 بعدی argmax بگیریم؟) یا وقتی سیاستی تصادفی (stochastic) بخواهید (argmax بر حسب ساختار همواره قطعی است)، کارایی خود را از دست میدهد.
در مقابل، گرادیانهای سیاست مستقیماً خودِ سیاست را پارامتری میکنند. یک شبکهی عصبی است که توزیعی روی اکشنها تولید میکند. برای عمل کردن، از همین توزیع نمونه برمیدارید؛ سپس گرادیان بازده مورد انتظار را نسبت به حساب کرده و در جهت صعود گام برمیدارید. دیگر نه خبری از argmax است و نه رابطهی بازگشتی بلمن (Bellman recursion)؛ فقط صعود گرادیانی روی .
قضیهی REINFORCE (ویلیامز 1992) نشان میدهد که این گرادیان قابل محاسبه است: . یک اپیزود اجرا کنید، بازده را به دست آورید، آن را در هر گام در ضرب کنید، میانگین بگیرید و با صعود گرادیانی پیش بروید؛ کار تمام است.
تمام الگوریتمهای RL برای LLMها در سال 2026 — مثل PPO، DPO و GRPO — نسخههای بهبودیافتهی REINFORCE هستند. تسلط کامل و عملی بر این مفهوم، پیشنیاز ادامهی این فاز و همچنین درس 07 فاز 10 (پیادهسازی RLHF) و درس 08 فاز 10 (DPO) است.
مفاهیم پایه
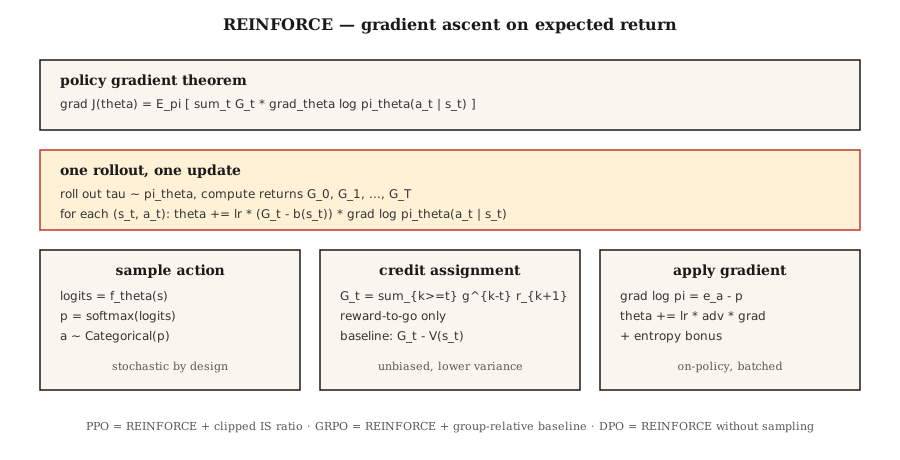
قضیهی گرادیان سیاست. به ازای هر سیاست که با پارامتری شده باشد:
که در آن بازده تنزیلشده از گام است. امید ریاضی روی مسیرهای کامل (trajectories) یعنی گرفته میشود که از نمونهبرداری شدهاند.
اثبات آن کوتاه است. از زیر نماد امید ریاضی مشتق بگیرید. از ترفند مشتق لگاریتم (log-derivative trick) یعنی استفاده کنید. را فاکتور بگیرید. جملات مربوط به محیط حذف میشوند. با دو خط محاسبات جبری ساده به قضیه میرسید.
ترفندهای کاهش واریانس. الگوریتم پایهی REINFORCE واریانس بسیار بالایی دارد؛ بازدهها نویزی هستند، نویزی است و حاصلضرب آنها به شدت نویز دارد. دو راهکار استاندارد برای این مشکل وجود دارد:
- تفریق خط مبنا (Baseline). جایگزین کردن با به ازای هر خط مبنای که به وابسته نباشد. این تغییر نااریب است، چون . انتخاب معمول: که توسط منتقد (critic) یاد گرفته میشود ← روشهای بازیگر-منتقد (Actor-Critic) در درس 07.
- پاداش باقیمانده (Reward-to-go). جایگزین کردن با . برای یک اکشن مشخص، فقط بازدههای آینده اهمیت دارند؛ پاداشهای گذشته نویزی با میانگین صفر وارد محاسبات میکنند.
با ترکیب این دو مورد، به این رابطه میرسید:
این همان الگوریتم REINFORCE با خط مبنا است؛ جد مستقیم A2C (درس 07) و PPO (درس 08).
پارامتریسازی سیاست با سافتمکس. برای اکشنهای گسسته، انتخاب استاندارد به این صورت است:
که در آن هر شبکهی عصبی دلخواهی است که به ازای هر اکشن یک امتیاز خروجی میدهد. گرادیان فرم بسیار تمیزی دارد:
یعنی امتیاز اکشن انتخابشده منهای مقدار مورد انتظار آن تحت سیاست فعلی.
سیاست گاوسی برای اکشنهای پیوسته. . عبارت فرم بسته (closed-form) دارد؛ و این دقیقاً تمام چیزی است که SAC در درس 07 فاز 9 به آن نیاز دارد.
پیادهسازی
گام 1: شبکهی سیاست سافتمکس
def policy_logits(theta, state_features):
    return [dot(theta[a], state_features) for a in range(N_ACTIONS)]

def softmax(logits):
    m = max(logits)
    exps = [exp(l - m) for l in logits]
    Z = sum(exps)
    return [e / Z for e in exps]
برای یک محیط جدولی (tabular) از یک سیاست خطی (یک بردار وزن به ازای هر اکشن) استفاده کنید. برای بازیهای Atari، به جای آن یک CNN بگذارید و سرِ (head) سافتمکس را دستنخورده نگه دارید.
گام 2: نمونهبرداری و محاسبهی لگاریتم احتمال
def sample_action(probs, rng):
    x = rng.random()
    cum = 0
    for a, p in enumerate(probs):
        cum += p
        if x <= cum:
            return a
    return len(probs) - 1

def log_prob(probs, a):
    return log(probs[a] + 1e-12)
گام 3: اجرای Rollout همراه با ثبت لگاریتم احتمالات
def rollout(theta, env, rng, gamma):
    trajectory = []
    s = env.reset()
    while not done:
        logits = policy_logits(theta, s)
        probs = softmax(logits)
        a = sample_action(probs, rng)
        s_next, r, done = env.step(s, a)
        trajectory.append((s, a, r, probs))
        s = s_next
    return trajectory
گام 4: بهروزرسانی با REINFORCE
def reinforce_step(theta, trajectory, gamma, lr, baseline=0.0):
    returns = compute_returns(trajectory, gamma)
    for (s, a, _, probs), G in zip(trajectory, returns):
        advantage = G - baseline
        grad_log_pi_a = [-p for p in probs]
        grad_log_pi_a[a] += 1.0
        for i in range(N_ACTIONS):
            for j in range(len(s)):
                theta[i][j] += lr * advantage * grad_log_pi_a[i] * s[j]
گرادیان (بردار one-hot اکشن منهای احتمالات) هستهی اصلی گرادیانهای سیاست سافتمکس است. این فرمول را در حافظهی عضلانی خود حک کنید.
گام 5: خطوط مبنا
میانگین متحرک روی اپیزودهای اخیر، کاهش واریانس کافی را برای حل یک محیط GridWorld ابعاد 4×4 فراهم میکند؛ این محیط پس از حدود 500 اپیزود همگرا میشود. اگر خط مبنا را به یک مدل یادگیرندهی ارتقا دهید، الگوریتم بازیگر-منتقد حاصل میشود.
چالشها و دامها
- انفجار گرادیان (Exploding gradients). بازدهها ممکن است بسیار بزرگ شوند. همیشه پیش از ضرب در ، مقدار را در سطح کل بچ (batch) به فرم
~N(0, 1)نرمالسازی کنید. - فروپاشی آنتروپی (Entropy collapse). سیاست خیلی زود به سمت اکشنی نزدیک به قطعی همگرا میشود، اکتشاف متوقف خواهد شد و مدل در جا میزند. راهحل: افزودن جریمهی آنتروپی (entropy bonus) یعنی به تابع هدف.
- واریانس بالا. الگوریتم پایهی REINFORCE به هزاران اپیزود نیاز دارد. خط مبنای منتقد (درس 07) یا ناحیهی اعتماد در TRPO/PPO (درس 08) راهکارهای استاندارد این مشکل هستند.
- ناکارآمدی در مصرف نمونه (Sample inefficiency). همسیاست بودن (On-policy) یعنی پس از یک بار بهروزرسانی، باید تمام ترنزیشنهای جمعآوریشده را دور بریزید. اصلاحات ناهمسیاست (Off-policy) با نمونهبرداری اهمیتی (importance sampling)، امکان استفادهی مجدد از دادهها را به قیمت افزایش واریانس فراهم میکنند (نسبت استفادهشده در PPO در واقع وزن نمونهبرداری اهمیتیِ برشخورده یا clipped است).
- گرادیانهای غیرایستا (Non-stationary gradients). گرادیانی که 100 اپیزود قبل محاسبه شده از قدیمی استفاده میکند. به همین دلیل روشهای همسیاست، مدل را هر چند rollout یک بار بهروزرسانی میکنند.
- تخصیص اعتبار (Credit assignment). بدون استفاده از پاداش باقیمانده، پاداشهای گذشته فقط نویز به همراه دارند. همیشه از پاداش باقیمانده استفاده کنید.
کاربردهای واقعی
در سال 2026، الگوریتم REINFORCE بهندرت مستقیماً اجرا میشود، اما فرمول گرادیان آن همهجا حضور دارد:
| کاربرد | روش مشتقشده |
|---|---|
| کنترل پیوسته | PPO / SAC با سیاست گاوسی |
| آموزش RLHF برای LLM | PPO با جریمهی KL، روی سیاست در سطح توکن |
| استدلال در LLMها (DeepSeek) | GRPO — الگوریتم REINFORCE با خط مبنای نسبی گروهی، بدون منتقد |
| سیستمهای چندایجنت | REINFORCE با منتقد متمرکز (MADDPG، COMA) |
| رباتیک با اکشنهای گسسته | A2C، A3C، PPO |
| سناریوهای صرفاً مبتنی بر ترجیحات | DPO — بازنویسی REINFORCE بهصورت تابع زیان (loss) درستنمایی ترجیحات، بدون نیاز به نمونهبرداری |
وقتی در اسکریپتهای آموزشی سال 2026 خط کدی مثل loss = -advantage * log_prob میبینید، در واقع همان REINFORCE با خط مبنا است. مقالات کاملی (مانند DPO، GRPO، RLOO) صرفاً ترفندهایی برای کاهش واریانس روی همین یک خط کد هستند.
ارائهی خروجی
کد را در مسیر outputs/skill-policy-gradient-trainer.md ذخیره کنید:
---
name: policy-gradient-trainer
description: Produce a REINFORCE / actor-critic / PPO training config for a given task and diagnose variance issues.
version: 1.0.0
phase: 9
lesson: 6
tags: [rl, policy-gradient, reinforce]
---

Given an environment (discrete / continuous actions, horizon, reward stats), output:

1. Policy head. Softmax (discrete) or Gaussian (continuous) with parameter counts.
2. Baseline. None (vanilla), running mean, learned `V̂(s)`, or A2C critic.
3. Variance controls. Reward-to-go on by default, return normalization, gradient clip value.
4. Entropy bonus. Coefficient β and decay schedule.
5. Batch size. Episodes per update; on-policy data freshness contract.

Refuse REINFORCE-no-baseline on horizons > 500 steps. Refuse continuous-action control with a softmax head. Flag any run with `β = 0` and observed policy entropy < 0.1 as entropy-collapsed.تمرینها
- ساده. الگوریتم REINFORCE را روی محیط 4×4 GridWorld با یک سیاست خطی سافتمکس پیادهسازی کنید. مدل را برای 1,000 اپیزود بدون خط مبنا آموزش دهید. منحنی یادگیری (learning curve) را رسم کنید و واریانس (انحراف معیار بازدهها) را بسنجید.
- متوسط. یک خط مبنای میانگین متحرک اضافه کنید و دوباره آموزش را اجرا کنید. بهرهوری نمونهها و واریانس را با حالت پایه مقایسه کنید. خط مبنا تعداد گامهای لازم برای همگرایی را چقدر کاهش میدهد؟
- سخت. جریمهی آنتروپی را اضافه کنید. پارامتر را جستجو (sweep) کنید. بازده نهایی و آنتروپی سیاست را رسم کرده و نقطهی تعادل بهینهی این مسئله را پیدا کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| گرادیان سیاست (Policy gradient) | «آموزش مستقیم سیاست» | ؛ بهدستآمده از ترفند مشتق لگاریتم. |
| REINFORCE | «الگوریتم اولیهی PG» | اثر ویلیامز (1992)؛ بازدههای مونتکارلو ضربدر گرادیان لگاریتمِ سیاست. |
| ترفند مشتق لگاریتم (Log-derivative trick) | «برآوردگر تابع امتیاز» | ؛ گرادیانگیری از امید ریاضی را ممکن میکند. |
| خط مبنا (Baseline) | «کاهش واریانس» | هر که از کم شود؛ نااریب است چون . |
| پاداش باقیمانده (Reward-to-go) | «فقط بازدههای آینده حساب میشوند» | استفاده از به جای کل ؛ فرمولی صحیح با واریانس کمتر. |
| جریمهی آنتروپی (Entropy bonus) | «تشویق به اکتشاف» | عبارت که مانع از فروپاشی سیاست میشود. |
| همسیاست (On-policy) | «آموزش روی دادههای هماکنون» | امید ریاضی گرادیان نسبت به سیاست فعلی است؛ نمیتوان دادههای قدیمی را مستقیماً بازاستفاده کرد. |
| مزیت (Advantage) | «چقدر بهتر از حد میانگین» | ؛ کمیت علامتداری که در REINFORCE با خط مبنا ضرب میشود. |
برای مطالعهی بیشتر
- Williams (1992). Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning — مقالهی اصلی الگوریتم REINFORCE.
- Sutton et al. (2000). Policy Gradient Methods for Reinforcement Learning with Function Approximation — قضیهی مدرن گرادیان سیاست با تقریب تابع.
- Sutton & Barto (2018). Ch. 13 — Policy Gradient Methods — ارائهی استاندارد و درسی این مبحث.
- OpenAI Spinning Up — VPG / REINFORCE — توضیحی شفاف و آموزشی به همراه کدهای PyTorch.
- Peters & Schaal (2008). Reinforcement Learning of Motor Skills with Policy Gradients — کاهش واریانس و دیدگاه گرادیان طبیعی که REINFORCE را به خانوادهی ناحیهی اعتماد (TRPO، PPO) متصل میکند.