
در الگوریتمهای سنتی مبتنی بر گرادیان خطمشی (Policy Gradient) مانند A2C، هر دسته از دادههای جمعآوریشده از تعامل با محیط (Rollout) بلافاصله پس از یک گام بهروزرسانی دور ریخته میشود. از آنجا که تعامل با محیطهای شبیهسازی یا تولید پاسخ در مدلهای زبانی فرآیندی پرهزینه و زمانبر است، هدر رفتن این دادهها بازدهی نمونهها را به شدت پایین میآورد و منابع پردازشی زیادی مصرف میکند.
الگوریتم بهینهسازی خطمشی نزدیک (Proximal Policy Optimization یا PPO) این مشکل اساسی را با ایدهای هوشمندانه حل میکند: تعریف یک تابع هدف برشخورده (Clipped Surrogate Objective) که از تغییرات ناگهانی و انفجار خطمشی جلوگیری میکند. با این ترفند، میتوانید چندین دورهی آموزشی (Epoch) را روی دادههای یکسان اجرا کنید، بدون اینکه پایداری آموزش به خطر بیفتد.
امروزه PPO استاندارد اصلی یادگیری تقویتی در رباتیک، بازیهای پیچیده و پایپلاینهای همترازی مدلهای زبانی با بازخورد انسانی (RLHF) است. پیادهسازیهای پایه و آزمایشهای این درس روی محیطهای ساده با پردازندههای معمولی (CPU) یا شتابدهندههای سیستمهای شخصی قابل اجرا هستند و نیازی به زیرساختهای ابری سنگین ندارند.
الگوریتم A2C دادههای حاصل از اجرای هر دور (rollout) را پس از یک بار بهروزرسانی دور میریزد. در مقابل، PPO گرادیان خطمشی (policy gradient) را داخل یک نسبت اهمیت برشخورده (clipped importance ratio) قرار میدهد تا بتوانید بدون انفجار خطمشی، بیش از 10 دورهی آموزشی (epoch) را روی همان دادهها اجرا کنید؛ شولمن و همکاران (2017). این روش در سال 2026 همچنان الگوریتم پیشفرض گرادیان خطمشی به شمار میرود.
صورت مسئله
الگوریتم A2C (درس 07) یک روش درونخطمشی (on-policy) است: گرادیان به دادههایی نیاز دارد که از خطمشی فعلی، یعنی نمونهبرداری شده باشند. با یک بار بهروزرسانی، تغییر میکند و دادههایی که استفاده کردهاید، برونخطمشی (off-policy) میشوند. اگر دوباره از آنها استفاده کنید، گرادیان شما اریب خواهد شد.
جمعآوری دادهها هزینه دارد. در محیطهای Atari، اجرای یک دور در 8 محیط موازی × 128 گام، برابر با 1024 گذار و دهها ثانیه زمان در محیط بازی است. دور ریختن این همه داده فقط پس از یک گام گرادیان، به شدت اسرافآمیز است.
بهینهسازی خطمشی ناحیه اعتماد (TRPO، شولمن 2015) اولین راهحل این مشکل بود: هر بهروزرسانی را طوری محدود کنید که واگرایی کولبک-لایبلر (KL Divergence) بین خطمشی قدیم و جدید زیر بماند. از نظر تئوری ساختار تمیزی دارد، اما برای هر بهروزرسانی نیاز به حل گرادیان مزدوج (conjugate gradient) دارد. در سال 2026 دیگر هیچکس TRPO اجرا نمیکند.
الگوریتم PPO (شولمن و همکاران، 2017) آن قید سختِ ناحیهی اعتماد را با یک تابع هدف برشخوردهی ساده جایگزین میکند؛ تنها با یک خط کد بیشتر، ده دورهی آموزشی به ازای هر سری داده، بدون نیاز به گرادیان مزدوج و با تضمینهای تئوری کاملاً رضایتبخش. بعد از گذشت نه سال، این روش هنوز هم الگوریتم پیشفرض گرادیان خطمشی برای هر کاری، از MuJoCo گرفته تا RLHF است.
مفاهیم کلیدی
نسبت اهمیت.
این عبارت، نسبت درستنمایی (likelihood ratio) خطمشی جدید به خطمشی جمعآوریکنندهی دادهها است. مقدار یعنی هیچ تغییری رخ نداده است. مقدار یعنی احتمال انتخاب عمل در خطمشی جدید، دو برابر خطمشی قبلی است.
تابع هدف جانشینِ برشخورده.
این فرمول دو بخش دارد:
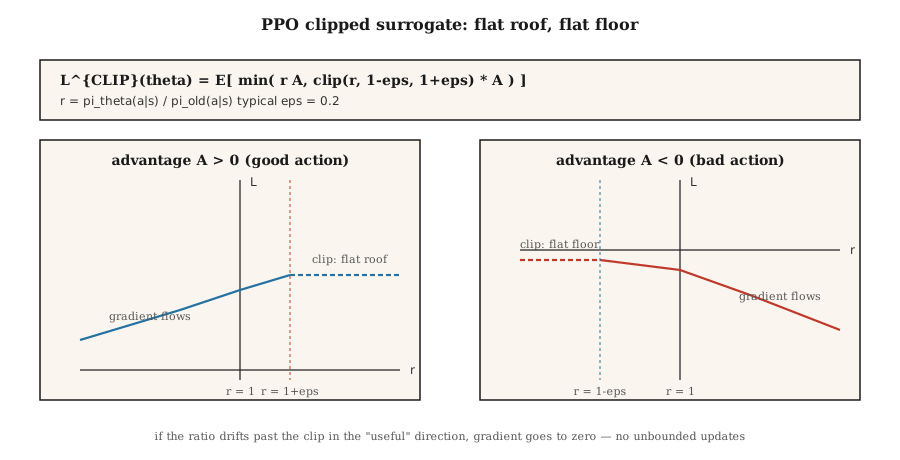
- اگر مزیت مثبت باشد () و نسبت بخواهد از فراتر رود، برش (clip) گرادیان را صاف و صفر میکند؛ یعنی احتمال انجام یک عمل خوب را بیش از بالاتر از احتمال قبلیاش نبرید.
- اگر مزیت منفی باشد () و نسبت بخواهد به زیر سقوط کند (یعنی بخواهیم احتمال یک عمل بد را بسیار کمتر از خطمشی قبلی کنیم)، برش گرادیان را صاف میکند: احتمال یک عمل بد را بیش از پایینتر از احتمال قبلیاش نبرید.
عملگر min جهت دیگر را کنترل میکند: اگر تغییرات نسبت در جهتی سودمند حرکت کرده باشد، همچنان گرادیان را دریافت میکنید (هیچ برشی در سمتی که به نفع شما باشد اعمال نمیشود).
معمولاً مقدار در نظر گرفته میشود. اگر نمودار تابع هدف را برحسب رسم کنید، یک تابع خطی تکهتکه با یک سقف مسطح در «سمت خوب» و یک کف مسطح در «سمت بد» خواهید داشت.
تابع زیان (loss) کامل PPO.
همان ساختار اکتور-کریتیکِ درس A2C در اینجا نیز برقرار است؛ با سه ضریب که معمولاً مقادیر آنها ، و است.
حلقهی آموزش.
- جمعآوری گذار در محیط موازی، هر کدام به اندازهی گام.
- محاسبهی مزیتها (GAE) و فریز کردن آنها به عنوان مقادیر ثابت.
- فریز کردن به عنوان یک اسنپشات (snapshot) از فعلی.
- به ازای دورهی آموزشی، برای هر مینیبچ از
(s, a, A, V_target, log π_old(a|s)):- محاسبهی .
- اِعمال + تابع زیانِ ارزش + آنتروپی.
- گام گرادیان.
- دور ریختن دادههای این دور و بازگشت به گام 1.
مقدار به همراه مینیبچهای 64تایی، اَبَرپارامترهای استاندارد این روش هستند. الگوریتم PPO مقاومت بالایی دارد و تغییر جزئی این اعداد در بازهی 50± درصد بهندرت اثری جدی میگذارد.
نسخهی جریمهی KL. مقالهی اصلی روش دیگری هم با استفاده از جریمهی تطبیقی KL پیشنهاد داد: که در آن بر اساس مقدار مشاهدهشدهی KL تنظیم میشود. در عمل نسخهی مبتنی بر برش به گزینهی غالب تبدیل شد؛ اما نسخهی KL همچنان در RLHF زنده است (جایی که مهار انحراف KL نسبت به مدل مرجع، در هر صورت یک قید پیشفرض و همیشگی است).
پیادهسازی
گام 1: ثبت log π_old(a | s) در زمان جمعآوری دادهها
for step in range(T):
    probs = softmax(logits(theta, state_features(s)))
    a = sample(probs, rng)
    s_next, r, done = env.step(s, a)
    buffer.append({
        "s": s, "a": a, "r": r, "done": done,
        "v_old": value(w, state_features(s)),
        "log_pi_old": log(probs[a] + 1e-12),
    })
    s = s_next
این اسنپشات فقط یک بار در زمان جمعآوری دادهها ثبت میشود و در طول دورههای آموزشیِ بهروزرسانی تغییری نمیکند.
گام 2: محاسبهی مزیتهای GAE (درس 07)
دقیقاً مشابه A2C عمل کرده و مقادیر را در کل بچ نرمالسازی کنید.
گام 3: بهروزرسانی با تابع جانشین برشخورده
for _ in range(K_EPOCHS):
for mb in minibatches(buffer, size=64):
for rec in mb:
x = state_features(rec["s"])
probs = softmax(logits(theta, x))
logp = log(probs[rec["a"]] + 1e-12)
ratio = exp(logp - rec["log_pi_old"])
adv = rec["advantage"]
surrogate = min(
ratio * adv,
clamp(ratio, 1 - EPS, 1 + EPS) * adv,
)
# پسانتشار surrogate-، افزودن تابع زیان (loss) مقدار، کسر انتروپی
grad_logpi = onehot(rec["a"]) - probs
if (adv > 0 and ratio >= 1 + EPS) or (adv < 0 and ratio <= 1 - EPS):
pg_grad = 0.0 # clipped
else:
pg_grad = ratio * adv
for i in range(N_ACTIONS):
for j in range(N_FEAT):
theta[i][j] += LR * pg_grad * grad_logpi[i] * x[j]الگوی «برش → صفر شدن گرادیان» قلب تپندهی PPO است. اگر خطمشی جدید بیش از حد در جهت سودمند حرکت کرده باشد، بهروزرسانی متوقف میشود.
گام 4: ارزش و آنتروپی
مانند A2C، خطای استاندارد میانگین مربعات (MSE) را به هدف بخش نقاد (critic) اضافه کرده و یک ضریب تشویقی آنتروپی هم به بخش عملگر (actor) بدهید.
گام 5: ابزارهای تشخیصی
در هر بهروزرسانی، این سه معیار را زیر نظر بگیرید:
- میانگین KL : باید در بازهی
[0, 0.02]بماند. اگر از0.1فراتر رفت،K_EPOCHSیاLRرا کم کنید. - کسر برش (Clip fraction) — سهم نمونههایی که نسبت آنها بیرون از قرار میگیرد: این عدد باید حدود
0.1-0.3باشد. اگر نزدیک به0باشد، یعنی برش اصلاً فعال نمیشود؛ پسLRیاK_EPOCHSرا افزایش دهید. اگر به بالای0.5رسید، نشانهی بیشبرازش روی دادههای فعلی است و باید آنها را کاهش دهید. - واریانس تبیینشده (Explained variance) : معیاری برای کیفیت بخش نقاد است که همگام با یادگیری آن، باید به سمت عدد 1 بالا برود.
دامهای رایج
- تنظیم نبودن ضریب برش. مقدار استانداردِ جاافتادهی این حوزه است. کاهش آن به
0.1آپدیتها را بیش از حد محتاطانه میکند و افزایش آن به بالای0.3ناپایداری به بار میآورد. - دورههای آموزشی بیش از حد. مقدار معمولاً سیستم را ناپایدار میکند، چون خطمشی فاصلهی زیادی از میگیرد. تعداد دورهها را بهخصوص برای شبکههای بزرگ، محدود نگه دارید.
- عدم نرمالسازی پاداشها. مقیاسهای بزرگ پاداش، بازهی برش را بیاثر میکنند. پیش از محاسبهی مزیتها، پاداشها را با انحراف معیار متحرک (running std) نرمالسازی کنید.
- فراموش کردن نرمالسازی مزیت. استانداردِ کار این است که در هر بچ، میانگین را صفر و انحراف معیار را یک کنید. نادیده گرفتن این مرحله PPO را در اکثر بنچمارکها از کار میاندازد.
- کاهش ندادن نرخ یادگیری (Learning rate). کاهش خطی نرخ یادگیری تا صفر به بهبود عملکرد PPO کمک میکند؛ ثابت نگه داشتن آن اغلب عملکرد ضعیفتری رقم میزند.
- خطاهای محاسباتی در نسبت اهمیت. برای حفظ پایداری عددی (numerical stability)، همیشه از فرمول
exp(log_new - log_old)استفاده کنید، نهnew / old. - علامت اشتباه گرادیان. بیشینهسازی تابع هدف جانشین به معنی کمینهسازی است. وارونه زدن این علامت، رایجترین باگ پیادهسازی PPO به شمار میرود.
کاربردهای واقعی
در سال 2026، الگوریتم PPO انتخاب پیشفرض یادگیری تقویتی در گسترهی شگفتانگیزی از حوزهها است:
| کاربرد | گونهی PPO |
|---|---|
| MuJoCo / کنترل رباتیک | PPO با خطمشی گاوسی و GAE(0.95) |
| Atari / بازیهای گسسته | PPO با خطمشی طبقهبندیشده (categorical) و دورهای 128گامی پیوسته |
| آموزش RLHF برای مدلهای زبانی بزرگ | PPO با جریمهی KL نسبت به مدل مرجع، و محاسبهی پاداش از مدل پاداش در انتهای پاسخ |
| ایجنتهای بازی در مقیاس بزرگ | ترکیب IMPALA + PPO (مانند AlphaStar و OpenAI Five) |
| مدلهای زبانی استدلالگر | GRPO (درس 12) — گونهای از PPO بدون شبکهی نقاد |
| دادههای صرفاً ترجیحی | DPO — خلاصهسازی فرم بسته (closed-form) از PPO+KL بدون نمونهبرداری آنلاین |
ساختار تابع زیان (loss) در PPO — یعنی تابع جانشین برشخورده + ارزش + آنتروپی — اسکلت اصلی DPO، GRPO و تقریباً تمام پایپلاینهای (pipeline) RLHF است.
بستهبندی نهایی
این کد را با نام outputs/skill-ppo-trainer.md ذخیره کنید:
---
name: ppo-trainer
description: Produce a PPO training config and a diagnostic plan for a given environment.
version: 1.0.0
phase: 9
lesson: 8
tags: [rl, ppo, policy-gradient]
---

Given an environment and training budget, output:

1. Rollout size. `N` envs × `T` steps.
2. Update schedule. `K` epochs, minibatch size, LR schedule.
3. Surrogate params. `ε` (clip), `c_v`, `c_e`, advantage normalization on.
4. Advantage. GAE(`λ`) with explicit `γ` and `λ`.
5. Diagnostics plan. KL, clip fraction, explained variance thresholds with alerts.

Refuse `K > 30` or `ε > 0.3` (unsafe trust region). Refuse any PPO run without advantage normalization or KL/clip monitoring. Flag clip fraction sustained above 0.4 as drift.تمرینها
- ساده. الگوریتم PPO را روی محیط 4×4 GridWorld با اجرا کنید. بازدهی نمونهها (sample efficiency) را در گامهای محیطی یکسان با A2C (که در هر دور یک دورهی آموزشی دارد) مقایسه کنید.
- متوسط. مقادیر مختلف را ارزیابی کنید. نمودار بازدهی برحسب گامهای محیطی را رسم کرده و میانگین KL را در هر بهروزرسانی ردیابی کنید. مقدار KL در این مسئله در چه نقطهای از دچار انفجار میشود؟
- سخت. تابع جانشین برشخورده را با جریمهی تطبیقی KL جایگزین کنید (اگر بود، دو برابر شود و اگر بود، نصف شود). بازدهی نهایی، پایداری و روند آموزش بدون برش را مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| نسبت اهمیت (Importance ratio) | «r_t(θ)» | مقدار ؛ میزان انحراف از خطمشی جمعآوریکنندهی دادهها. |
| تابع جانشین برشخورده (Clipped surrogate) | «ترفند اصلی PPO» | فرمول ؛ صفر شدن گرادیان بعد از مرز برش در جهت سودمند. |
| ناحیه اعتماد (Trust region) | «نیت TRPO / PPO» | محدود کردن مقدار KL در هر بهروزرسانی برای تضمین بهبود یکنواخت. |
| جریمهی KL (KL penalty) | «ناحیه اعتماد نرم» | گونهی دیگر PPO با فرمول به همراه تطبیقی. |
| کسر برش (Clip fraction) | «میزان فعال شدن برش» | یک ابزار تشخیصی که باید بین 0.1 تا 0.3 باشد؛ خارج از این بازه یعنی تنظیمات اشتباه است. |
| آموزش چند دورهای (Multi-epoch training) | «استفادهی دوباره از دادهها» | اجرای K دورهی آموزشی روی هر دور داده؛ تبادل واریانس بیشتر در ازای بازدهی بالاتر نمونهها. |
| شبه درونخطمشی (On-policy-ish) | «تقریباً درونخطمشی» | PPO اسماً روشی درونخطمشی است، اما اجرای دورههای K>1 با امنیت بالا از دادههای اندکی برونخطمشی بهره میگیرد. |
| PPO-KL | «آن یکی PPO» | گونهی مبتنی بر جریمهی KL؛ کاربردی در RLHF که انحراف KL نسبت به مدل مرجع در هر صورت یک قید لازم است. |
برای مطالعهی بیشتر
- Schulman et al. (2017). Proximal Policy Optimization Algorithms — مقالهی اصلی.
- Schulman et al. (2015). Trust Region Policy Optimization — مقالهی TRPO، پیشنیاز PPO.
- Andrychowicz et al. (2021). What Matters In On-Policy RL? A Large-Scale Empirical Study — بررسی دقیق اثر تکتک اَبَرپارامترهای PPO.
- Ouyang et al. (2022). Training language models to follow instructions with human feedback — مقالهی InstructGPT و دستورالعمل استفاده از PPO در RLHF.
- OpenAI Spinning Up — PPO — ارائهای شفاف و مدرن با PyTorch.
- CleanRL PPO implementation — پیادهسازی مرجع و تکفایلی PPO، مورد استفاده در مقالات علمی پرتعداد.
- Hugging Face TRL — PPOTrainer — روش پیادهسازی عملیاتی PPO روی مدلهای زبانی؛ مطالعه در کنار درس 09 (RLHF).
- Engstrom et al. (2020). Implementation Matters in Deep Policy Gradients — مقالهی «37 بهینهسازی در سطح کد»؛ برای تشخیص این که کدام ترفندهای PPO واقعاً کلیدی هستند و کدام صرفاً باوری سنتی محسوب میشوند.