
روشهای سنتی و جدولی یادگیری تقویتی در مواجهه با محیطهای دنیای واقعی با شکست مواجه میشوند؛ فضاهای حالتی با ابعاد بالا، مانند فریمهای ویدیویی یا وضعیتهای پیچیدهی بازیها، امکان ذخیرهسازی مقادیر Q را در قالب جدول سلب میکنند. الگوریتم DQN (شبکههای کیو عمیق) نخستین معماری موفقی بود که توانست یادگیری تقویتی را با شبکههای عصبی عمیق پیوند بزند و تصمیمگیری هوشمند را مستقیماً از دادههای خام ممکن کند.
در نگاه اول، جایگزینی جدول با یک شبکهی عصبی ساده به نظر میرسد، اما در عمل با پدیدهای موسوم به «سهگانهی مرگبار» (deadly triad) روبهرو میشویم که آموزش را بهشدت ناپایدار و واگرا میکند. در این درس با سه ترفند کلیدی و تاریخساز مهندسی شامل بافر بازپخش تجربه، شبکه هدف و برش پاداش آشنا میشوید و یاد میگیرید چگونه این سازوکارها تقریب تابع را پایدار نگه میدارند.
پیادهسازی ارائهشده در این درس صرفاً با کتابخانهی استاندارد پایتون و بدون وابستگی به کتابخانههای سنگین انجام شده است؛ بنابراین برای اجرای کدها و درک عمیق محاسبات ریاضی و گرادیانها به کارتهای گرافیکی گرانقیمت یا سرویسهای ابری نیاز ندارید و همهچیز روی پردازندهی معمولی سیستم شخصی شما در کسری از ثانیه اجرا میشود.
سال 2013: Mnih یک شبکه Q-learning را مستقیماً روی پیکسلهای خام آموزش داد و تمام ایجنتهای سنتی یادگیری تقویتی را در هفت بازی آتاری شکست داد. سال 2015: این کار به 49 بازی گسترش یافت، در Nature چاپ شد و عصر یادگیری تقویتی عمیق (deep-RL) را رقم زد. الگوریتم DQN همان Q-learning بههمراه سه ترفند است که تقریب تابع را پایدار میکنند.
صورت مسئله
روش جدولی Q-learning برای هر جفت (حالت، اقدام) به یک مقدار Q مجزا نیاز دارد. صفحهی شطرنج حدود 10⁴³ حالت دارد. یک فریم آتاری با ابعاد 210×160×3 شامل 100,800 ویژگی است. روشهای جدولی یادگیری تقویتی در مواجهه با چند هزار حالت از کار میافتند، چه برسد به میلیاردها حالت.
راهحل بعد از کشفشدن بدیهی به نظر میرسد: جدول Q را با یک شبکه عصبی جایگزین کنید، یعنی . اما رسیدن به همین راهحلِ در ظاهر بدیهی دههها طول کشید. تقریب سادهانگارانهی تابع با Q-learning زیر بار «سهگانهی مرگبار» (deadly triad) واگرا میشود؛ یعنی ترکیبِ تقریب تابع + بوتاسترپ (bootstrapping) + یادگیری خارج از خطمشی (off-policy). منی و همکاران (2013، 2015) سه ترفند مهندسی برای پایدارسازی یادگیری ارائه دادند:
- بافر بازپخش تجربه (Experience replay): وابستگی متقابل میان گذارها (transitions) را از بین میبرد.
- شبکه هدف (Target network): هدفِ بوتاسترپ را ثابت نگه میدارد.
- برش پاداش (Reward clipping): اندازهی گرادیانها را نرمال میکند.
الگوریتم DQN روی آتاری نخستین باری بود که یک معماری واحد با یک مجموعه ابرپارامتر ثابت، دهها مسئلهی کنترلی را صرفاً بر اساس پیکسلهای خام حل کرد. هر پیشرفتی که از آن زمان در دنیای یادگیری تقویتی عمیق پدید آمده — مثل DDQN، Rainbow، Dueling، Distributional، R2D2 و Agent57 — روی پایهی همین سه ترفند بنا شده است.
مبانی نظری
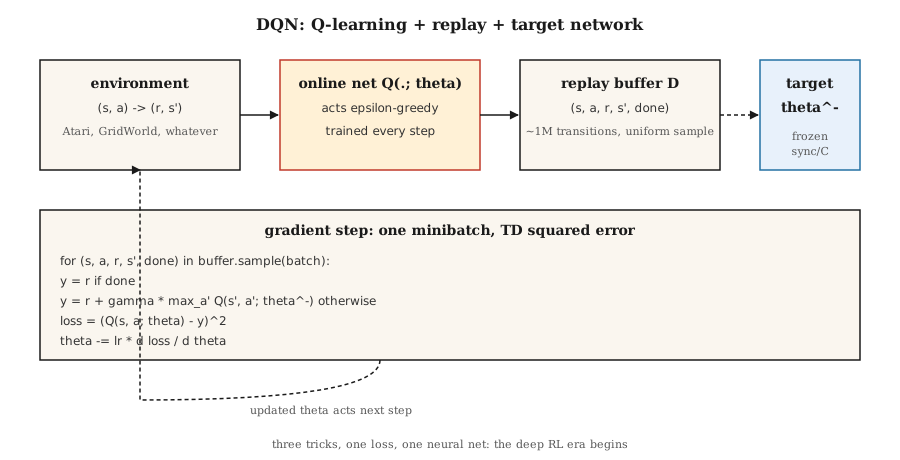
هدف. الگوریتم DQN تابع زیان (loss) تفاضل زمانی (TD) تکگامی را روی یک تابع Q عصبی به حداقل میرساند:
در اینجا شبکهی آنلاین است که در هر گام با گرادیان کاهشی (gradient descent) بهروزرسانی میشود. شبکهی هدف است که بهصورت دورهای از کپی میشود (حدوداً هر 10,000 گام). همچنین بافر بازپخش گذارهای گذشته است.
سه ترفند اصلی به ترتیب اهمیت:
بافر بازپخش تجربه. یک بافر حلقوی (ring buffer) با ظرفیت حدود ~10⁶ گذار. در هر گام آموزشی، یک مینیبچ بهصورت تصادفی و یکنواخت از آن نمونهبرداری میشود. این کار همبستگی زمانی را از بین میبرد (چون فریمهای متوالی تقریباً یکساناند)، به شبکه امکان میدهد از گذارهای نادری که پاداش دارند بارها یاد بگیرد، و وابستگی بهروزرسانیهای متوالی گرادیان را خنثی میکند. بدون این سازوکار، TD درونخطمشی (on-policy) با یک شبکه عصبی روی بازیهای آتاری واگرا میشود.
شبکه هدف. استفاده از یک شبکهی یکسان در هر دو طرف معادلهی بلمن باعث میشود هدف با هر بهروزرسانی تغییر کند — اصطلاحاً «دنبال دم خود دویدن». راهحل: شبکهی دومی به نام با وزنهای ثابت نگه دارید. هر گام یک بار، را کپی کنید. این کار هدف رگرسیون را برای هزاران گام گرادیان متوالی پایدار نگه میدارد. بهروزرسانیهای نرم (که در DDPG و SAC کاربرد دارند) نسخهای هموارتر از همین ایدهاند.
برش پاداش. مقدار پاداشها در بازیهای آتاری از 1 تا بیش از 1000 متغیر است. برش دادن این مقادیر در بازهی مانع از غلبهی یک بازی خاص بر گرادیان میشود. اگر بزرگی پاداش اهمیت داشته باشد این کار نادرست است؛ اما برای آتاری که فقط علامت مثبت یا منفی پاداش اهمیت دارد، کاملاً مناسب است.
الگوریتم Double DQN. هاسلت (2016) سوگیری بیشبرآوردی (maximization bias) را برطرف کرد: از شبکهی آنلاین برای انتخاب اقدام و از شبکهی هدف برای ارزیابی آن استفاده کنید.
این فرمول جایگزینی سرراست است که همیشه عملکرد بهتری دارد. بهصورت پیشفرض از آن استفاده کنید.
سایر بهبودها (Rainbow, 2017): بازپخش با اولویت (نمونهبرداری بیشتر از گذارهایی با خطای TD بالا)، معماری دوئلینگ (تفکیک سرهای و مزیت)، شبکههای نویزی (اکتشاف یادگرفتهشده)، بازدههای n-گامی، Q توزیعی (C51/QR-DQN) و بوتاسترپ چندگامی. هر کدام چند درصد بهبود ایجاد میکنند و مجموع دستاورد آنها تقریباً جمعپذیر است.
پیادهسازی
کد این بخش صرفاً با کتابخانهی استاندارد پایتون و بدون نیاز به numpy نوشته شده است — ما یک پرسپترون چندلایه (MLP) تکلایهی پنهان را بهصورت دستی روی یک محیط GridWorld پیوستهی کوچک پیاده کردهایم تا هر گام آموزش در چند میکروثانیه اجرا شود. منطق الگوریتم با DQN مقیاسبزرگ در بازیهای آتاری کاملاً یکسان است.
گام 1: بافر بازپخش
class ReplayBuffer:
    def __init__(self, capacity):
        self.buf = []
        self.capacity = capacity
    def push(self, s, a, r, s_next, done):
        if len(self.buf) == self.capacity:
            self.buf.pop(0)
        self.buf.append((s, a, r, s_next, done))
    def sample(self, batch, rng):
        return rng.sample(self.buf, batch)
ظرفیت بافر در آتاری حدود 10⁶ گذار است، درست مانند نسخهی اصلی DQN (که پیش از شروع یادگیری، 50,000 گذار جمعآوری میکند)؛ اما برای محیط سادهی ما 5,000 گذار کفایت میکند.
گام 2: یک شبکهی Q کوچک (MLP دستی)
class QNet:
    def __init__(self, n_in, n_hidden, n_actions, rng):
        self.W1 = [[rng.gauss(0, 0.3) for _ in range(n_in)] for _ in range(n_hidden)]
        self.b1 = [0.0] * n_hidden
        self.W2 = [[rng.gauss(0, 0.3) for _ in range(n_hidden)] for _ in range(n_actions)]
        self.b2 = [0.0] * n_actions
    def forward(self, x):
        h = [max(0.0, sum(w * xi for w, xi in zip(row, x)) + b) for row, b in zip(self.W1, self.b1)]
        q = [sum(w * hi for w, hi in zip(row, h)) + b for row, b in zip(self.W2, self.b2)]
        return q, h
گذر رو به جلو (forward pass): خطی ← ReLU ← خطی. کل شبکه همین است.
گام 3: بهروزرسانی DQN
def train_step(online, target, batch, gamma, lr):
    grads = zeros_like(online)
    for s, a, r, s_next, done in batch:
        q, h = online.forward(s)
        if done:
            y = r
        else:
            q_next, _ = target.forward(s_next)
            y = r + gamma * max(q_next)
        td_error = q[a] - y
        accumulate_grads(grads, online, s, h, a, td_error)
    apply_sgd(online, grads, lr / len(batch))
ساختار کلی همان Q-learning درس 04 است، با دو تفاوت: (الف) بهجای دسترسی مبتنی بر اندیس به جدول، پسانتشار (backpropagation) را روی یک تابع مشتقپذیر انجام میدهیم، (ب) در محاسبهی هدف از استفاده میشود.
گام 4: حلقهی بیرونی
در هر اپیزود، طبق خطمشی ε-حریصانه روی عمل کنید، گذارها را درون بافر push کنید، یک مینیبچ نمونه بگیرید، یک گام گرادیان بردارید و بهصورت دورهای را همگامسازی کنید. الگو به این صورت است:
for episode in range(N):
    s = env.reset()
    while not done:
        a = epsilon_greedy(online, s, epsilon)
        s_next, r, done = env.step(s, a)
        buffer.push(s, a, r, s_next, done)
        if len(buffer) >= batch:
            train_step(online, target, buffer.sample(batch), gamma, lr)
        if steps % sync_every == 0:
            target = copy(online)
        s = s_next
روی محیط GridWorld کوچک ما با حالت 16بُعدی one-hot، ایجنت در حدود 500 اپیزود به خطمشی نزدیک به بهینه میرسد. در آتاری، همین فرایند به 200 میلیون فریم گسترش مییابد و یک شبکه عصبی پیچشی (CNN) برای استخراج ویژگی به آن اضافه میشود.
دامهای رایج
- سهگانهی مرگبار. تقریب تابع + یادگیری خارج از خطمشی + بوتاسترپ میتواند باعث واگرایی شود. DQN این مشکل را با شبکهی هدف + بافر بازپخش مهار میکند؛ هیچکدام را حذف نکنید.
- اکتشاف (Exploration). پارامتر ε باید افت کند، معمولاً از 1.0 به 0.01 در طول 10٪ اول آموزش. بدون اکتشاف اولیهی کافی، شبکهی Q در یک کمینهی محلی به دام میافتد.
- بیشبرآوردی. عملگر
maxروی مقادیر نویزی Q، سوگیری رو به بالا ایجاد میکند. در محیطهای عملیاتی همیشه از Double DQN استفاده کنید. - مقیاس پاداش. پاداشها را برش دهید یا نرمال کنید؛ بزرگی گرادیان متناسب با بزرگی پاداش است.
- شروع سرد بافر بازپخش. تا زمانی که بافر چند هزار گذار دریافت نکرده، آموزش را شروع نکنید. گرادیانهای اولیه روی حدود 20 نمونه منجر به بیشبرازش (overfitting) میشوند.
- بسامد همگامسازی شبکهی هدف. فاصلهی خیلی کم یعنی عملاً نداشتن شبکهی هدف؛ فاصلهی خیلی زیاد هم اهداف را کهنه میکند. DQN آتاری از 10,000 گام محیط استفاده میکند. یک قاعدهی تجربی: همگامسازی را تقریباً هر 1/100 از کل افق آموزش انجام دهید.
- پیشپردازش مشاهدات. در DQN آتاری، 4 فریم روی هم چیده میشوند (stack) تا حالت خاصیت مارکوف پیدا کند. هر محیطی با اطلاعات سرعت به چیدن فریمها روی هم یا حالت بازگشتی (recurrent) نیاز دارد.
کاربردها
در سال 2026، الگوریتم DQN بهندرت بهترین گزینهی موجود (state-of-the-art) به شمار میرود، اما همچنان الگوریتم مرجع یادگیری خارج از خطمشی است:
| وظیفه | روش انتخابی | چرا DQN نه؟ |
|---|---|---|
| اقدامات گسسته شبیه آتاری | Rainbow DQN یا Muesli | همان چارچوب است، اما با ترفندهای بیشتر. |
| کنترل پیوسته | SAC / TD3 (فاز 9 · 07) | الگوریتم DQN شبکهی خطمشی ندارد. |
| درونخطمشی / نرخ پردازش بالا | PPO (فاز 9 · 08) | بافر بازپخش ندارد؛ مقیاسپذیریاش راحتتر است. |
| یادگیری تقویتی آفلاین | CQL / IQL / Decision Transformer | اهداف Q محافظهکارانه دارد و با انفجارهای ناشی از بوتاسترپ روبهرو نمیشود. |
| فضاهای اکشن گسستهی بزرگ (سیستمهای توصیهگر) | DQN همراه با امبدینگ اکشن، یا IMPALA | جواب میدهد؛ جزئیات پیادهسازی اهمیت دارد. |
| یادگیری تقویتی برای مدلهای زبانی (LLM RL) | PPO / GRPO | روی سطح توالی عمل میکند، نه گام به گام؛ تابع زیان متفاوتی دارد. |
درسهای DQN همچنان ماندگارند. بافر بازپخش و شبکهی هدف در SAC، TD3، DDPG، SAC-X، بافر خود-بازی (self-play) در AlphaZero و تمام روشهای یادگیری تقویتی آفلاین به چشم میخورند. برش پاداش هم در قالب نرمالسازی مزیت (advantage normalization) در PPO ادامه حیات داده است. این معماری، طرح اولیهی همهی آنهاست.
تحویل پروژه
این فایل را با نام outputs/skill-dqn-trainer.md ذخیره کنید:
---
name: dqn-trainer
description: Produce a DQN training config (buffer, target sync, ε schedule, reward clipping) for a discrete-action RL task.
version: 1.0.0
phase: 9
lesson: 5
tags: [rl, dqn, deep-rl]
---

Given a discrete-action environment (observation shape, action count, horizon, reward scale), output:

1. Network. Architecture (MLP / CNN / Transformer), feature dim, depth.
2. Replay buffer. Capacity, minibatch size, warmup size.
3. Target network. Sync strategy (hard every C steps or soft τ).
4. Exploration. ε start / end / schedule length.
5. Loss. Huber vs MSE, gradient clip value, reward clipping rule.
6. Double DQN. On by default unless explicit reason to disable.

Refuse to ship a DQN with no target network, no replay buffer, or ε held at 1. Refuse continuous-action tasks (route to SAC / TD3). Flag any reward range > 10× per-step mean as needing clipping or scale normalization.تمرینها
- ساده. فایل
code/main.pyرا اجرا کنید. نمودار بازده هر اپیزود را رسم کنید. میانگین متحرک پس از چند اپیزود از -10 بیشتر میشود؟ - متوسط. شبکهی هدف را غیرفعال کنید (از شبکهی آنلاین برای هر دو طرف هدف بلمن استفاده کنید). ناپایداری آموزش را اندازه بگیرید — آیا بازده نوسان میکند یا واگرا میشود؟
- سخت. الگوریتم Double DQN را اضافه کنید: از شبکهی آنلاین برای انتخاب
argmax a'و از شبکهی هدف برای ارزیابی استفاده کنید. در یک محیط GridWorld با پاداشهای نویزی، سوگیریQ(s_0, best_a)را در مقایسه با واقعی بعد از 1,000 اپیزود در دو حالتِ با و بدون Double DQN مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | مفهوم دقیق فنی |
|---|---|---|
| DQN | «Q-learning عمیق» | همان Q-learning همراه با تابع Q عصبی، بافر بازپخش و شبکهی هدف. |
| بافر بازپخش تجربه | «گذارهای برهمخورده» | بافر حلقوی که در هر گام گرادیان بهصورت یکنواخت از آن نمونهگیری میشود؛ دادهها را ناهمبسته میکند. |
| شبکه هدف | «بوتاسترپ ثابت» | یک کپی دورهای از Q که در هدف بلمن استفاده میشود؛ آموزش را پایدار میکند. |
| سهگانهی مرگبار | «علت واگرایی یادگیری تقویتی» | تقریب تابع + بوتاسترپ + یادگیری خارج از خطمشی = نبود تضمین همگرایی. |
| Double DQN | «راهحل سوگیری بیشبرآوردی» | شبکهی آنلاین اقدام را انتخاب میکند، شبکهی هدف آن را میسنجد. |
| Dueling DQN | «سرهای V و A» | تجزیهی تابع بهصورت Q = V + A - mean(A)؛ خروجی یکسان ولی جریان گرادیان بهتر. |
| Rainbow | «تمام ترفندها با هم» | DDQN + PER + dueling + n-step + noisy + distributional همه در یک مدل. |
| PER | «بازپخش اولویتبندیشده» | نمونهبرداری از گذارها متناسب با اندازهی خطای TD. |
برای مطالعهی بیشتر
- Mnih et al. (2013). Playing Atari with Deep Reinforcement Learning — مقالهی کارگاه NeurIPS 2013 که جرقهی یادگیری تقویتی عمیق را زد.
- Mnih et al. (2015). Human-level control through deep reinforcement learning — مقالهی Nature، معرفی DQN روی 49 بازی.
- Hasselt, Guez, Silver (2016). Deep Reinforcement Learning with Double Q-learning — مقالهی DDQN.
- Wang et al. (2016). Dueling Network Architectures — معماری dueling DQN.
- Hessel et al. (2018). Rainbow: Combining Improvements in Deep RL — مقالهی تجمیع ترفندها.
- Sutton & Barto (2018). Ch. 9 — On-policy Prediction with Approximation — بررسی دانشگاهیِ «سهگانهی مرگبار» (تقریب تابع + بوتاسترپ + خارج از خطمشی) که شبکهی هدف و بافر بازپخش DQN برای مهار آن طراحی شدهاند.
- CleanRL DQN implementation — پیادهسازی مرجع DQN در یک فایل تکمسیره که در مطالعات مقایسهای کاربرد دارد؛ خواندن آن در کنار کد صفرتاصدی این درس بسیار مفید است.