
بسیاری از مسائلی که در دنیای واقعی با آنها سروکار داریم — از هدایت ناوگان خودروهای خودران و شبیهسازی بازارهای مالی گرفته تا همکاری چند مدل زبانی — سیستمهای تکایجنتی نیستند. در یادگیری تقویتی سنتی فرض بر این است که محیط پایا است؛ اما وقتی چند عامل تصمیمگیرنده همزمان در یک فضا یاد میگیرند و رفتارشان را تغییر میدهند، محیط از دید هر عامل مدام دگرگون میشود و فرضیات مارکوف نقض میگردند.
یادگیری تقویتی چندایجنتی (Multi-Agent RL یا MARL) جعبهابزار اصلی برای حل همین تعارض است. در این درس یاد میگیرید که چگونه چالشهایی چون نامانایی محیط، تخصیص مبهم اعتبار در پاداشهای مشترک و انفجار فضای اکشن را با پارادایمهایی مدرن نظیر «آموزش متمرکز و اجرای نامتمرکز» (CTDE)، الگوریتمهای قدرتمندی مثل MAPPO و QMIX و رویکردهای خودبازی (Self-play) مدیریت کنید.
کدهای این آموزش روی یک محیط سبک GridWorld طراحی شدهاند و پیادهسازی آنها به پردازندههای گرافیکی سنگین ابری یا پرداختهای ارزی وابسته نیست. میتوانید تمام الگوریتمها را مستقیماً روی پردازندهی سیستم شخصی خود اجرا کنید و مفاهیم پایهای کنترل چندعاملی را به شکلی عملی و گامبهگام به دست آورید.
یادگیری تقویتی تکایجنتی فرض میکند محیط پایا (stationary) است. دو ایجنت یادگیرنده را در یک دنیای مشترک بگذارید تا این فرض بلافاصله فرو بریزد: هر ایجنت بخشی از محیط ایجنت دیگر است و رفتار هر دو پیوسته تغییر میکند. یادگیری تقویتی چندایجنتی (Multi-agent RL یا MARL) مجموعهای از ترفندها و روشهاست تا وقتی فرض مارکوف دیگر برقرار نیست، فرایند یادگیری را به همگرایی برسانیم.
صورت مسئله
رباتی که مسیریابی در یک اتاق را یاد میگیرد، مسئلهای تکایجنتی است. اما یک تیم فوتبال اینطور نیست. رقابت AlphaStar با حریفان در StarCraft اینطور نیست. بازاری از ایجنتهای پیشنهاددهندهی قیمت هم اینطور نیست. دو خودرو که پشت یک تقاطع چهارراه بر سر حق تقدم مذاکره میکنند، اینطور نیست. مسائل جهان واقعی با تعامل چند به چند هیچکدام تکایجنتی نیستند.
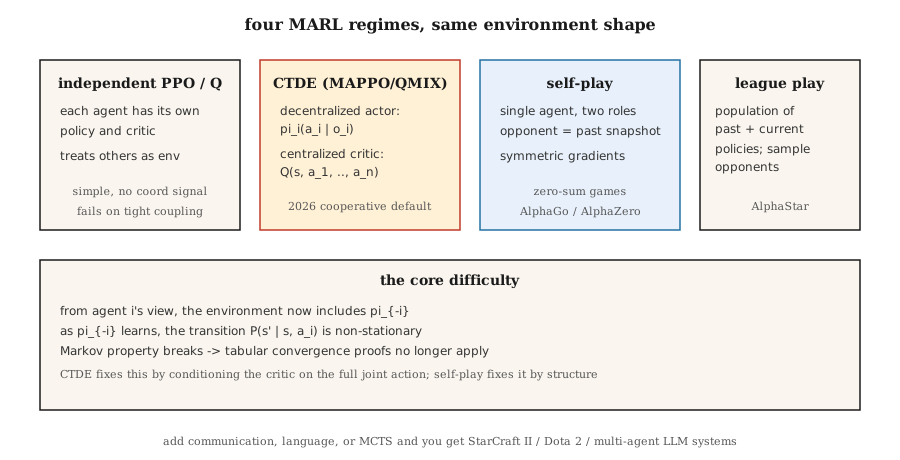
در هر محیط چندایجنتی، از نگاه هر ایجنت، سایر ایجنتها بخشی از محیط هستند. وقتی آنها یاد میگیرند و رفتارشان را تغییر میدهند، محیط نامانا (non-stationary) میشود. خاصیت مارکوف — «وضعیت بعدی فقط به وضعیت فعلی و اکشن من وابسته است» — نقض میشود، چون وضعیت بعدی به انتخابهای سایر ایجنتها هم بستگی دارد و خطمشیهای آنها هدفهایی متحرک و در حال تغییرند.
این پدیده اثباتهای ریاضیِ همگرایی جدولی را باطل میکند (اثبات Q-learning بر پایهی فرض محیط مانا است). یادگیری تقویتی عمیقِ سادهانگارانه را هم از کار میاندازد: ایجنتها در چرخهای بیپایان به دنبال هم میدوند و هرگز به یک خطمشی پایدار نمیرسند. در چنین شرایطی به تکنیکهای ویژهی سیستمهای چندایجنتی نیاز دارید: آموزش متمرکز / اجرای نامتمرکز، خطوط پایهی خلافواقع (counterfactual baselines)، بازی لیگ (league play) و خودبازی (self-play).
کاربردهای سال 2026: ازدحام رباتها (robot swarms)، هدایت ترافیک، ناوگان خودروهای خودران، شبیهسازهای بازار، سیستمهای چندایجنتی مبتنی بر مدلهای زبانی بزرگ (فاز 16) و هر بازی با بیش از یک بازیکن هوشمند.
مفاهیم پایه
صورتبندی ریاضی: بازی مارکوف (Markov Game). تعمیمی از MDP: وضعیتهای ، اکشن مشترک ، تابع انتقال ، و پاداش اختصاصی هر ایجنت . هر ایجنت بازده خود را بر اساس خطمشی خودش بیشینه میکند. اگر پاداشها یکسان باشند، بازی کاملاً همکارانه (fully cooperative) است. اگر مجموعصفر باشد، رقابتی (adversarial) است. اگر ترکیبی باشد، مجموععمومی (general-sum) نامیده میشود.
چالشهای بنیادین:
- نامانایی (Non-stationarity). تابع انتقال از نگاه ایجنت به وابسته است که مدام تغییر میکند.
- تخصیص اعتبار (Credit assignment). با وجود پاداش مشترک، مشخص نیست کدام ایجنت مسبب نتیجه بوده است.
- هماهنگی در کاوش (Exploration coordination). ایجنتها باید استراتژیهای مکمل را کاوش کنند، نه اینکه دوباره روی وضعیتی تکراری تمرکز کنند.
- مقیاسپذیری (Scalability). فضای اکشن مشترک نسبت به رشدی نمایی دارد.
- مشاهدهپذیری جزئی (Partial observability). هر ایجنت فقط مشاهدات محلی خودش را میبیند؛ وضعیت کلی پنهان است.
چهار رویکرد غالب:
1. الگوریتم Q-learning مستقل / الگوریتم PPO مستقل (IQL، IPPO). هر ایجنت تابع Q یا خطمشی اختصاصی خودش را یاد میگیرد و بقیه را جزئی از محیط میبیند. پیادهسازی آن ساده است و گاهی هم جواب میدهد (بهویژه وقتی حافظهی بازپخش تجارب نقشی شبیه به ترفند هموارسازی برای مدلسازی سایر ایجنتها بازی کند). همگرایی نظری: هیچ. در عمل: برای تسکهایی با جفتشدگی ضعیف (loosely-coupled) خوب است، اما برای تسکهایی با وابستگی تنگاتنگ کارایی ندارد.
2. آموزش متمرکز، اجرای نامتمرکز (CTDE). رایجترین پارادایم امروزی. هر ایجنت خطمشی اختصاصی خودش را دارد که به مشاهدهی محلی مشروط است — یعنی همان اجرای استانداردِ نامتمرکز هنگام استقرار عملیاتی. اما در طول آموزش، یک نقاد (critic) متمرکز روی وضعیت کامل سراسری و اکشن مشترک شرطی میشود. نمونهها:
- روش MADDPG (لو و همکاران، 2017): الگوریتم DDPG همراه با یک نقاد متمرکز برای هر ایجنت.
- روش COMA (فورستر و همکاران، 2017): خط پایهی خلافواقع — میپرسد «اگر بهجای این اکشن، را انتخاب میکردم پاداشم چقدر میشد؟» — و به این ترتیب سهم اختصاصی من را جدا میکند.
- روش MAPPO / روش IPPO با نقاد مشترک (یو و همکاران، 2022): الگوریتم PPO همراه با تابع ارزش متمرکز. الگوریتم مسلط سال 2026 برای مسائل MARL همکارانه.
- روش QMIX (رشید و همکاران، 2018): تجزیهی ارزش — با ترکیب یکنوا (monotonic mixing).
3. خودبازی (Self-play). دو نسخه از یک ایجنت در برابر یکدیگر بازی میکنند. خطمشی حریف، در واقع همان خطمشی خود من از یک اسنپشات قبلی است. روش بهکاررفته در AlphaGo / AlphaZero / MuZero و OpenAI Five. بهترین کارایی را در بازیهای مجموعصفر دارد؛ جایی که سیگنال آموزش کاملاً متقارن است.
4. بازی لیگ (League play). تعمیم خودبازی به محیطهای مجموععمومی یا رقابتی: مجموعهای از خطمشیهای گذشته و حال را نگه دارید، حریفی از لیگ نمونهبرداری کنید و در برابر آن آموزش ببینید. ایجنتهای بهرهبردار (متخصص شکست دادن بهترین ایجنت فعلی) و بهرهبرداران اصلی (متخصص شکست دادن خود بهرهبرداران) هم به لیگ اضافه میشوند. روش بهکاررفته در AlphaStar (بازی StarCraft II). زمانی ضروری است که بازی شامل چرخههای استراتژیک شبیه «سنگ-کاغذ-قیچی» باشد.
ارتباط (Communication). به ایجنتها اجازه دهید پیامهای یادگرفتهشده را برای هم ارسال کنند. در محیطهای همکارانه عالی عمل میکند. فورستر و همکاران (2016) نشان دادند که ارتباط دیفرانسیلپذیر بینایجنتی را میتوان بهصورت سرتاسری (end-to-end) آموزش داد. سیستمهای چندایجنتی امروزی مبتنی بر مدلهای زبانی (فاز 16) اساساً با زبان طبیعی با هم گفتگو میکنند.
پیادهسازی عملی
در این درس از یک دنیای شبکهای (GridWorld) در ابعاد 6×6 با دو ایجنت همکار استفاده میکنیم. آنها از گوشههای روبهروی هم شروع میکنند و باید به هدفی مشترک برسند. پاداش مشترک: تا زمانی که حداقل یکی از ایجنتها در حال حرکت باشد -1 در هر گام، و وقتی هر دو برسند +10. کد کامل را در code/main.py ببینید.
گام 1: محیط چندایجنتی
class CoopGridWorld:
    def __init__(self):
        self.size = 6
        self.goal = (5, 5)

    def reset(self):
        return ((0, 0), (5, 0))  # two agents

    def step(self, state, actions):
        a1, a2 = state
        new1 = move(a1, actions[0])
        new2 = move(a2, actions[1])
        done = (new1 == self.goal) and (new2 == self.goal)
        reward = 10.0 if done else -1.0
        return (new1, new2), reward, done
فضای اکشن مشترک برابر با |A|² = 16 است. وضعیت سراسری هم از دو موقعیت مکانی تشکیل شده است.
گام 2: روش Q-learning مستقل
هر ایجنت جدول Q اختصاصی خودش را بر پایهی وضعیت مشترک نگهداری میکند. در هر گام: هر دو ایجنت با استراتژی ε-greedy اکشن انتخاب میکنند، انتقال مشترک را دریافت میکنند و هرکدام جدول Q خود را با همان پاداش مشترک بهروزرسانی میکنند.
def independent_q(env, episodes, alpha, gamma, epsilon):
    Q1, Q2 = defaultdict(default_q), defaultdict(default_q)
    for _ in range(episodes):
        s = env.reset()
        done = False
        while not done:
            a1 = epsilon_greedy(Q1, s, epsilon)
            a2 = epsilon_greedy(Q2, s, epsilon)
            s_next, r, done = env.step(s, (a1, a2))
            if done:
                Q1[s][a1] += alpha * (r - Q1[s][a1])
                Q2[s][a2] += alpha * (r - Q2[s][a2])
                break
            target1 = r + gamma * max(Q1[s_next].values())
            target2 = r + gamma * max(Q2[s_next].values())
            Q1[s][a1] += alpha * (target1 - Q1[s][a1])
            Q2[s][a2] += alpha * (target2 - Q2[s][a2])
            s = s_next
این روش روی این تسک جواب میدهد، چون پاداشها متراکم (dense) و همجهت هستند. اما روی تسکهایی با جفتشدگی تنگاتنگ شکست میخورد (مثلاً جایی که یک ایجنت باید منتظر دیگری بماند).
گام 3: روش Q متمرکز با بهروزرسانی ارزش تجزیهشده
از یک تابع Q روی کل اکشنهای مشترک استفاده کنید. آن را بر اساس پاداش مشترک بهروزرسانی کنید. در زمان اجرا، با حاشیهسازی (marginalizing) سیستم را نامتمرکز کنید: . با این کار، هزینهی فضای نمایی اکشن مشترک را برای رسیدن به یک دید سراسری دقیق میپذیرید.
گام 4: خودبازی ساده (دو ایجنت رقابتی)
یک ایجنت یکسان در دو نقش. ایجنت A را در برابر ایجنت B آموزش دهید؛ بعد از هر اپیزود، وزنهای A را درون B کپی کنید. این آموزش متقارن، پیشرفتی مداوم ایجاد میکند؛ فرمول AlphaZero در ابعاد کوچک.
دامهای رایج
- بازپخش نامانا (Non-stationary replay). استفاده از حافظهی بازپخش تجارب با ایجنتهای مستقل بدتر از حالت تکایجنتی است؛ چون انتقالهای قدیمی را حریفانی تولید کردهاند که رفتارهایشان حالا کاملاً عوض شده است. راهحل: برچسبگذاری مجدد یا وزندهی بر اساس تازگی دادهها.
- ابهام در تخصیص اعتبار. پاداش مشترک پس از یک اپیزود طولانی ثبت میشود و راه روشنی برای مشخص کردن سهم هر ایجنت وجود ندارد. راهحل: خطوط پایهی خلافواقع (COMA) یا شکلدهی پاداش (reward shaping) مجزا به ازای هر ایجنت.
- رانش / تعقیب بیپایان خطمشیها (Policy drift). بهترین پاسخ هر ایجنت با هر بار بهروزرسانی دیگری تغییر میکند. راهحل: نقاد متمرکز، نرخهای یادگیری پایین، یا فریز کردن نوبتی ایجنتها حین آموزش.
- هک پاداش از مسیر هماهنگی ناخواسته. ایجنتها ترفندهای هماهنگ خلاقانهای برای سوءاستفاده پیدا میکنند که طراح فکرش را نمیکرد؛ مثلاً ایجنتهای یک مزایده هماهنگ میشوند و قیمت پیشنهادی صفر ثبت میکنند. راهحل: طراحی دقیق پاداشها و اعمال قیود رفتاری.
- تکرار در کاوش (Exploration redundancy). هر دو ایجنت جفتهای وضعیت-اکشن یکسانی را کاوش میکنند. راهحل: افزودن پاداش آنتروپی برای هر ایجنت یا شرطیسازی بر اساس نقشها.
- چرخههای باطل در لیگ. خودبازی ساده ممکن است در یک چرخهی برتری دورانی (سنگ-کاغذ-قیچی) گیر بیفتد. راهحل: بازی لیگ با حضور حریفان متنوع.
- انفجار ابعاد نمونهها. حاصلضرب
nایجنت × فضای وضعیت × اکشنهای مشترک نجومی میشود. راهحل: استفاده از توابع تقریبگر و فضاهای اکشن تفکیکشده (یک سر خروجیِ خطمشی برای هر ایجنت).
استفاده در عمل
نقشهی کاربردهای MARL در سال 2026:
| حوزه | روش | نکات |
|---|---|---|
| ناوبری / دستکاری همکارانه رباتها | MAPPO / QMIX | رویکرد CTDE؛ نقاد مشترک + اکترهای نامتمرکز. |
| بازیهای دونفره (شطرنج، گو، پوکر) | خودبازی همراه با MCTS (مشابه AlphaZero) | مجموعصفر؛ آموزش متقارن. |
| بازیهای چندنفرهی پیچیده (Dota، StarCraft) | بازی لیگ + پیشآموزش تقلیدی | OpenAI Five و AlphaStar. |
| ناوگان خودروهای خودران | CTDE MAPPO / PPO همراه با اتنشن | مشاهدهپذیری جزئی؛ تعداد متغیر اعضای تیم. |
| بازارهای حراج و مزایده | تعادل نظریهی بازیها + RL | روشهای Mean-field RL وقتی n → ∞. |
| سیستمهای چندایجنتی LLM (فاز 16) | ارتباط با زبان طبیعی + شرطیسازی نقش | چرخهی RL در لایهی برنامهریزی ایجنتها. |
در سال 2026، سریعترین حوزهی رشد MARL سیستمهای مبتنی بر مدلهای زبانی بزرگ است: گروهی از ایجنتهای زبانی که با هم مذاکره میکنند، مباحثه راه میاندازند و نرمافزار توسعه میدهند. در این سیستمها، RL در قالب بهینهسازی ترجیحات روی خروجیهای سطح مسیر (trajectory-level) اعمال میشود، نه روی تکتک توکنها (فاز 16 · 03).
خروجی نهایی
متن زیر را در مسیر outputs/skill-marl-architect.md ذخیره کنید:
---
name: marl-architect
description: Pick the right multi-agent RL regime (IPPO, CTDE, self-play, league) for a given task.
version: 1.0.0
phase: 9
lesson: 10
tags: [rl, multi-agent, marl, self-play]
---

Given a task with `n` agents, output:

1. Regime classification. Cooperative / adversarial / general-sum. Justify.
2. Algorithm. IPPO / MAPPO / QMIX / self-play / league. Reason tied to coupling tightness and reward structure.
3. Information access. Centralized training (what global info goes to the critic)? Decentralized execution?
4. Credit assignment. Counterfactual baseline, value decomposition, or reward shaping.
5. Exploration plan. Per-agent entropy, population-based training, or league.

Refuse independent Q-learning on tightly-coupled cooperative tasks. Refuse to recommend self-play for general-sum with cycle risks. Flag any MARL pipeline without a fixed-opponent eval (cherry-picked self-play numbers are common).تمرینها
- ساده. الگوریتم Q-learning مستقل را روی محیط GridWorld همکارانهی دوایجنت آموزش دهید. پس از چند اپیزود میانگین بازده بیشتر از صفر میشود؟ منحنی یادگیری مشترک را رسم کنید.
- متوسط. یک تسک «نیازمند هماهنگی» اضافه کنید: رسیدن به هدف تنها در صورتی تکمیل میشود که هر دو ایجنت دقیقاً در یک نوبت همزمان وارد خانهی هدف شوند. آیا روش Q مستقل هنوز همگرا میشود؟ چه بخشی از کار دچار مشکل میشود؟
- سخت. یک نقاد متمرکز به سبک MAPPO پیادهسازی کنید و سرعت همگرایی آن را با PPO مستقل روی همان تسک هماهنگی مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | برداشتی که دیگران دارند | معنای دقیق فنی |
|---|---|---|
| بازی مارکوف (Markov game) | «همان MDP چندایجنتی» | ؛ هر ایجنت تابع پاداش اختصاصی خودش را دارد. |
| روش CTDE | «آموزش متمرکز، اجرای نامتمرکز» | نقاد مشترک هنگام آموزش؛ خطمشی هر ایجنت تنها با مشاهدات محلی خودش اجرا میشود. |
| روش IPPO | «الگوریتم PPO مستقل» | هر ایجنت PPO را مستقل اجرا میکند. بیسلاینی ساده که تواناییاش دستکم گرفته میشود. |
| روش MAPPO | «الگوریتم PPO چندایجنت» | الگوریتم PPO با تابع ارزش متمرکز که روی وضعیت سراسری شرطی شده است. |
| روش QMIX | «تجزیهی ارزش یکنوا» | شرط امکان بیشینهسازی (argmax) نامتمرکز را فراهم میکند. |
| روش COMA | «الگوریتم چندایجنتی خلافواقع» | مزیت = مقدار Q من منهای Q انتظاری حاصل از حاشیهسازی روی اکشنهای من. |
| خودبازی (Self-play) | «ایجنتی در برابر نسخهی قبلی خودش» | یک ایجنت در دو نقش متقابل؛ راهکار استاندارد برای بازیهای مجموعصفر. |
| بازی لیگ (League play) | «آموزش جمعیتی» | ذخیرهی خطمشیهای پیشین و نمونهبرداری از رقبا؛ مهار چرخههای استراتژیک. |
برای مطالعهی بیشتر
- لو و همکاران (2017). یادگیری Actor-Critic چندایجنت برای محیطهای ترکیبی همکارانه-رقابتی (MADDPG) — روش CTDE همراه با نقاد متمرکز.
- فورستر و همکاران (2017). گرادیانهای خطمشی چندایجنت خلافواقع (COMA) — خطوط پایهی خلافواقع برای تخصیص اعتبار.
- رشید و همکاران (2018). روش QMIX: تجزیهی یکنوای تابع ارزش — تجزیهی ارزش با شرط یکنوایی.
- یو و همکاران (2022). اثربخشی غافلگیرکنندهی PPO در بازیهای چندایجنتی همکارانه (MAPPO) — قدرت غیرمنتظرهی PPO در MARL.
- وینیالس و همکاران (2019). دستیابی به سطح استادبزرگ در StarCraft II با یادگیری تقویتی چندایجنتی (AlphaStar) — بازی لیگ در مقیاس بسیار بزرگ.
- سیلور و همکاران (2017). تسلط بر بازی گو بدون دانش انسانی (AlphaGo Zero) — خودبازی خالص در بازیهای مجموعصفر.
- ساتن و بارتو (2018). فصل 15 — علوم اعصاب و فصل 17 — مرزهای دانش — بررسی کوتاه کتاب درسی پیرامون ساختارهای چندایجنتی و مسئلهی نامانایی که CTDE برای حل آن طراحی شده است.
- ژانگ، یانگ و بشار (2021). یادگیری تقویتی چندایجنتی: مروری گزیده — مقالهی مروری جامع روی MARL همکارانه، رقابتی و ترکیبی همراه با نتایج همگرایی ریاضی.