
در برنامهریزی پویا فرض بر این است که ماتریس کامل احتمالات انتقال و پاداشهای محیط را در دست دارید. اما در کاربردهای واقعی، از رباتیک گرفته تا تنظیم دقیق مدلهای زبانی، دسترسی به یک مدل دقیق ریاضی از محیط ناممکن است. شما نمیتوانید رفتار یک انسان، دینامیک دقیق یک سیستم فیزیکی یا توزیع آماری واژهها را بهشکل تحلیلی بنویسید؛ تنها کاری که میتوانید انجام دهید، اجرای یک سیاست و مشاهدهی نتایج حاصل از آن است.
روشهای مونتکارلو (Monte Carlo Methods) نخستین پاسخ به این چالش هستند. این الگوریتمها نیازی به داشتن مدل انتقال ندارند و تنها با تکیه بر نمونهبرداری از مسیرهای کامل (اپیزودها) و میانگینگیری از بازدههای مشاهدهشده، ارزش حالتها و سیاست بهینه را برآورد میکنند. درک دقیق مونتکارلو پایهی یادگیری تمام الگوریتمهای پرکاربرد بعدی نظیر TD ،Q-learning و PPO است.
برنامهریزی پویا به مدل نیاز دارد. مونتکارلو فقط اپیزود میخواهد. خطمشی را اجرا کنید، بازدهها را ببینید و میانگین بگیرید. سادهترین ایدهی یادگیری تقویتی (Reinforcement Learning) — و همان کلیدی که قفل همهی مباحث بعدی را باز میکند.
صورتمسئله
برنامهریزی پویا (Dynamic Programming یا DP) رویکردی تمیز و شستهرفته است، اما فرض میکند میتوانید برای تکتک حالتها و کنشها به دسترسی داشته باشید. در دنیای واقعی تقریباً هیچ سیستمی اینطور کار نمیکند. یک ربات نمیتواند توزیع احتمال پیکسلهای دوربین را پس از اِعمال گشتاور روی مفصل، بهشکل تحلیلی محاسبه کند. یک الگوریتم قیمتگذاری نمیتواند روی تمام واکنشهای ممکن مشتریان انتگرال بگیرد. یک مدل زبانی بزرگ (LLM) هم نمیتواند تمام ادامههای ممکن پس از یک توکن (Token) را بشمارد.
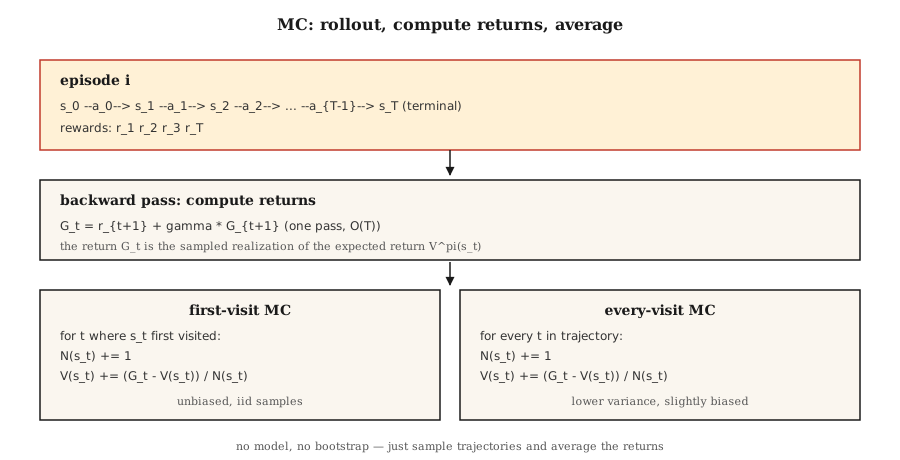
به روشی نیاز دارید که تنها به یک توانایی وابسته باشد: نمونهبرداری از محیط. خطمشی را اجرا کنید؛ یک مسیر s_0, a_0, r_1, s_1, a_1, r_2, …, s_T به دست آورید و از همین مسیر برای تخمین ارزشها استفاده کنید. این یعنی مونتکارلو (Monte Carlo یا MC).
گذار از DP به MC از نظر مفهومی اهمیت زیادی دارد: از «مدل معلوم + پشتیبانگیری دقیق» به «اجراهای نمونهبرداریشده + میانگین بازدهها» میرسیم. واریانس بهشدت بالا میرود، اما دامنهی کاربرد جهش چشمگیری پیدا میکند. تکتک الگوریتمهای یادگیری تقویتی بعد از این درس — از TD و Q-learning گرفته تا REINFORCE ،PPO و GRPO — در اصل یک تخمینگر مونتکارلو هستند که گاهی بوتاسترپ (Bootstrapping) هم روی آنها سوار شده است.
مفاهیم کلیدی
ایدهی اصلی در یک خط: که در آن بازدههای مشاهدهشده پس از ملاقاتهای حالت تحت خطمشی هستند.
مونتکارلوی اولینملاقات در برابر همهملاقاتها (First-visit vs every-visit MC): اگر در طول یک اپیزود چند بار از حالت بازدید شود، روش اولینملاقات فقط بازده حاصل از اولین بازدید را ثبت میکند؛ روش همهملاقاتها همهی بازدیدها را به حساب میآورد. روش اولینملاقات بدون بایاس است. روش همهملاقاتها روی تعداد متناهی اپیزود ممکن است اندکی بایاس داشته باشد، چون در هر اپیزود میانگینِ تعداد تصادفیای از بازدهها را میگیرد و این تعداد میتواند با مقدار بازدهها همبستگی داشته باشد؛ اما هر دو روش با میل کردن تعداد بازدیدها به بینهایت، به همگرا میشوند. تحلیل روش اولینملاقات سادهتر است (نمونههای مستقل با توزیع یکسان یا iid). روش همهملاقاتها از دادههای هر اپیزود بیشتر استفاده میکند و در عمل معمولاً سریعتر همگرا میشود.
میانگین افزایشی (Incremental mean): بهجای ذخیرهی تمام بازدهها، میانگین متحرک را بهروزرسانی کنید:
با بازآرایی عبارت داریم: همراه با . حال اگر را با یک اندازهی گام ثابت جایگزین کنید، به یک تخمینگر مونتکارلوی ناپایا میرسید که تغییرات را دنبال میکند. همین تغییر ساده، کل فاصلهی بین MC تا TD و تمام الگوریتمهای مدرن یادگیری تقویتی را پر میکند.
اکتشاف حالا یک مسئله است: روش DP با پیمایش ترتیبی به همهی حالتها سر میزد. در مقابل، MC فقط حالتهایی را میبیند که خطمشی واقعاً آنها را ملاقات کند. اگر قطعی باشد، بخشهای وسیعی از فضای حالت هرگز نمونهبرداری نمیشوند و تخمین ارزش آنها تا ابد روی صفر میماند. سه راهکار برای رفع این مشکل، به ترتیب تاریخی:
- شروعهای اکتشافی (Exploring starts): هر اپیزود را از یک جفت تصادفی (s, a) آغاز کنید. این کار پوشش را تضمین میکند، اما در عمل واقعبینانه نیست (نمیتوانید یک ربات فیزیکی را روی یک حالت دلخواه ریست کنید).
- اکتشاف ε-حریصانه (ε-greedy): نسبت به مقادیر فعلی Q حریصانه عمل کنید، اما با احتمال یک کنش تصادفی بردارید. در طول زمان، همهی جفتهای حالت-کنش بهطور مجانبی نمونهبرداری میشوند.
- مونتکارلوی خارج از خطمشی (Off-policy MC): دادهها را تحت یک خطمشی رفتاری جمعآوری کنید و دربارهی خطمشی هدف با استفاده از نمونهبرداری اهمیتی (Importance Sampling) یاد بگیرید. واریانس این روش بالاست، اما پلی بهسوی روشهای مبتنی بر بافر بازپخش مثل DQN به حساب میآید.
کنترل مونتکارلو (Monte Carlo Control): ارزیابی کنید ← بهبود دهید ← ارزیابی کنید؛ درست مانند روش تکرار خطمشی، با این تفاوت که ارزیابی بر اساس نمونهبرداری انجام میشود:
- خطمشی را اجرا کنید و یک اپیزود به دست آورید.
- با بازدههای مشاهدهشده، را بهروزرسانی کنید.
- خطمشی را نسبت به بهصورت ε-حریصانه درآورید.
- مراحل را تکرار کنید.
تحت شرایطی ملایم (ملاقات نامتناهیِ همهی جفتها و برقراری شرط رابینز-مونرو برای )، این روش با احتمال 1 به و همگرا میشود.
پیادهسازی از صفر
گام 1: اجرای مسیر ← فهرستی از (s, a, r)
def rollout(env, policy, max_steps=200):
    trajectory = []
    s = env.reset()
    for _ in range(max_steps):
        a = policy(s)
        s_next, r, done = env.step(s, a)
        trajectory.append((s, a, r))
        s = s_next
        if done:
            break
    return trajectory
هیچ مدلی در کار نیست؛ فقط env.reset() و env.step(s, a). دقیقاً همان رابط کاربری محیطهای Gym، اما در سادهترین شکل ممکن.
گام 2: محاسبهی بازدهها (پیمایش معکوس)
def returns_from(trajectory, gamma):
    returns = []
    G = 0.0
    for _, _, r in reversed(trajectory):
        G = r + gamma * G
        returns.append(G)
    return list(reversed(returns))
تنها در یک دور پیمایش، . رابطهی بازگشتی رو به عقب مانع از جمعزدنهای مکرر میشود.
گام 3: ارزیابی مونتکارلوی اولینملاقات
def mc_policy_evaluation(env, policy, episodes, gamma=0.99):
    V = defaultdict(float)
    counts = defaultdict(int)
    for _ in range(episodes):
        trajectory = rollout(env, policy)
        returns = returns_from(trajectory, gamma)
        seen = set()
        for t, ((s, _, _), G) in enumerate(zip(trajectory, returns)):
            if s in seen:
                continue
            seen.add(s)
            counts[s] += 1
            V[s] += (G - V[s]) / counts[s]
    return V
سه خط کار اصلی را انجام میدهند: علامتگذاری حالت در اولین بازدید، افزایش شمارنده و بهروزرسانی میانگین متحرک.
گام 4: کنترل مونتکارلوی ε-حریصانه (رویخطمشی)
def mc_control(env, episodes, gamma=0.99, epsilon=0.1):
    Q = defaultdict(lambda: {a: 0.0 for a in ACTIONS})
    counts = defaultdict(lambda: {a: 0 for a in ACTIONS})

    def policy(s):
        if random() < epsilon:
            return choice(ACTIONS)
        return max(Q[s], key=Q[s].get)

    for _ in range(episodes):
        trajectory = rollout(env, policy)
        returns = returns_from(trajectory, gamma)
        seen = set()
        for (s, a, _), G in zip(trajectory, returns):
            if (s, a) in seen:
                continue
            seen.add((s, a))
            counts[s][a] += 1
            Q[s][a] += (G - Q[s][a]) / counts[s][a]
    return Q, policy
گام 5: مقایسه با استاندارد طلایی DP
با میل کردن تعداد اپیزودها به سمت بینهایت، تخمین مونتکارلوی شما از باید با نتیجهی حاصل از DP در درس 02 همخوانی داشته باشد. در عمل، اجرای 50,000 اپیزود در محیط GridWorld با ابعاد 4×4 خطایی در حدود ~0.1 نسبت به پاسخ DP به شما میدهد.
خطاهای رایج
- اپیزودهای بیپایان: روش MC حتماً به پایانپذیر بودن اپیزودها وابسته است. اگر خطمشی شما در حلقهای بیپایان میافتد، سقف
max_stepsبگذارید و رسیدن به سقف را شکست تلقی کنید. در GridWorld اجرای یک خطمشی تصادفی بارها به سقف زمان مجاز میرسد؛ این وضعیت عادی است، فقط مطمئن شوید که آن را درست حساب میکنید. - واریانس: روش MC کل بازده را در نظر میگیرد. در اپیزودهای طولانی، واریانس بسیار زیاد است؛ یک پاداش بدشانس در پایان کار، مقدار را به همان اندازه جابهجا میکند. روشهای TD (درس 04) این واریانس را با بوتاسترپ کاهش میدهند.
- پوشش فضای حالت: روش حریصانهی MC روی یک ماتریس Q تازه با مقادیر مساوی، فقط و فقط یک کنش را امتحان خواهد کرد. حتماً باید سازوکار اکتشاف داشته باشید (روش ε-حریصانه، شروعهای اکتشافی یا UCB).
- خطمشیهای ناپایا: اگر تغییر کند (مثل بخش کنترل مونتکارلو)، بازدههای قدیمی متعلق به خطمشی دیگری خواهند بود. استفاده از نرخ گام ثابت α در MC این مسئله را حل میکند؛ اما میانگینگیری ساده از نمونهها توان مدیریت آن را ندارد.
- نمونهبرداری اهمیتی در روش خارج از خطمشی: وزنهای در طول مسیر در هم ضرب میشوند. با طولانی شدن افق، واریانس سر به فلک میکشد. برای مهار آن از نمونهبرداری اهمیتی وزندارِ تفکیکشده به ازای هر تصمیم استفاده کنید یا به سراغ TD بروید.
استفاده در دنیای واقعی
جایگاه روشهای مونتکارلو در سال 2026:
| کاربرد | علت استفاده از MC |
|---|---|
| بازیهایی با افق کوتاه (بلکجک، پوکر) | اپیزودها طبیعتاً پایان مییابند؛ بازدهها تمیز و سرراست هستند. |
| ارزیابی آفلاین خطمشیهای ثبتشده در لاگ | میانگینگیری از بازدههای تنزیلشده روی مسیرهای از پیش ثبتشده. |
| جستوجوی درختی مونتکارلو (AlphaZero) | شبیهسازی مسیرهای MC از برگهای درخت، روند انتخاب را هدایت میکند. |
| ارزیابی یادگیری تقویتی در LLMها | محاسبهی پاداش میانگین روی ادامههای نمونهبرداریشده برای یک خطمشی مشخص. |
| تخمین خط مبنا در الگوریتم PPO | تارگت تابع مزیت از یک تخمین مونتکارلو استفاده میکند. |
| آموزش یادگیری تقویتی | سادهترین الگوریتمی که واقعاً کار میکند؛ بدون بوتاسترپ، اصل مفهوم را میبینید. |
الگوریتمهای مدرن یادگیری عمیق تقویتی (مثل PPO و SAC) با بهرهگیری از بازدههای -گامه یا GAE، پلی میان مونتکارلوی خالص (بازدههای کامل) و TD خالص (بوتاسترپ تکگامه) میسازند. هر دو اندپوینت (Endpoint) در واقع نمونههایی از همین یک نوع تخمینگر هستند.
خروجی این درس
این محتوا را در فایل outputs/skill-mc-evaluator.md ذخیره کنید:
---
name: mc-evaluator
description: Evaluate a policy via Monte Carlo rollouts and produce a convergence report with DP-comparison if available.
version: 1.0.0
phase: 9
lesson: 3
tags: [rl, monte-carlo, evaluation]
---

Given an environment (episodic, with reset+step API) and a policy, output:

1. Method. First-visit vs every-visit MC. Reason.
2. Episode budget. Target number, variance diagnostic, expected standard error.
3. Exploration plan. ε schedule (if needed) or exploring starts.
4. Gold-standard comparison. DP-optimal V* if tabular; otherwise a bound from a Q-learning / PPO baseline.
5. Termination check. Max-step cap, timeouts, handling of non-terminating trajectories.

Refuse to run MC on non-episodic tasks without a finite horizon cap. Refuse to report V^π estimates from fewer than 100 episodes per state for tabular tasks. Flag any policy with zero-variance actions as an exploration risk.تمرینها
- ساده. ارزیابی مونتکارلوی اولینملاقات را برای خطمشی تصادفی یکنواخت روی محیط GridWorld با ابعاد 4×4 پیادهسازی کنید. 10,000 اپیزود اجرا کنید. نمودار را بر حسب تعداد اپیزودها در مقایسه با پاسخ DP رسم کنید.
- متوسط. کنترل مونتکارلوی ε-حریصانه را با پیادهسازی کنید. بازده میانگین را پس از 20,000 اپیزود مقایسه کنید. نمودار چه شکلی پیدا میکند؟ موازنهی بایاس و واریانس (Bias-Variance Tradeoff) در کجای کار خود را نشان میدهد؟
- سخت. الگوریتم MC خارج از خطمشی را همراه با نمونهبرداری اهمیتی پیادهسازی کنید: دادهها را تحت خطمشی تصادفی یکنواخت جمعآوری کرده و را برای خطمشی بهینهی قطعی تخمین بزنید. نمونهبرداری اهمیتی ساده، به ازای هر تصمیم و وزندار را با هم مقایسه کنید. کدامیک واریانس کمتری دارد؟
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| مونتکارلو | «نمونهبرداری تصادفی» | تخمین امید ریاضی از طریق میانگینگیری روی نمونههای iid گرفتهشده از توزیع. |
| بازده | «پاداش آینده» | مجموع پاداشهای تنزیلشده از گام تا انتهای اپیزود: . |
| مونتکارلوی اولینملاقات | «شمارش هر حالت فقط یک بار» | فقط اولین بازدید از هر حالت در طول اپیزود در تخمین ارزش حساب میشود. |
| مونتکارلوی همهملاقاتها | «استفاده از تمام بازدیدها» | همهی بازدیدها حساب میشوند؛ برای نمونههای متناهی بایاس ناچیزی دارد، در حد بینهایت سازگار است و بازدهی نمونهای بهتری دارد. |
| ε-حریصانه | «نویز برای اکتشاف» | انتخاب کنش حریصانه با احتمال ؛ کنش تصادفی با احتمال . |
| نمونهبرداری اهمیتی | «تصحیح خطا هنگام نمونهبرداری از توزیع اشتباه» | وزندهی دوباره به بازدهها با ضرب نسبتهای برای تخمین بر اساس دادههای تولیدشده توسط . |
| رویخطمشی | «یادگیری از دادههای خودم» | خطمشی هدف = خطمشی رفتاری. مثل MC پایه، PPO و SARSA. |
| خارج از خطمشی | «یادگیری از دادههای دیگران» | خطمشی هدف ≠ خطمشی رفتاری. مثل MC با نمونهبرداری اهمیتی، Q-learning و DQN. |
برای مطالعهی بیشتر
- Sutton & Barto (2018). Ch. 5 — Monte Carlo Methods — منبع اصلی و استاندارد این مبحث.
- Singh & Sutton (1996). Reinforcement Learning with Replacing Eligibility Traces — تحلیل روشهای اولینملاقات و همهملاقاتها.
- Precup, Sutton, Singh (2000). Eligibility Traces for Off-Policy Policy Evaluation — روش مونتکارلوی خارج از خطمشی و مهار واریانس.
- Mahmood et al. (2014). Weighted Importance Sampling for Off-Policy Learning — بررسی تخمینگرهای مدرن نمونهبرداری اهمیتی با واریانس پایین.
- Tesauro (1995). TD-Gammon, A Self-Teaching Backgammon Program — نخستین نمایش تجربی بزرگ از همگرایی خودبازی بر پایهی MC/TD به سطحی فراتر از انسان؛ پیشدرآمد مفهومی تمام درسهای نیمهی دوم این فاز.