
اگر تا به حال الگوریتم REINFORCE را پیاده کرده باشید، احتمالاً متوجه ناپایداری شدید و نوسانهای بسیار بالای آن در طول یادگیری شدهاید. دلیل این مشکل، اتکا به بازدههای مونتکارلو است که واریانس فوقالعاده بالایی تولید میکنند و فرایند آموزش را بسیار کند و پرهزینه میسازند. روش بازیگر-نقاد (Actor-Critic) دقیقاً برای حل همین چالش ساخته شده است؛ یعنی استفاده از یک شبکهی ارزیاب در نقش خط پایه تا واریانس گرادیانها بهشدت کاهش یابد.
درک معماریهای A2C و A3C پایهی مفهومی تمام پیشرفتهای نوین یادگیری تقویتی عمیق نظیر PPO، SAC و حتی روشهای ترازسازی مدلهای زبانی مانند DPO و GRPO را تشکیل میدهد. کدهای این درس به گونهای طراحی شدهاند که بدون نیاز به GPUهای سنگین ابری و با حداقل پیشنیازها روی سیستم شخصی یا پردازندههای معمولی (CPU) اجرا شوند و درک شهودی و عمیقی از این ساختار به شما بدهند.
الگوریتم REINFORCE پر از نویز است. یک نقاد (critic) اضافه کنید که را یاد بگیرد، آن را از بازده کم کنید، و به مزیتی (advantage) برسید که امید ریاضی یکسانی دارد اما واریانس آن بسیار کمتر است. این همان بازیگر-نقاد (actor-critic) است. A2C آن را بهصورت همگام اجرا میکند؛ A3C آن را روی رشتهها (threads) پیش میبرد. هر دوی اینها مدل ذهنی پشت تکتک روشهای مدرن یادگیری تقویتی (Reinforcement Learning) عمیق هستند.
صورتمسئله
الگوریتم پایهای REINFORCE کار میکند، اما واریانس فاجعهباری دارد. بازدههای مونتکارلو ممکن است بین اپیزودهای مختلف بیش از 10 برابر نوسان کنند. ضرب کردن این نویز در و میانگینگیری از آن، تخمینگری از گرادیان (gradient) میسازد که به هزاران اپیزود نیاز دارد تا خطمشی را به همان اندازهای جابهجا کند که با بهروزرسانیهای بهمراتب کمتری در DQN به آن میرسیدید.
این واریانس بالا ناشی از استفادهی مستقیم از بازدههای خام است. اگر یک خط پایه (baseline) مانند — یعنی هر تابعی از وضعیت، از جمله یک مقدار تخمینیِ یادگرفتهشده — را از بازده کم کنید، امید ریاضی تغییری نمیکند اما واریانس افت محسوسی خواهد داشت. بهترین خط پایهی عملی و در دسترس، است. حالا مقداری که در ضرب میشود، همان مزیت است:
یک عمل در صورتی خوب است که بازدهی بالاتر از میانگین ایجاد کرده باشد، و اگر پایینتر باشد بد است. ترکیب REINFORCE با یک نقاد یادگیرنده، همان بازیگر-نقاد است. نقاد برای بازیگر نقش یک آموزگار با واریانس پایین را ایفا میکند. تمام روشهای مبتنی بر خطمشی عمیق پس از سال 2015 (مثل A2C، A3C، PPO، SAC و IMPALA) بر همین پایه بنا شدهاند.
مبانی نظری
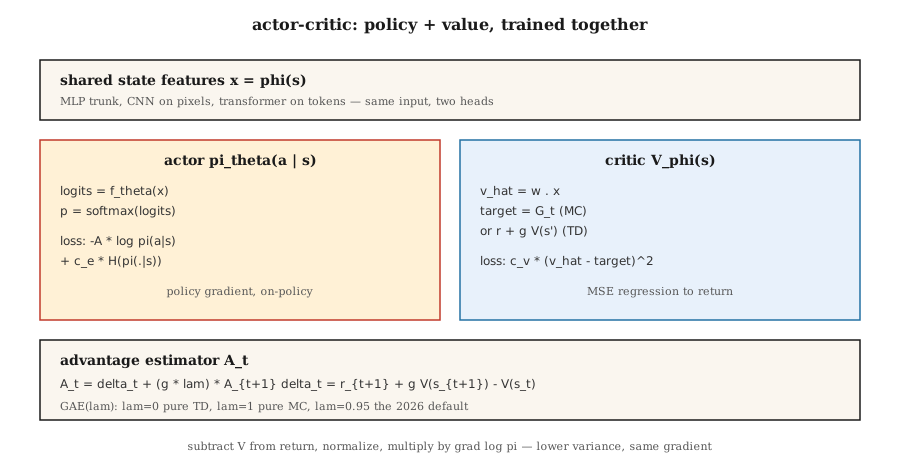
دو شبکه، یک تابع زیان (loss) مشترک:
- بازیگر (Actor) : همان خطمشی است؛ برای دست زدن به عمل نمونهگیری میشود و با گرادیان خطمشی آموزش میبیند.
- نقاد (Critic) : بازده مورد انتظار از یک وضعیت را تخمین میزند و برای کمینهسازی آموزش داده میشود.
مزیت. دو حالت استاندارد دارد:
- مزیت مونتکارلو (MC): . بدون تورش (unbiased)، با واریانس بالاتر.
- مزیت تفاضل زمانی (TD): . دارای تورش (چون از استفاده میکند)، با واریانس بهمراتب کمتر. به آن خطای تفاضل زمانی (TD residual) یا هم میگویند.
مزیت n-گام. درونیابی بین این دو حالت:
مقدار همان TD خالص است. مقدار بازده مونتکارلو است. بیشتر پیادهسازیها از برای محیطهای Atari و از برای PPO روی MuJoCo استفاده میکنند.
تخمین تعمیمیافتهی مزیت (GAE). شولمن و همکاران (2016) میانگین وزندار نمایی را روی تمام مزیتهای n-گام پیشنهاد کردند:
به طوری که . حالت معادل TD است (واریانس پایین، تورش بالا). حالت معادل مونتکارلو است (واریانس بالا، بدون تورش). مقدار گزینهی پیشفرض سال 2026 محسوب میشود — آنقدر تغییرش دهید تا تعادل تورش/واریانس به نقطهی دلخواهتان برسد.
الگوریتم A2C: بازیگر-نقاد همگام با مزیت. تعداد گام را در طول محیط موازی جمعآوری کنید. مزیتها را برای هر گام به دست آورید. بازیگر و نقاد را روی این دستهی (batch) ترکیبی بهروزرسانی کنید. همین روند را تکرار کنید. این نسخه، همتای سادهتر و مقیاسپذیرترِ A3C است.
الگوریتم A3C: بازیگر-نقاد ناهمگام با مزیت. منیح و همکاران (2016). تعداد رشتهی پردازشی (worker thread) بسازید که هر کدام یک محیط را اجرا میکنند. هر پردازشگر گرادیانها را بهطور محلی روی نمونهبرداری خودش محاسبه میکند و سپس آنها را بهشکل ناهمگام روی یک سرور پارامتر مشترک اعمال مینماید. نیازی به بافر بازپخش (replay buffer) نیست — با اجرای مسیرهای مختلف توسط پردازشگرها، همبستگی دادهها خودبهخود از بین میرود. الگوریتم A3C ثابت کرد که میتوان مدلها را در مقیاس بالا روی CPU آموزش داد. در سال 2026، روش A2C مبتنی بر GPU (محیطهای موازی دستهای) دست بالا را دارد، چون پردازندههای گرافیکی به دستههای دادهی بزرگ تمایل دارند.
تابع زیان (loss) ترکیبی.
سه عبارت دارد: تابع زیان گرادیان خطمشی، رگرسیون مقدار ارزش، و پاداش آنتروپی. مقادیر c_v ~ 0.5 و c_e ~ 0.01 نقطههای شروع استاندارد هستند.
پیادهسازی از صفر
گام 1: ساخت نقاد
یک نقاد خطی که با خطای میانگین مربعات (MSE) بهروزرسانی میشود:
def critic_update(w, x, target, lr):
    v_hat = dot(w, x)
    err = target - v_hat
    for j in range(len(w)):
        w[j] += lr * err * x[j]
    return v_hat
روی یک محیط جدولی، نقاد طی چند صد اپیزود همگرا میشود. روی بازیهای Atari، نقاد خطی را با یک بدنهی اصلی CNN مشترک + سرِ مقدار (value head) جایگزین کنید.
گام 2: محاسبهی مزیت n-گام
با داشتن یک مسیر پیمایش (rollout) به طول و یک مقدار پایانیِ تخمینزدهشده (bootstrapped) در نقطهی پایان :
def compute_advantages(rewards, values, gamma=0.99, lam=0.95, last_value=0.0):
    advantages = [0.0] * len(rewards)
    gae = 0.0
    for t in reversed(range(len(rewards))):
        next_v = values[t + 1] if t + 1 < len(values) else last_value
        delta = rewards[t] + gamma * next_v - values[t]
        gae = delta + gamma * lam * gae
        advantages[t] = gae
    returns = [a + v for a, v in zip(advantages, values)]
    return advantages, returns
متغیر returns هدف یادگیری نقاد است. آرایهی advantages همان مقداری است که در ضرب میشود.
گام 3: بهروزرسانی ترکیبی
for step_i, (x, a, _r, probs) in enumerate(traj):
    adv = advantages[step_i]
    target_v = returns[step_i]

    # critic
    critic_update(w, x, target_v, lr_v)

    # actor
    for i in range(N_ACTIONS):
        grad_logpi = (1.0 if i == a else 0.0) - probs[i]
        for j in range(N_FEAT):
theta[i][j] += lr_a * adv * grad_logpi * x[j]بهصورت مبتنی بر خطمشی حاضر (on-policy)، یک مسیر پیمایش به ازای هر بهروزرسانی، و با نرخهای یادگیری (learning rate) مجزا برای بازیگر و نقاد.
گام 4: موازیسازی (A3C در برابر A2C)
- روش A3C: ساخت رشتهی پردازشی. هر کدام محیط و گذر رو به جلوی خودشان را اجرا میکنند. بهطور دورهای بهروزرسانیهای گرادیان را روی سرور اصلی push میکنند. هیچ قفلی (lock) روی مدل اصلی اعمال نمیشود — وقوع تداخل پردازشها (races) ایرادی ندارد و فقط مقداری نویز اضافه میکند.
- روش A2C: اجرای نمونهی محیط در یک پردازش واحد، قرار دادن مشاهدات درون یک دستهی
[N, obs_dim]، اجرای دستهای گذر رو به جلو، و اجرای دستهای گام رو به عقب. این روش بهرهوری بهتری از GPU دارد، قطعی (deterministic) است و تحلیل رفتار آن آسانتر خواهد بود؛ گزینهی پیشفرض در سال 2026.
کد نمونهی ما برای وضوح بیشتر تکرشتهای نوشته شده است؛ تبدیل آن به A2C دستهای فقط سه خط کد در numpy نیاز دارد.
خطاهای رایج
- تورش اولیهی نقاد قبل از محاسبهی گرادیان بازیگر. اگر نقاد مقادیری کاملاً تصادفی بدهد، خط پایهی آن فاقد اطلاعات مفید است و عملاً خطمشی را روی نویز خالص آموزش میدهید. نقاد را قبل از فعال کردن گرادیان خطمشی برای چند صد گام گرمکردن اولیه (warm up) کنید، یا برای بازیگر نرخ یادگیری بسیار پایینی در نظر بگیرید.
- نرمالسازی مزیت. مزیتها را در هر دسته به میانگین صفر و انحراف معیار یک تبدیل کنید. این کار بدون هزینهی پردازشیِ خاصی، پایداری آموزش را به شدت بالا میبرد.
- بدنهی مشترک شبکه. برای ورودیهای تصویری، از یک استخراجکنندهی ویژگی مشترک برای بازیگر و نقاد استفاده کنید و فقط سرها (heads) را جدا نگه دارید. ویژگیهای مشترک از هر دو تابع زیان بهرایگان بهرهمند میشوند.
- قاعدهی مبتنی بر خطمشی حاضر (On-policy). در A2C دادهها دقیقاً برای یک بار بهروزرسانی استفاده میشوند. استفادهی بیشتر باعث ایجاد تورش در گرادیان خواهد شد (تعدیل با نمونهگیری اهمیت همان چیزی است که PPO به ماجرا اضافه میکند).
- فروپاشی آنتروپی. بدون عبارت ، خطمشی ظرف چند صد بهروزرسانی تقریباً قطعی میشود و اکتشاف را متوقف میکند.
- مقیاس پاداش. اندازهی مزیتها به مقیاس پاداشها بستگی دارد. پاداشها را نرمالسازی کنید (مثلاً با تقسیم بر انحراف معیار متحرک) تا بزرگی گرادیانها در تسکهای گوناگون یکدست بماند.
استفاده از ابزارهای واقعی
در سال 2026 روشهای A2C و A3C بهندرت گزینهی نهایی برای پیادهسازی هستند، اما ساختار پایهای به شمار میروند که تمام روشهای بعدی بر اساس آنها توسعه یافتهاند:
| روش | رابطهی آن با A2C |
|---|---|
| PPO | همان A2C به اضافهی نسبت نمونهگیری اهمیت بریدهشده (clipped) برای چند دور بهروزرسانی |
| IMPALA | همان A3C به اضافهی اصلاح خارج از خطمشی با V-trace |
| SAC (فصل 9 · 07) | روش A2C مستقل از خطمشی با یک نقاد ارزش ملایم (درس بعد) |
| GRPO (فصل 9 · 12) | همان A2C بدون نقاد — مزیت نسبی گروهی |
| DPO | تبدیل ساختار A2C به یک تابع زیانِ رتبهبندی اولویتها، بدون نیاز به نمونهگیری |
| AlphaStar / OpenAI Five | همان A2C با آموزش لیگ و پیشآموزش تقلیدی |
در مقالات سال 2026 هر جا کلمهی «مزیت» را دیدید، ساختار بازیگر-نقاد را در ذهن بیاورید.
خروجی این درس
متن زیر را در فایل outputs/skill-actor-critic-trainer.md ذخیره کنید:
---
name: actor-critic-trainer
description: Produce an A2C / A3C / GAE configuration for a given environment, with advantage estimation and loss weights specified.
version: 1.0.0
phase: 9
lesson: 7
tags: [rl, actor-critic, gae]
---

Given an environment and compute budget, output:

1. Parallelism. A2C (GPU batched) vs A3C (CPU async) and the number of workers.
2. Rollout length T. Steps per env per update.
3. Advantage estimator. n-step or GAE(λ); specify λ.
4. Loss weights. `c_v` (value), `c_e` (entropy), gradient clip.
5. Learning rates. Actor and critic (separate if using).

Refuse single-worker A2C on environments with horizon > 1000 (too on-policy, too slow). Refuse to ship without advantage normalization. Flag any run with `c_e = 0` and observed entropy < 0.1 as entropy-collapsed.تمرینها
- ساده. مدل بازیگر-نقاد را با مزیت مونتکارلو روی محیط GridWorld با ابعاد 4×4 آموزش دهید. کارایی دادهای (sample efficiency) آن را با REINFORCE دارای خط پایهی میانگین متحرک از درس 06 مقایسه کنید.
- متوسط. به مزیت خطای تفاضل زمانی سوییچ کنید. واریانس دستههای مزیت را اندازه بگیرید. واریانس چقدر افت میکند؟
- سخت. الگوریتم GAE(λ) را پیاده کنید. بازهی را آزمایش (sweep) کنید. نمودار بازده نهایی در برابر کارایی دادهای را رسم نمایید. نقطهی طلایی موازنهی تورش/واریانس برای این مسئله کجاست؟
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای دقیق آن |
|---|---|---|
| بازیگر (Actor) | «شبکهی خطمشی» | ، که با گرادیان خطمشی بهروزرسانی میشود. |
| نقاد (Critic) | «شبکهی ارزش» | ، که با رگرسیون خطای میانگین مربعات روی بازدهها یا اهداف تفاضل زمانی بهروزرسانی میشود. |
| مزیت (Advantage) | «چقدر از حد متوسط بهتر است» | یا تخمینگرهای آن؛ ضریبی برای . |
| خطای تفاضل زمانی (TD residual) | «δ» | ؛ تخمین مزیت تکگام. |
| تخمین تعمیمیافتهی مزیت (GAE) | «اهرم درونیابی» | مجموع وزندار نمایی از مزیتهای n-گام، با پارامتر . |
| A2C | «بازیگر-نقاد همگام» | دستهبندیشده در چندین محیط؛ یک گام گرادیان به ازای هر پیمایش. |
| A3C | «بازیگر-نقاد ناهمگام» | رشتههای پردازشی گرادیانها را روی یک سرور پارامتر مشترک push میکنند؛ مقالهی اصلی که در سال 2026 کاربرد کمتری دارد. |
| تخمین اولیه (Bootstrap) | «استفاده از V در انتهای افق» | بریدن ادامهی مسیر و افزودن برای بستن مجموع مقادیر. |
برای مطالعهی بیشتر
- Mnih et al. (2016). Asynchronous Methods for Deep Reinforcement Learning — معرفی الگوریتم A3C؛ مقالهی اصلی بازیگر-نقاد ناهمگام.
- Schulman et al. (2016). High-Dimensional Continuous Control Using Generalized Advantage Estimation — معرفی الگوریتم GAE.
- Sutton & Barto (2018). Ch. 13 — Actor-Critic Methods — مفاهیم پایهای؛ این بخش را در کنار فصل 9 (تقریب توابع هنگام استفاده از شبکههای عصبی برای نقاد) بخوانید.
- Espeholt et al. (2018). IMPALA — بازیگر-نقاد توزیعشده و مقیاسپذیر همراه با اصلاح خطمشی با V-trace.
- OpenAI Baselines / Stable-Baselines3 — پیادهسازیهای سطح عملیاتی از A2C و PPO که ارزش بررسی دارند.
- Konda & Tsitsiklis (2000). Actor-Critic Algorithms — نتیجهی پایهای همگرایی برای تجزیهی بازیگر-نقاد در دو مقیاس زمانی متفاوت.