
مدلهای پایهای پس از اتمام پیشآموزش روی مقادیر عظیمی از دادههای وب، ممکن است متنی کاملاً روان تولید کنند اما همچنان پاسخهایی گمراهکننده، پر از توهم یا خارج از چارچوب ارائه دهند. برای تبدیل یک پیشبینیکنندهی خام کلمات به دستیاری امن، کارآمد و مطیع، ناچاریم رفتار آن را همسو کنیم. الگوریتم یادگیری تقویتی با بازخورد انسانی (RLHF) دقیقاً همان فرمولی است که مدلهایی مانند ChatGPT و Claude را وارد جریان کاری روزمره کرد.
اگرچه روشهای سبکتر و جدیدتری مانند DPO بخشی از فرایندهای امروزی را بر عهده گرفتهاند، اما درک مفهوم «مدل پاداش» و بهینهسازی خطمشی در برابر آن هنوز زیربنای اصلی تکنیکهای استدلال، سیستمهای چندمرحلهای و رتبهبندیهای Best-of-N به شمار میآید. شناخت دقیق پیوند میان مدل پاداش، تابع بردلی-تری و کنترل واگرایی KL به شما کمک میکند پشتهی کامل همسوسازی مدرن را عمیقاً درک کنید.
برای تسلط بر این معماری، این درس روند آموزش را از دادههای ترجیحی ساختگی شروع کرده و شما را با پیادهسازی مدل پاداش و ادغام آن با PPO آشنا میکند. پیادهسازی گامهای مفهومی در این آموزش بدون نیاز به خوشههای محاسباتی گرانقیمت یا پردازندههای گرافیکی سنگین ابری روی سیستمهای محلی قابل اجرا است؛ هرچند در صورت نیاز به استفاده از فریمورکهای تولیدی مانند TRL و دانلود وزنها، ممکن است با اختلالات و کندیهای رایج دانلود مخازن خارجی از ایران مواجه شوید که استفاده از آینههای داخلی یا دانلود آفلاین این روند را تسهیل میکند.
انسانها نمیتوانند برای «پاسخ خوبِ یک دستیار» تابع پاداش بنویسند، اما میتوانند دو پاسخ را مقایسه کنند و پاسخ بهتر را برگزینند. یک مدل پاداش را روی این مقایسهها برازش کنید، سپس مدل زبانی را با یادگیری تقویتی (RL) در برابر آن بهینهسازی کنید. Christiano 2017. InstructGPT 2022. همان دستورالعملی که GPT-3 را به ChatGPT تبدیل کرد. در سال 2026 این روش تا حد زیادی با DPO جایگزین شده است — اما مدل ذهنی آن همچنان پابرجاست.
صورت مسئله
شما یک مدل زبانی را با هدف پیشبینی توکن بعدی آموزش دادهاید. این مدل انگلیسیِ درست و باگرامری مینویسد؛ اما در عین حال دروغ میگوید، به حاشیه میرود و از امتناع کردن در مواقع لازم سر باز میزند. نمیتوانید این مشکل را با پیشآموزش بیشتر حل کنید — متنهای وب خودِ مشکل هستند، نه درمان آن.
شما یک پاداش اسکالر میخواهید که بگوید «برای دستور X، پاسخ A از پاسخ B بهتر است». نوشتن دستیِ چنین تابع پاداشی ناممکن است. «مفید بودن» فرمول تحلیلی و فرم بستهای (closed-form) بر حسب توکنها ندارد. اما انسانها میتوانند دو خروجی را با هم مقایسه کنند و اولویت خود را مشخص کنند. جمعآوری چنین دادههایی در مقیاس بالا ارزان تمام میشود.
روش RLHF (Christiano et al. 2017؛ Ouyang et al. 2022) ترجیحات را به یک مدل پاداش تبدیل میکند، سپس مدل زبانی را از طریق PPO در برابر آن پاداش بهینهسازی میکند؛ در سه مرحله: SFT → RM → PPO. این همان دستورالعملی است که ChatGPT، Claude، Gemini و تمام مدلهای زبانی همسوشدهی دیگر را در سالهای 2023 تا 2025 روانهی بازار کرد.
در سال 2026، مرحلهی PPO تا حد زیادی جای خود را به DPO (فاز 10 · درس 08) داده است، چرا که ارزانتر است و برای تیونینگ همسوسازی تقریباً همان کیفیت را ارائه میدهد. اما بخش مدل پاداش همچنان زیربنای همهی نمونهگیرهای (sampler) Best-of-N، تمام پایپلاینهای RL مبتنی بر پاداشهای قابلوارسی، و همهی مدلهای استدلالگری است که از مدل پاداش فرآیندی بهره میبرند. اگر RLHF را بشناسید، کل پشتهی همسوسازی (alignment stack) را فهمیدهاید.
مفهوم اصلی
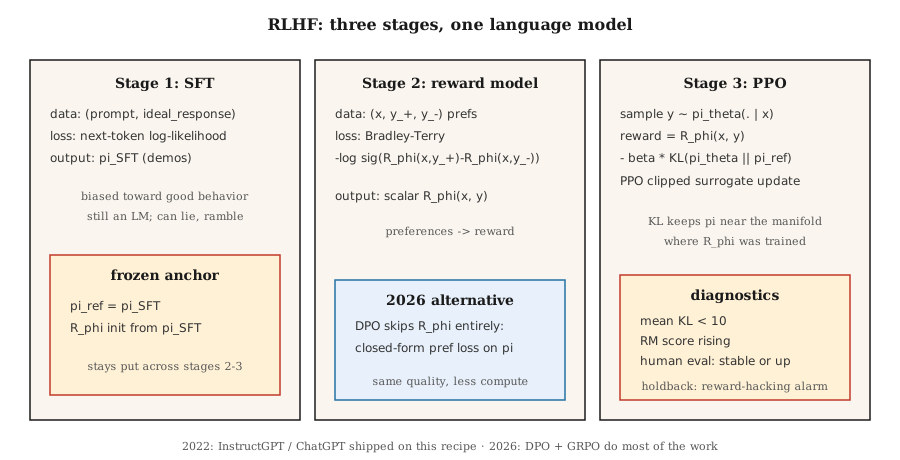
مرحلهی 1: فاینتیونینگ نظارتشده (SFT). کار را از یک مدل پایهی پیشآموزشدیده شروع کنید. آن را روی نمونهرفتارهای هدف که به دست انسان نوشته شدهاند (پاسخهای پیرو دستور، جوابهای مفید و غیره) فاینتیون کنید. نتیجه: مدلی به نام که به سمت رفتار خوب سوگیری دارد اما فضای عمل آن همچنان نامحدود است.
مرحلهی 2: آموزش مدل پاداش (RM).
-
جفت پاسخهای را برای پرامپتهای جمعآوری کنید، بهطوری که برچسب انسانی نشان دهد «y_+ به y_- ترجیح داده شده است».
-
یک مدل پاداش را آموزش دهید تا امتیاز بالاتری به بدهد.
-
تابع زیان (loss): لجستیک جفتی بردلی-تری (Bradley-Terry):
تابع سیگموئید است. اختلاف پاداش نشاندهندهی لگاریتم شانس (log-odds) ترجیح است. مدل بردلی-تری از سال 1952 استاندارد بوده و گزینهی غالب در RLHF امروزی است.
-
معمولاً با وزنهای مدل SFT مقداردهی اولیه میشود و یک سر (head) اسکالر روی آن قرار میگیرد. بکبون (backbone) ترنسفورمر یکسان است؛ فقط یک لایهی خطی ساده پاداش را خروجی میدهد.
مرحلهی 3: اجرای PPO در برابر مدل پاداش با جریمهی واگرایی KL.
-
خطمشی قابل آموزش را از روی مقداردهی کنید. یک مدل مرجع ثابت و فریزشده به نام را نگه دارید.
-
پاداش در انتهای یک پاسخ :
جریمهی KL مانع از آن میشود که بیرویه از فاصله بگیرد — این جریمه یک تنظیمکننده (regularizer) است، نه یک ناحیهی اطمینان سختگیرانه. مقدار معمولاً بین 0.01 تا 0.05 است.
-
الگوریتم PPO (درس 08) را با این پاداش اجرا کنید. مقادیر مزیت (advantage) روی مسیر در سطح توکن محاسبه میشوند، اما مدل پاداش فقط به کل پاسخ نمره میدهد.
چرا جریمهی KL؟ بدون آن، PPO بهراحتی استراتژیهای هک پاداش (reward hacking) را پیدا میکند — زیرا مدل پاداش تنها روی خروجیهای درونتوزیع آموزش دیده است. یک پاسخ خارجازتوزیع ممکن است امتیازی بالاتر از هر متن نوشتهشده به دست انسان بگیرد. جریمهی KL مدل را نزدیک خمینهای (manifold) نگه میدارد که مدل پاداش روی آن آموزش دیده است. این مهمترین اهرم کنترلی در RLHF به شمار میرود.
وضعیت در سال 2026:
- الگوریتم DPO (Rafailov 2023): با محاسبات جبریِ فرم بسته، مرحلهی 2 و 3 را در یک تابع زیان نظارتشدهی واحد روی دادههای ترجیحی ادغام میکند. بدون مدل پاداش و بدون PPO. کیفیت روی بنچمارکهای همسوسازی یکسان است، آن هم با کسری از هزینهی محاسباتی. در فاز 10 · درس 08 به آن میپردازیم.
- الگوریتم GRPO (DeepSeek 2024–2025): روش PPO با یک خط مبنای نسبی گروهی بهجای مدل منتقد (critic)، که در آن پاداش از یک وارسگر (verifier) میآید (اجرای کد / مطابقت جواب ریاضی)، نه از مدل پاداشِ آموزشدیده با انسان. رویکرد غالب برای مدلهای استدلالگر. در فاز 9 · درس 12 بررسی میشود.
- مدلهای پاداش فرآیندی (PRMs): راهحلهای ناتمام (هر گام استدلال) را امتیازدهی میکنند و در انواع مختلف RLHF و GRPO برای مسائل استدلالی به کار میروند.
- هوش مصنوعی قانونمحور (Constitutional AI) / روش RLAIF: استفاده از یک مدل زبانی همسوشده بهجای انسان برای تولید ترجیحات؛ روشی که بودجهی جمعآوری ترجیحات را مقیاسپذیر میکند.
پیادهسازی
در این درس از «پرامپتها» و «پاسخهای» ساختگی و بسیار کوچک در قالب رشتههای متنی استفاده میکنیم. مدل پاداش، یک امتیازدهندهی خطی روی نمایش کیسهتوکنها (bag-of-tokens) است. مدل زبانی واقعی در کار نیست — ساختار کلی پایپلاین مهم است، نه ابعاد و مقیاس آن. فایل code/main.py را ببینید.
گام 1: دادههای ترجیحی ساختگی
PROMPTS = ["help me", "answer me", "explain this"]
GOOD_WORDS = {"clear", "specific", "kind", "thorough"}
BAD_WORDS = {"vague", "rude", "wrong", "short"}

def make_pair(rng):
    x = rng.choice(PROMPTS)
    y_good = rng.choice(list(GOOD_WORDS)) + " " + rng.choice(list(GOOD_WORDS))
    y_bad = rng.choice(list(BAD_WORDS)) + " " + rng.choice(list(BAD_WORDS))
    return (x, y_good, y_bad)
در RLHF واقعی، برچسبزنهای انسانی جایگزین این بخش میشوند. ساختار داده — (prompt, preferred_response, rejected_response) — کاملاً یکسان است.
گام 2: مدل پاداش بردلی-تری
امتیاز خطی: R(x, y) = w · bag(y). مدل را طوری آموزش دهید که تابع زیانِ لگاریتمی جفتی بردلی-تری را کمینه کند:
def rm_train_step(w, x, y_pos, y_neg, lr):
    r_pos = dot(w, bag(y_pos))
    r_neg = dot(w, bag(y_neg))
    p = sigmoid(r_pos - r_neg)
    for tok, cnt in bag(y_pos).items():
        w[tok] += lr * (1 - p) * cnt
    for tok, cnt in bag(y_neg).items():
        w[tok] -= lr * (1 - p) * cnt
پس از چند صد بهروزرسانی، w وزنهای مثبت را به توکنهای کلمات خوب و وزنهای منفی را به کلمات بد اختصاص میدهد.
گام 3: خطمشی شبهPPO بر فراز مدل پاداش
خطمشی سادهی ما یک توکن منفرد از دایرهی واژگان تولید میکند. توکن را با مدل پاداش امتیازدهی میکنیم، را محاسبه میکنیم، جریمهی واگرایی KL نسبت به مرجع را اضافه میکنیم و تابع هدف جانشینِ بریدهشدهی (clipped surrogate) PPO را اعمال میکنیم.
def rlhf_step(theta, ref, w, prompt, rng, eps=0.2, beta=0.1, lr=0.05):
logits_theta = policy_logits(theta, prompt)
probs = softmax(logits_theta)
token = sample(probs, rng)
logits_ref = policy_logits(ref, prompt)
probs_ref = softmax(logits_ref)
reward = dot(w, bag([token])) - beta * kl(probs, probs_ref)
# بهروزرسانی به سبک PPO روی theta، با در نظر گرفتن reward به عنوان بازده (return)
...گام 4: پایش واگرایی KL
میانگین را در هر بهروزرسانی زیر نظر بگیرید. اگر این مقدار از حدود 5-10 بیشتر شود (واگرایی KL به ازای هر پاسخ بر حسب نات، جمعشده روی توکنها، که همان واحد ثبت گزارش در TRL است)، یعنی خطمشی از فاصله گرفته است: یا خیلی پایین است (باید آن را بالا ببرید تا مدل را به جای قبلی بکشد) یا هک پاداش آغاز شده است. این مهمترین شاخص ارزیابی در RLHF واقعی است.
گام 5: دستورالعمل عملیاتی با TRL
وقتی پایپلاین ساده را درک کردید، در ادامه همان حلقه را آنطور که یک توسعهدهنده با کتابخانههای واقعی مینویسد پیاده میکنیم. کتابخانهی TRL از Hugging Face پیادهسازی مرجع به حساب میآید — کلاس RewardTrainer برای مرحلهی 2 و PPOTrainer (با جریمهی درونی KL نسبت به مرجع) برای مرحلهی 3.
# مرحله 2: مدل پاداش از ترجیحات جفتی
from trl import RewardTrainer, RewardConfig
from transformers import AutoModelForSequenceClassification, AutoTokenizer

tok = AutoTokenizer.from_pretrained("meta-llama/Llama-3.1-8B-Instruct")
rm = AutoModelForSequenceClassification.from_pretrained(
    "meta-llama/Llama-3.1-8B-Instruct", num_labels=1
)

# dataset rows: {"prompt", "chosen", "rejected"} — Bradley-Terry format
trainer = RewardTrainer(
    model=rm,
    tokenizer=tok,
    train_dataset=preference_data,
    args=RewardConfig(output_dir="./rm", num_train_epochs=1, learning_rate=1e-5),
)
trainer.train()
# مرحله 3: اجرای PPO در برابر RM با جریمه KL نسبت به مدل مرجع SFT
from trl import PPOTrainer, PPOConfig, AutoModelForCausalLMWithValueHead
policy = AutoModelForCausalLMWithValueHead.from_pretrained("./sft-checkpoint")
ref = AutoModelForCausalLMWithValueHead.from_pretrained("./sft-checkpoint") # frozen
ppo = PPOTrainer(
config=PPOConfig(learning_rate=1.41e-5, batch_size=64, init_kl_coef=0.05,
target_kl=6.0, adap_kl_ctrl=True),
model=policy, ref_model=ref, tokenizer=tok,
)
for batch in dataloader:
responses = ppo.generate(batch["query_ids"], max_new_tokens=128)
rewards = rm(torch.cat([batch["query_ids"], responses], dim=-1)).logits[:, 0]
stats = ppo.step(batch["query_ids"], responses, rewards)
# شامل این آمارها است: mean_kl ،clip_frac ،value_loss — سه معیار تشخیصی PPOسه کاری که کتابخانه برایتان انجام میدهد: گزینهی adap_kl_ctrl=True برنامهی زمانبندی تطبیقی β را پیاده میکند؛ اگر KL مشاهدهشده از target_kl بیشتر شود، β دو برابر میشود؛ اگر به کمتر از نصف برسد، β نصف میشود. مدل مرجع طبق قرارداد فریز است — نباید تصادفاً پارامترهای مشترکی با policy داشته باشد. سر ارزش (value head) نیز روی همان بکبون خطمشی قرار میگیرد (AutoModelForCausalLMWithValueHead یک سر MLP اسکالر وصل میکند)، و دقیقاً به همین دلیل TRL معیارهای policy/kl و value/loss را جداگانه گزارش میدهد.
تلهها و خطاهای رایج
- بهینهسازی بیشازحد / هک پاداش. مدل پاداش بینقص نیست؛ خروجیهای متخاصمانهای (adversarial) پیدا میکند که امتیاز بالایی میگیرند اما در عمل بیکیفیت هستند. نشانهها: پاداش مدام بالا میرود ولی نمرهی ارزیابی انسانی ثابت میماند یا افت میکند. راهحل: توقف زودهنگام (early stopping)، بالا بردن ، و تنوعبخشی به دادههای آموزش مدل پاداش.
- هک طول متن (Length hacking). مدلهای پاداشی که روی پاسخهای مفید آموزش میبینند، اغلب به شکل ضمنی به پاسخهای بلندتر پاداش میدهند. در نتیجه خطمشی یاد میگیرد پاسخها را بیهوده کش بدهد. راهکار: پاداش نرمالشده بر اساس طول، یا RLAIF با یک مدل پاداشِ آگاه به طول متن.
- کوچک بودن بیش از حد مدل پاداش. مدل پاداش باید حداقل هماندازهی خطمشی باشد. یک مدل پاداش کوچک نمیتواند خروجیهای خطمشی را بهدرستی ارزیابی کند.
- تنظیم جریمهی KL. مقدار خیلی کم β منجر به انحراف مدل و هک پاداش میشود. مقدار خیلی زیاد β باعث میشود خطمشی عملاً تغییر نکند. راهکار استاندارد، استفاده از یک β تطبیقی است که مقدار ثابتی از KL را در هر گام هدف میگیرد.
- نویز دادههای ترجیحی. حدود 30% از برچسبهای انسانی دارای نویز یا ابهام هستند. مدل پاداش را روی دادههایی آموزش دهید که برچسبزنها بر سر آنها توافق داشتهاند، یا از یک پارامتر دما (temperature) در رابطهی بردلی-تری استفاده کنید تا مدل کالیبره شود.
- مشکلات دادههای خارج از خطمشی (Off-policy). دادههای PPO بعد از اولین دور (epoch) کمی از توزیع خطمشی جاری فاصله میگیرند. نسبت برش (clip fraction) را مطابق درس 08 پایش کنید.
کاربردها در دنیای واقعی
در سال 2026 رویکرد RLHF بهصورت لایهبندیشده به کار میرود:
| لایه | هدف | روش |
|---|---|---|
| پیروی از دستورات، مفید بودن، بیضرر بودن | همسوسازی (Alignment) | ترجیح روش DPO (فاز 10 · درس 08) به RLHF-PPO. |
| درستی استدلال (ریاضی، کدنویسی) | توانمندی (Capability) | روش GRPO با پاداش وارسگر (فاز 9 · درس 12). |
| وظایف چندمرحلهای با افق بلند | ایجنتی (Agentic) | استفاده از PPO / GRPO همراه با مدلهای پاداش فرآیندی روی تکتک گامها. |
| ایمنی / رفتار امتناع | ایمنی | روش RLHF-PPO با مدل پاداشِ ایمنی مجزا، یا Constitutional AI. |
| استراتژی Best-of-N در زمان استنتاج | همسوسازی سریع | استفاده از مدل پاداش در زمان دیکود؛ بدون نیاز به آموزش خطمشی. |
| تقطیر پاداش (Reward distillation) | توان پردازشی استنتاج | آموزش یک «سر پاداش» کوچک روی یک مدل زبانی فریزشده. |
روش RLHF روش اصلی و بنیادین در سالهای 2022 تا 2024 بود. در سال 2026، پایپلاینهای عملیاتی همسوسازی در وهلهی اول سراغ DPO میروند و PPO را فقط برای مراحل متکی بر مدلهای پاداش پیچیده یا مراحل حساس به ایمنی نگه میدارند.
تحویل نهایی
این خروجی را در فایل outputs/skill-rlhf-architect.md ذخیره کنید:
---
name: rlhf-architect
description: Design an RLHF / DPO / GRPO alignment pipeline for a language model, including RM, KL, and data strategy.
version: 1.0.0
phase: 9
lesson: 9
tags: [rl, rlhf, alignment, llm]
---

Given a base LM, a target behavior (alignment / reasoning / refusal / agent), and a preference or verifier budget, output:

1. Stage. SFT? RM? DPO? GRPO? With justification.
2. Preference or verifier source. Humans, AI feedback, rule-based, unit-test-pass, or reward distillation.
3. KL strategy. Fixed β, adaptive β, or DPO (implicit KL).
4. Diagnostics. Mean KL, reward stability, over-optimization guard (holdout human eval).
5. Safety gate. Red-team set, refusal rate, safety RM separate from helpfulness RM.

Refuse to ship RLHF-PPO without a KL monitor. Refuse to use an RM smaller than the target policy. Refuse length-only rewards. Flag any pipeline that does not hold back a blind human-eval set as lacking over-optimization protection.تمرینها
- ساده. مدل پاداش بردلی-تری را در
code/main.pyروی 500 جفت دادهی ترجیحی ساختگی آموزش دهید. دقت ترجیحات جفتی را روی 100 جفت دادهی ارزیابی (held-out) بسنجید. این دقت باید بالای 90% باشد. - متوسط. حلقهی PPO-RLHF ساده را با مقادیر مختلف اجرا کنید. برای هر کدام، نمودار امتیاز مدل پاداش را در برابر واگرایی KL نسبت به مرجع در طول بهروزرسانیها رسم کنید. کدام اجراها دچار هک پاداش میشوند؟
- سخت. الگوریتم DPO (تابع زیان درستنماییِ ترجیح با فرم بسته) را روی همان دادههای ترجیحی پیادهسازی کنید و از نظر میزان مصرف منابع پردازشی و امتیاز نهایی مدل پاداش، آن را با پایپلاین RLHF-PPO مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها چه میگویند | معنای دقیق فنی |
|---|---|---|
| RLHF | «یادگیری تقویتی برای همسوسازی» | پایپلاین سهمرحلهای SFT + RM + PPO (Christiano 2017, Ouyang 2022). |
| مدل پاداش (Reward Model - RM) | «شبکهی امتیازدهی» | تابع اسکالر آموزشدیده که با رابطهی بردلی-تری روی ترجیحات جفتی برازش میشود. |
| بردلی-تری (Bradley-Terry) | «تابع زیان لجستیک جفتی» | رابطهی ؛ تابع هدف استاندارد مدل پاداش. |
| جریمهی واگرایی KL | «نزدیک ماندن به مدل مرجع» | عبارت در تابع پاداش؛ تنظیمکنندهای برای مقابله با هک پاداش. |
| هک پاداش (Reward hacking) | «قانون گودهارت» | سوءاستفادهی خطمشی از نقاط ضعف مدل پاداش؛ نشانه: رشد پاداش همراه با ثبات یا افت ارزیابی انسانی. |
| روش RLAIF | «ترجیحات برچسبخورده با هوش مصنوعی» | روش RLHF که در آن برچسبها بهجای انسان از یک مدل زبانی دیگر گرفته میشوند. |
| مدل PRM | «مدل پاداش فرآیندی» | مدلی که به گامهای میانی استدلال امتیاز میدهد؛ کاربردی در پایپلاینهای استدلالی. |
| روش Constitutional AI | «روش انتروپیک» | ترجیحات تولیدشده با مدلهای زبانی که بر اساس قواعد و اصول صریح هدایت میشوند. |
برای مطالعهی بیشتر
- Christiano et al. (2017). Deep Reinforcement Learning from Human Preferences — مقالهای که جرقهی RLHF را زد.
- Ouyang et al. (2022). InstructGPT — Training language models to follow instructions with human feedback — دستورالعمل اصلی توسعهی ChatGPT.
- Stiennon et al. (2020). Learning to summarize with human feedback — کارهای اولیهی RLHF برای خلاصهسازی متن.
- Rafailov et al. (2023). Direct Preference Optimization — مقالهی DPO؛ گزینهی پیشفرض پس از RLHF در سال 2026.
- Bai et al. (2022). Constitutional AI: Harmlessness from AI Feedback — روش RLAIF و حلقهی خودانتقادی (self-critique).
- Anthropic RLHF paper (Bai et al. 2022). Training a Helpful and Harmless Assistant — مقالهی دستیار مفید و بیضرر (HH).
- Hugging Face TRL library — کتابخانهی اصلی شامل
RewardTrainerوPPOTrainer. سورس ترینر را برای دیدن جزئیات KL تطبیقی و سر ارزش مطالعه کنید. - Hugging Face — Illustrating Reinforcement Learning from Human Feedback به قلم Lambert, Castricato, von Werra, Havrilla — راهنمای جامع و مرجع برای پایپلاین سهمرحلهای همراه با تصاویر.
- von Werra et al. (2020). TRL: Transformer Reinforcement Learning — مخزن کتابخانه؛ در پوشهی
examples/اسکریپتهای کامل RLHF برای مدلهای Llama، Mistral و Qwen در دسترس است. - Sutton & Barto (2018). Ch. 17.4 — Designing Reward Signals — نگاهی به فرضیهی پاداش؛ پیشنیازی بنیادین برای درک پدیدهی هک پاداش.