
تولید تصویر با دیفیوژن سالهاست که به پایداری رسیده، اما تعمیم آن به ویدیو با مانعی جدی روبرو بود: یک ویدیوی کوتاه 10 ثانیهای بیش از 1.5 گیگابایت دادهی خام پیکسلی تولید میکند و پردازش مستقیم آن در کارتهای گرافیک ناممکن است. برای مهندسان هوش مصنوعی، چالش اصلی تنها ساخت پیکسلهای چشمنواز نیست؛ حفظ پیوستگی نوری، فیزیک اشیا در طول زمان و مدیریت مصرف حافظه در ابعاد زمانی و مکانی گلوگاههای اصلی این مسیر هستند.
در این درس یاد میگیرید که چگونه معماری ترنسفورمرهای دیفیوژن (DiT) همراه با انکودرهای ویدیویی 3D VAE حجم داده را فشرده کرده و ویدیو را بهصورت پچهای مکانی-زمانی پردازش میکنند. همچنین علت پدیدهی پرش تصویر (Flicker) در نمونهبرداریهای مجزا و سازوکار اتنشن تجزیهشده (Factorized Attention) برای غلبه بر محدودیتهای محاسباتی را با کد خالص بررسی خواهیم کرد.
توجه داشته باشید که آموزش و حتی استنتاج مدلهای وزنباز سنگین مانند CogVideoX یا HunyuanVideo به منابع پردازشی قدرتمندی نیاز دارد. با توجه به اینکه اجارهی GPUهای ابری خارجی برای کاربران داخل ایران به دلیل عدم دسترسی مستقیم به پرداخت ارزی چالشبرانگیز است، بخش عملی این درس با پایتون خالص و بدون نیاز به سختافزار سنگین طراحی شده تا منطق الگوریتم را روی سیستم شخصی درک کنید؛ اجرای مدلهای بزرگتر معمولاً به تکنیکهای کوانتیزهسازی یا استفاده از سیستمهای مجهز به شتابدهندههای محلی متکی است.
تصویر یک تنسور 2-بعدی است؛ ویدیو یک تنسور 3-بعدی. مبانی نظری یکسان است، اما بار محاسباتی 10 تا 100 برابر سنگینتر میشود. مدل Sora از شرکت OpenAI در فوریه 2024 امکانپذیر بودن آن را اثبات کرد. تا سال 2026، مدلهای Veo 2 ،Kling 1.5 ،Runway Gen-3 ،Pika 2.0 و WAN 2.2 ویدیوهای تجاری و نهایی را بر اساس متن با وضوح 1080p تولید میکنند — و مجموعهمدلهای با وزن باز (CogVideoX ،HunyuanVideo ،Mochi-1 و WAN 2.2) حدود 12 ماه عقبتر از آنها حرکت میکنند.
صورت مسئله
یک ویدیوی 10 ثانیهای 1080p با نرخ 24 فریم بر ثانیه، شامل 240 فریم با ابعاد 3×1080×1920 پیکسل است. این حجم، یعنی حدود 1.5 گیگابایت دادهی خام برای هر کلیپ. اعمال دیفیوژن در فضای پیکسل (Pixel-space) عملاً غیرممکن است. شما به موارد زیر نیاز دارید:
- فشردهسازی مکانی-زمانی (Spatiotemporal compression): یک VAE که بهجای تکتک فریمها، کل ویدیو را به توالی مشخصی از پچهای (patch) مکانی-زمانی انکود کند.
- پیوستگی زمانی (Temporal coherence): محتوا، نورپردازی و هویت اشیا باید در طول چند ثانیه بین فریمها حفظ شوند. شبکه باید حرکت را مدلسازی کند.
- بودجهی محاسباتی: آموزش مدل ویدیو در مقایسه با تصویر و در اندازهی مدل مشابه، 10 تا 100 برابر پرهزینهتر است.
- شرطیسازی (Conditioning): متن، تصویر (فریم اول)، صدا، یا ویدیویی دیگر. بیشتر مدلهای پروداکشن هر چهار ورودی را میپذیرند.
معماری موفقی که این چالش را حل کرد، ترنسفورمر دیفیوژن (DiT) روی پچهای مکانی-زمانی بود که روی دیتاستهای عظیم شامل (پرامپت، کپشن، ویدیو) آموزش دیده است. تابع زیان (loss) دیفیوژن در اینجا دقیقاً همان تابع درس 06 است.
مبانی نظری
تبدیل به پچ (Patchify)
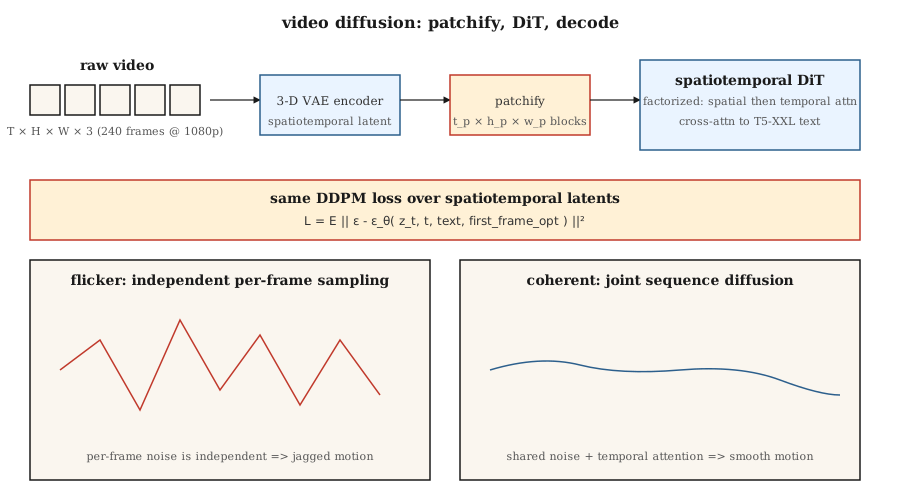
ویدیو را با یک 3D VAE (فشردهسازی مکانی-زمانیِ یادگرفتهشده) انکود کنید. لیتنت حاصل دارای ابعاد [T_latent, H_latent, W_latent, C_latent] خواهد بود. سپس آن را به پچهایی با اندازهی [t_p, h_p, w_p] تقسیم کنید. در مدلهای مشابه Sora، مقدار t_p = 1 (پچهای مجزا برای هر فریم) یا t_p = 2 (هر دو فریم یک پچ) در نظر گرفته میشود. یک ویدیوی 10 ثانیهای 1080p در نهایت به حدود 20,000 تا 100,000 پچ فشرده میشود.
مدل DiT مکانی-زمانی
یک ترنسفورمر توالی مسطح پچها را پردازش میکند. هر پچ دارای یک امبدینگ مکانی (Positional Embedding) 3-بعدی (زمان + y + x) است. اتنشن معمولاً بهصورت تجزیهشده (factorized) پیادهسازی میشود:
- اتنشن مکانی (Spatial attention) میان پچهای داخل هر فریم.
- اتنشن زمانی (Temporal attention) در امتداد فریمهای مختلف برای یک موقعیت مکانی یکسان.
- اتنشن 3-بعدی کامل (Full 3D attention) بین 16 تا 100 برابر سنگینتر است و تنها در وضوحهای پایین یا کارهای پژوهشی استفاده میشود.
شرطیسازی متنی
این کار از طریق کراساتنشن (Cross-Attention) با یک انکودر متنی بزرگ انجام میشود (T5-XXL برای Sora؛ مدل CogVideoX-5B نیز از T5-XXL استفاده میکند). پرامپتهای طولانی نقشی کلیدی دارند — مجموعهی آموزشی Sora شامل بازکپشننویسیهای متراکمِ تولیدشده با GPT با میانگین 200 توکن برای هر کلیپ بود.
آموزش
تابع زیان استاندارد دیفیوژن (پیشبینی ε یا v) روی لیتنتهای مکانی-زمانی اعمال میشود. دادهها شامل ویدیوهای وب + حدود 100 میلیون کلیپ پالایششده + کپشنهای متنی سینتتیک است. توان محاسباتی مورد نیاز: بیش از 10,000 ساعت GPU حتی برای یک آزمایش پژوهشی کوچک؛ مقیاس مدلی مانند Sora به بیش از 100,000 ساعت میرسد.
چشمانداز مدلهای عملیاتی در سال 2026
| مدل | تاریخ | حداکثر زمان | حداکثر وضوح | وزنهای باز؟ | ویژگی برجسته |
|---|---|---|---|---|---|
| Sora (OpenAI) | 2024-02 | 60 ثانیه | 1080p | خیر | اولین مدلی که ویژگیهای شبیهساز جهان را در مقیاس بالا نشان داد |
| Sora Turbo | 2024-12 | 20 ثانیه | 1080p | خیر | نسخهی تجاری Sora با استنتاج 5 برابر سریعتر |
| Veo 2 (Google) | 2024-12 | 8 ثانیه | 4K | خیر | بالاترین کیفیت و درک فیزیک در سال 2025 |
| Veo 3 | 2025 سه ماهه سوم | 15 ثانیه | 4K | خیر | پشتیبانی ذاتی از صدا و کنترل دقیقتر دوربین |
| Kling 1.5 / 2.1 (Kuaishou) | 2024-2025 | 10 ثانیه | 1080p | خیر | بهترین بازنمایی حرکات بدن انسان در اوایل 2025 |
| Runway Gen-3 Alpha | 2024-06 | 10 ثانیه | 768p | خیر | همراه با ابزارهای حرفهای تدوین ویدیو |
| Pika 2.0 | 2024-10 | 5 ثانیه | 1080p | خیر | بیشترین ثبات و یکدستی در حفظ کاراکتر |
| CogVideoX (THUDM) | 2024 | 10 ثانیه | 720p | بله (2B، 5B) | اولین مدل باز در مقیاس 5 میلیارد پارامتر |
| HunyuanVideo (Tencent) | 2024-12 | 5 ثانیه | 720p | بله (13B) | پیشرفتهترین مدل وزنباز در اواخر 2024 |
| Mochi-1 (Genmo) | 2024-10 | 5.4 ثانیه | 480p | بله (10B) | آزادترین مجوز استفاده (Permissive) |
| WAN 2.2 (Alibaba) | 2025-07 | 5 ثانیه | 720p | بله | قدرتمندترین مدل وزنباز در اواسط 2025 |
مدلهای دارای وزن باز با سرعتی بیشتر از حوزهی تصویر در حال کم کردن فاصلهی خود هستند: ترکیب HunyuanVideo و LoRAهای WAN 2.2 تا اواسط سال 2026 پایهی بیشتر گردشکارهای متنباز را شکل دادهاند.
پیادهسازی از صفر
اسکریپت code/main.py ایدهی اصلی DiT مکانی-زمانی را شبیهسازی میکند: تبدیل یک ویدیوی سینتتیک کوچک به پچ، افزودن امبدینگ مکانی به هر پچ، و حذف نویز از کل توالی با استفاده از مکانیزم اتنشن ترنسفورمری روی پچها. بدون استفاده از numpy و صرفاً با پایتون خالص. در اینجا نشان میدهیم که حتی در حالت 1-بعدی نیز، وقتی پچهای فریمهای مجاور از نویززدا (denoiser) و امبدینگهای مکانی مشترک استفاده میکنند، پیوستگی زمانی پدیدار میشود.
گام 1: پچبندی یک «ویدیوی» 1-بعدی سینتتیک
def make_video(T_frames=8, rng=None):
# یک «ویدیو» دنبالهای از مقادیر 1 بعدی است که مسیری هموار را دنبال میکنند
base = rng.gauss(0, 1)
return [base + 0.3 * t + rng.gauss(0, 0.1) for t in range(T_frames)]گام 2: امبدینگ مکانی برای هر فریم
def pos_embed(t, dim):
    return sinusoidal(t, dim)
گام 3: مشاهدهی کل توالی توسط نویززدا
شبکهی کوچک ما بهجای حذف نویز هر فریم بهشکل مستقل، مقادیر تمام فریمها را بههمراه امبدینگ مکانی آنها به هم متصل (concatenate) کرده و نویز همهی فریمها را بهصورت همزمان پیشبینی میکند.
گام 4: سنجش پیوستگی زمانی
پس از آموزش، یک ویدیو نمونهبرداری کنید. میزان اختلاف (دلتا) فریمبهفریم را بسنجید. اگر مدل ساختار زمانی را یاد گرفته باشد، این دلتاها کوچکتر از حالتی خواهند ماند که هر فریم بهطور مستقل نمونهبرداری شود.
دامها و خطاهای رایج
- نمونهبرداری مستقل برای هر فریم = پرش تصویر (Flicker). اگر دیفیوژن تصویر را روی تکتک فریمها بهطور جداگانه اجرا کنید، تصویر چشمک میزند؛ چون نویز هر فریم مستقل است. مدلهای دیفیوژن ویدیو این مشکل را با پیوند زدن فریمها از طریق اتنشن یا نویز مشترک برطرف میکنند.
- اتنشن 3-بعدی سادهانگارانه = خطای کمبود حافظه (OOM). اجرای اتنشن 3-بعدی کامل روی لیتنت یک ویدیوی 10 ثانیهای 1080p به صدها میلیارد عملیات نیاز دارد. اتنشن را به دو بخش مکانی و زمانی تجزیه کنید.
- کپشننویسی دادهها مهمتر از حجم داده است. مزیت اصلی Sora نسبت به کارهای پیشین (Prior)، آموزش روی کپشنهایی با جزئیات حدوداً 10 برابری بود (کلیپهایی که با GPT-4 دوباره برچسبگذاری شدند). گزارش فنی OpenAI صراحتاً به این موضوع اشاره دارد.
- شرطیسازی با فریم اول. بیشتر مدلهای پروداکشن یک تصویر را نیز بهعنوان فریم اول قبول میکنند. این همان حالت «تصویر به ویدیو» (image-to-video) است و در فرآیند آموزش گنجانده میشود.
- انحراف فیزیک (Physics drift). در کلیپهای طولانی (بیش از 10 ثانیه)، ناسازگاریهای جزئی روی هم انباشته میشوند. استفاده از تولید مبتنی بر پنجرهی لغزان (sliding-window) بههمراه تثبیت فریمهای کلیدی (keyframe anchoring) به حل این مشکل کمک میکند.
استفاده از ابزارهای واقعی
| مورد کاربرد | گزینهی برتر 2026 |
|---|---|
| متن به ویدیو با بالاترین کیفیت، سرویس ابری | Veo 3 یا Sora |
| صحنههای سینمایی با کنترل حرکات دوربین | Runway Gen-3 با motion brush |
| ثبات چهره و کاراکتر در چندین کلیپ | Pika 2.0 یا Kling 2.1 |
| وزنهای باز با امکان فاینتیون سریع | WAN 2.2 + LoRA |
| تصویر به ویدیو | WAN 2.2-I2V یا Kling 2.1 I2V یا Runway |
| همگامسازی لب با صدا (Lip sync) | Veo 3 (صدای ذاتی) یا مدلی اختصاصی برای هماهنگی لب |
| ویرایش ویدیو | Runway Act-Two یا Kling Motion Brush یا Flux-Kontext (فریم ثابت) |
هزینهی تولید هر ثانیه ویدیو با کیفیت یکسان، بین سالهای 2024 تا 2026 حدود 20 برابر کاهش یافته است.
خروجی این درس
فایل outputs/skill-video-brief.md را ذخیره کنید. این مهارت، یک بریف ویدیویی را (شامل مدتزمان، نسبت ابعاد (Aspect ratio)، سبک، برنامهی دوربین، ثبات سوژه و صدا) دریافت میکند و موارد زیر را تحویل میدهد: مدل و بستر میزبانی، ساختاربندی پرامپت (اصطلاحات فیلمبرداری، توصیف سوژه، توصیفگرهای حرکتی)، سید (seed) بههمراه پروتکل بازتولیدپذیری (Reproducibility)، و یک چکلیست ارزیابی کیفی فریمبهفریم.
تمرینها
- ساده. در
code/main.py، اختلاف فریمبهفریم را برای دو حالت مقایسه کنید: (الف) نمونهبرداری مستقل برای هر فریم، (ب) نمونهبرداری مشترک کل توالی. میانگین و واریانس دلتاها را گزارش دهید. - متوسط. یک شرط فریم اول اضافه کنید: مقدار فریم 0 را روی مقداری مشخص قفل کنید و باقی فریمها را نمونهبرداری نمایید. بررسی کنید که این مقدارِ قفلشده چگونه در طول فریمها منتشر میشود.
- پیشرفته. با استفاده از diffusers هاگینگفیس، مدل CogVideoX-2B را روی یک GPU محلی اجرا کنید. زمان لازم برای 20 گام استنتاج با وضوح 720p برای یک کلیپ 6 ثانیهای را بسنجید. اتنشن مکانی-زمانی را پروفایل کنید تا گلوگاه سیستم مشخص شود.
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای دقیق فنی |
|---|---|---|
| Video VAE | «3D VAE» | انکودری که ابعاد (T, H, W, C) را به لیتنت مکانی-زمانی فشرده میکند. |
| Patches | «توکنها» | بلوکهای 3-بعدی با اندازهی ثابت از فضای لیتنت؛ ورودی مدل DiT. |
| Factorized attention | «مکانی + زمانی» | اجرای اتنشن روی فضا و سپس روی زمان؛ صرفنظر کردن از اتنشن کامل 3-بعدی. |
| Image-to-video (I2V) | «متحرک کردن عکس» | دریافت تصویر + متن توسط مدل و تولید ویدیویی که با آن عکس شروع میشود. |
| Keyframe conditioning | «فریمهای لنگر» | قفل کردن فریمهایی مشخص برای کنترل مسیر و خط روایی ویدیو. |
| Motion brush | «راهنمای جهت حرکت» | ورودی رابط کاربری که در آن کاربر بردارهای حرکتی را روی تصویر نقاشی میکند. |
| Re-captioning | «کپشنهای متراکم» | استفاده از LLM برای برچسبگذاری مجدد ویدیوهای آموزشی با پرامپتهای پرجزئیات. |
| Flicker | «آرتیفکت زمانی» | ناهماهنگی بین فریمهای متوالی؛ با نویززدایی جفتشده (coupled) برطرف میشود. |
نکتهی فنی عملیاتی: لیتنتهای ویدیو و چالش پهنای باند حافظه
یک کلیپ 10 ثانیهای 1080p با نرخ 24 فریم بر ثانیه شامل 240 فریم × 1920 × 1080 × 3 یعنی حدود 1.5 گیگابایت پیکسل خام است. پس از فشردهسازی 4 برابری با Video VAE (بهصورت 2 × مکانی × 2 × زمانی)، حجم لیتنت به حدود 100 مگابایت به ازای هر درخواست میرسد. پردازش این حجم در یک DiT مکانی-زمانی طی 30 گام با بچ 1، به جابهجایی حدود 3 گیگابایت داده در هر گام در حافظهی HBM نیاز دارد — در اینجا گلوگاه اصلی، پهنای باند حافظه است نه توان محاسباتی (FLOPs).
سه اهرم تنظیم در محیطهای عملیاتی که همگی مستقیماً از مباحث استنتاج در مقیاس پروداکشن میآیند:
- موازیسازی تنسوری (TP) در طول DiT: مدلهای متن به ویدیو معمولاً بیشتر از 10 میلیارد پارامتر دارند. پیکربندی TP=4 روی 4 کارت H100 یک استاندارد رایج است؛ برای مدلهای ردهی 405 میلیارد پارامتر نیز از ترکیب PP=2 × TP=2 استفاده میشود. تاخیر (Latency) هر گام استنتاج تقریباً تا رسیدن به دیوار All-Reduce، بهشکل خطی با افزایش TP کاهش مییابد.
- بچبندی فریمها = بچبندی پیوسته (Continuous batching): ویدیو در مرحلهی تولید، ساختاری مشابه یک بچ از فریمهای متصلبههم از طریق اتنشن دارد. در صورتی که معماری مدل اجازهی تولید با پنجرهی لغزان را بدهد، تکنیک بچبندی پیوسته (زمانبندی در حین پرواز یا in-flight) قابل استفاده است: یعنی رندر فریم
t+1همزمان با بازگرداندن فریمt-1آغاز شود. - کش Prefill در سطح کلیپ: در حالت تصویر به ویدیو، شرطیسازی فریم اول مشابه مرحلهی Prefill پرامپت در یک مدل زبانی است: آن را یکبار محاسبه کرده و در تمام مراحل زمانی دیکودر بازاستفاده کنید. این سازوکار در عمل همان KV-Cache برای ویدیو است.
برای مطالعهی بیشتر
- Brooks et al. (2024). Video generation models as world simulators — گزارش فنی مدل Sora.
- Yang et al. (2024). CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer — مقالهی مدل CogVideoX.
- Kong et al. (2024). HunyuanVideo: A Systematic Framework for Large Video Generative Models — مقالهی مدل HunyuanVideo.
- Genmo (2024). Mochi 1 preview model card — مستندات مدل Mochi-1.
- Alibaba (2025). WAN 2.2 — پیشرفتهترین مدل وزنباز در اواسط 2025.
- Ho, Salimans, Gritsenko et al. (2022). Video Diffusion Models — مقالهی بنیادین حوزهی دیفیوژن ویدیو.
- Blattmann et al. (2023). Align your Latents (Video LDM) — پیشدرآمد مدل Stable Video Diffusion.