
در توسعهی مدلهای تولید تصویر (Text-to-Image)، دستیابی به نتایج چشمنواز روی چند نمونهی انگشتشمار کافی نیست. مقایسهی مدلها و سنجش پیشرفت واقعی آنها نیازمند ارزیابیهای آماری دقیق بر پایهی دهها هزار تصویر است. با این حال، معیارهای معروفی مانند FID یا امتیاز CLIP نقاطضعف و حالتهای شکست خاص خود را دارند که پژوهشگران میتوانند ناخواسته یا عمدی آنها را دور بزنند و گزارشهای کاذب بسازند.
اگر ندانید این معیارها در چه شرایطی دچار اریبی محاسباتی میشوند یا چگونه پرامپتها را به نفع مدل دستچین میکنند، تفکیک پیشرفت واقعی از نتایج فریبنده در لیدربوردها ناممکن خواهد بود. این درس سه رکن کلیدی ارزیابی مدرن شامل سنجش کیفیت توزیع (FID)، انطباق با پرامپت (امتیاز CLIP) و آزمونهای ترجیح انسانی (Elo) را به همراه روشهای عملی ترکیب آنها زیر ذرهبین قرار میدهد.
علاوه بر این، فرآیند ارزیابی بهخودیخود یک بار پردازشی سنگین است؛ زیرا محاسبهی FID به رندر دستکم 10,000 تصویر نیاز دارد. از آنجا که تهیه و اجارهی کارتهای گرافیک قدرتمند در سرویسهای ابری هزینهی زیادی به همراه دارد، استراتژیهایی مانند بچینگ ایستا، کش کردن بردار ویژگیهای مرجع و ارزیابی مرحلهبهمرحله برای مدیریت منابع و صرفهجویی در محاسبات ضروری است.
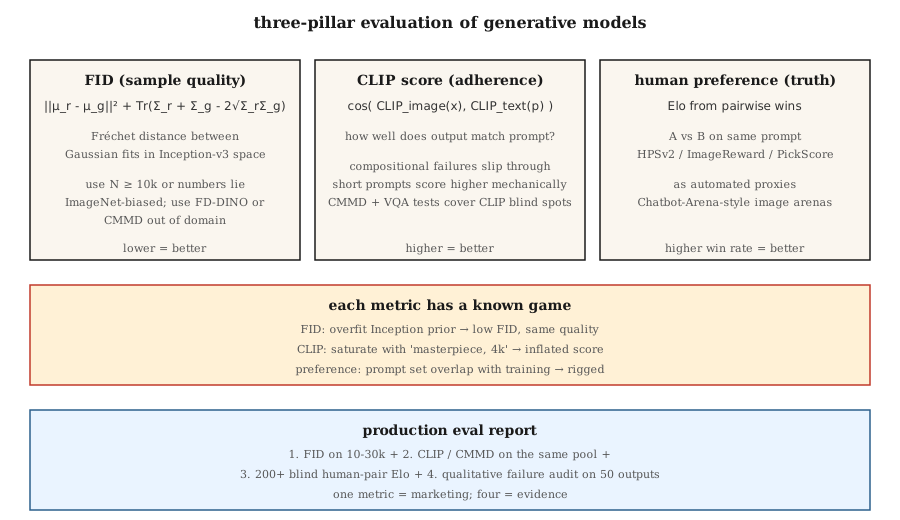
در لیدربورد تمام مدلهای زایشی (Generative models)، معیارهای FID، امتیاز CLIP و نرخ برد در آرنای ترجیحات انسانی خودنمایی میکنند. هر یک از این اعداد نقطهضعفی دارند که پژوهشگری مصمم میتواند با ترفندهایی آن را دور بزند (Game کند). اگر این حالتهای شکست را نشناسید، تفاوت یک پیشرفت واقعی را با نتیجهای دستکاریشده تشخیص نخواهید داد.
صورت مسئله
ارزیابی هر مدل زایشی بر دو پایه استوار است: کیفیت خروجی (Sample quality) و میزان انطباق با پرامپت (Conditioning adherence). هیچکدام فرم بسته (Closed-form) برای اندازهگیری ندارند. مدل شما باید 10,000 تصویر تولید کند؛ ابزاری باید به آنها عدد اختصاص دهد؛ و شما باید بتوانید به این اعداد در میان خانوادههای مختلف مدل، رزولوشنهای گوناگون و معماریهای متفاوت اعتماد کنید. در بازهی سالهای 2014 تا 2026، سه معیار توانستند از این آزمون دشوار جان سالم به در ببرند:
- معیار FID (فاصلهی فرشه اینسپشن یا Fréchet Inception Distance): فاصلهی بین دو توزیع — تصاویر واقعی و تولیدشده — در فضای ویژگی شبکهی Inception. مقدار کمتر نشاندهندهی عملکرد بهتر است.
- امتیاز CLIP (معیار CLIP score): شباهت کسینوسی (Cosine similarity) بین امبدینگ (Embedding) تصویر تولیدشده در CLIP و امبدینگ متنِ پرامپت (Prompt) در CLIP. مقدار بیشتر نشاندهندهی عملکرد بهتر است و میزان انطباق با پرامپت را میسنجد.
- ترجیح انسانی (Human preference): دو مدل را بر سر یک پرامپت یکسان رودرروی هم قرار دهید؛ از انسانها (یا مدلی در سطح GPT-4) بخواهید گزینهی برتر را انتخاب کنند، و نتایج را در قالب امتیاز Elo تجمیع کنید.
علاوه بر اینها با معیارهای دیگری چون IS (امتیاز اینسپشن، که تا حد زیادی منسوخ شده)، KID، CMMD، ImageReward، PickScore، HPSv2 و MJHQ-30k نیز روبهرو خواهید شد. هر یک از این معیارها برای اصلاح یکی از نقاطضعف معیارهای قبلی معرفی شدهاند.
مفهوم اصلی
معیار FID — کیفیت خروجی
مقاله هوسل و همکاران (2017). مراحل کار:
- استخراج ویژگیهای Inception-v3 (بردار 2048-بعدی) برای N تصویر واقعی و N تصویر تولیدشده.
- برازش یک توزیع گاوسی روی هر مجموعه: محاسبهی میانگین و کوواریانس .
- .
تحلیل: فاصلهی فرشه میان دو توزیع گاوسی چندمتغیره در فضای ویژگی. مقدار کمتر = توزیعهای مشابهتر.
حالتهای شکست (Failure modes):
- اریبی در N کوچک: از آنجا که FID از میانگین مربعات روی توزیع ویژگیها استفاده میکند، کوچک بودن N باعث تخمین کمتر از واقع کوواریانس میشود و مقدار FID را بهاشتباه پایین میآورد. همیشه از استفاده کنید.
- وابسته به Inception: شبکهی Inception-v3 روی دیتاست ImageNet آموزش دیده است. دامنههایی که فاصلهی زیادی با ImageNet دارند (مانند چهره، آثار هنری، تصاویر حاوی متن) مقادیر FID بیمعنایی تولید میکنند. در این سناریوها باید از استخراج ویژگی (Feature extraction) متناسب با همان دامنه استفاده کنید.
- دور زدن معیار (Gaming): بیشبرازش (Overfitting) روی پیشین (Prior) شبکهی Inception مقدار FID را کاهش میدهد، بدون اینکه کیفیت بصری تصاویر ذرهای بهتر شده باشد. راهکار غلبه بر این مشکل استفاده از CMMD است (در ادامه بررسی میشود).
امتیاز CLIP — انطباق با پرامپت
ردفورد و همکاران (2021). برای یک تصویر تولیدشده به همراه پرامپت آن:
clip_score = cos_sim( CLIP_image(x_gen), CLIP_text(prompt) )میانگینگیری روی 30 هزار تصویر تولیدشده ← یک عدد اسکالر به دست میدهد که میان مدلهای مختلف قابل مقایسه است.
حالتهای شکست:
- نقاط کور ذاتی CLIP: درک ترکیبی (Compositional reasoning) در شبکهی CLIP ضعیف است (مثلاً در پرامپت «یک مکعب قرمز روی یک کرهی آبی» اغلب دچار خطا میشود). بنابراین مدلها ممکن است بدون فهم و اجرای درست پرامپتهای پیچیده، رتبه (Rank) بالایی در امتیاز CLIP کسب کنند.
- اریبی به نفع پرامپتهای کوتاه: پرامپتهای کوتاه در وب جفتهای تصویری متناظر بیشتری دارند؛ از این رو پرامپتهای طولانیتر به دلایل محاسباتی همواره امتیاز CLIP کمتری میگیرند.
- ترفند زدن با پرامپت: گنجاندن عباراتی مانند «high quality, 4k, masterpiece» در پرامپت، امتیاز CLIP را به شکل کاذب بالا میبرد بدون اینکه پیوند معنایی تصویر و متن تقویت شده باشد.
معیار CMMD (جایاسومانا و همکاران، 2024) بخشی از این مشکلات را حل میکند: بهجای Inception از ویژگیهای CLIP، و بهجای فاصلهی فرشه از MMD (حداکثر اختلاف میانگین) بهره میبرد و تفاوتهای ظریف کیفی را دقیقتر شناسایی میکند.
ترجیح انسانی — دادهی واقعی نهایی
مجموعهای از پرامپتها را انتخاب کنید. خروجیها را با مدل A و مدل B بسازید. جفتتصاویر را به انسانها (یا یک مدل زبانی بزرگ توانمند در نقش داور) نشان دهید. بردها را به یک امتیاز Elo یا مدل بردلی-تری (Bradley-Terry) تبدیل کنید. بنچمارکهای مطرح:
- PartiPrompts (محصول گوگل): 1,600 پرامپت متنوع در 12 دستهبندی.
- HPSv2: شامل 107 هزار برچسبگذاری انسانی، که بهطور گسترده بهعنوان معیار جایگزین خودکار استفاده میشود.
- ImageReward: شامل 137 هزار جفت مقایسهای پرامپت-تصویر با مجوز MIT.
- PickScore: آموزشدیده روی 2.6 میلیون دادهی ترجیحی Pick-a-Pic.
- آرناهای تصویری مشابه Chatbot Arena: وبسایت https://imagearena.ai/ و موارد مشابه.
حالتهای شکست:
- واریانس در سلیقهی داوران: کاربران عادی ترجیحات متفاوتی نسبت به متخصصان دارند. باید از هر دو گروه کمک بگیرید.
- توزیع پرامپتها: دستچین کردن پرامپتها (Cherry-picking) به نفع یک خانوادهی خاص از مدلها تمام میشود. همیشه پرامپتهای استفادهشده را مستند کنید.
- هک پاداش در داوری مدلهای زبانی (Reward hacking): داوری مثل GPT-4 ممکن است فریب تصاویری را بخورد که صرفاً زیبا هستند اما با پرامپت همخوانی ندارند. نتایج هوش مصنوعی را با ارزیابی انسانی همپوشانی دهید.
ارزیابی ترکیبی در عمل
یک گزارش ارزیابی استاندارد در محیط پروداکشن باید شامل بخشهای زیر باشد:
- ارزیابی FID روی 10 تا 30 هزار نمونه در مقایسه با یک توزیع دادهی واقعی (Ground truth) نگهداشتهشده (کیفیت نمونه).
- ارزیابی امتیاز CLIP یا CMMD روی همان نمونهها در برابر پرامپتهایشان (میزان انطباق).
- نرخ برد در یک آرنای کور در مقایسه با مدل قبلی (ترجیح کلی).
- تحلیل حالتهای شکست: بررسی 50 خروجی تصادفی و ثبت ایرادهای شناختهشده (آناتومی دست، رندر متن، شمارش دقیق اشیا).
تکیه بر تنها یک معیار، فریبنده است. سه معیار همپوشان به همراه بازبینی کیفی، ادعایی معتبر میسازند.
پیادهسازی از صفر
فایل code/main.py محاسبات FID، ساختاری مشابه امتیاز CLIP و تجمیع امتیاز Elo را روی «بردارهای ویژگی» ساختگی پیادهسازی میکند (ما از بردارهای 4-بعدی بهعنوان جایگزین ویژگیهای Inception استفاده کردهایم). با اجرای آن خواهید دید:
- محاسبهی FID روی N کوچک و N بزرگ — مشاهدهی اریبی محاسباتی.
- ساختاری شبیه به «امتیاز CLIP» از طریق شباهت کسینوسی میان مجموعههای ویژگی.
- قاعدهی بهروزرسانی Elo بر اساس جریانی از دادههای ترجیحی ساختگی.
گام 1: محاسبهی FID در چهار خط
def fid(real_features, gen_features):
    mu_r, cov_r = mean_and_cov(real_features)
    mu_g, cov_g = mean_and_cov(gen_features)
    mean_diff = sum((a - b) ** 2 for a, b in zip(mu_r, mu_g))
    trace_term = trace(cov_r) + trace(cov_g) - 2 * sqrt_cov_product(cov_r, cov_g)
    return mean_diff + trace_term
گام 2: شباهت کسینوسی به سبک CLIP
def clip_like(image_feat, text_feat):
    dot = sum(a * b for a, b in zip(image_feat, text_feat))
    norm = math.sqrt(dot_self(image_feat) * dot_self(text_feat))
    return dot / max(norm, 1e-8)
گام 3: تجمیع امتیاز به روش Elo
def elo_update(r_a, r_b, winner, k=32):
    expected_a = 1 / (1 + 10 ** ((r_b - r_a) / 400))
    actual_a = 1.0 if winner == "a" else 0.0
    r_a_new = r_a + k * (actual_a - expected_a)
    r_b_new = r_b - k * (actual_a - expected_a)
return r_a_new, r_b_newدامهای رایج
- محاسبهی FID با N=1000: این تقریب برای کمتر از 10 هزار نمونه غیرقابلاعتماد است. مقالاتی که FID را با N پایین گزارش میدهند در حال دستکاری نتایجاند.
- مقایسهی FID میان رزولوشنهای مختلف: تغییر سایز تصویر به ابعاد 299×299 برای Inception، توزیع ویژگیها را دستخوش تغییر میکند. مدلها را صرفاً در رزولوشنهای یکسان مقایسه کنید.
- گزارش نتایج با یک Seed: آزمون را حداقل با 3 سید تصادفی اجرا کرده و انحراف معیار (std) را قید کنید.
- بالا بردن کاذب امتیاز CLIP با پرامپت منفی: برخی پایپلاینها (Pipelines) با بیشبرازش روی پرامپت، امتیاز CLIP را بالا میبرند. حتماً اشباع (Saturation) بصری تصویر را بررسی کنید.
- اریبی Elo ناشی از همپوشانی پرامپتها: اگر هر دو مدل پرامپت ارزیابی را در زمان آموزش دیده باشند، امتیاز Elo فاقد اعتبار است. فقط از مجموعهپرامپتهای دیدهنشده استفاده کنید.
- انحراف ارزیابی انسانی ناشی از جامعهی آماری پولی: ارزیابهای پلتفرمهایی مثل Prolific یا MTurk عموماً جوانتر و فناوریدوست هستند. برای تعادل، از متخصصان هنر و طراحی نیز دعوت کنید.
استفاده از ابزارهای واقعی
پروتکل ارزیابی در محیطهای عملیاتی در سال 2026:
| رکن ارزیابی | حداقل الزامی | حالت پیشنهادی |
|---|---|---|
| کیفیت نمونه | محاسبهی FID روی 10 هزار نمونه در برابر دادهی واقعی | + CMMD روی 5 هزار نمونه + FID جداگانه برای زیرمجموعهی هر دستهبندی |
| انطباق با پرامپت | امتیاز CLIP روی 30 هزار نمونه | + HPSv2 + ImageReward + پرسشوپاسخ به سبک VQA |
| ترجیح مخاطب | 200 جفتتصویر در ارزیابی کور در برابر مدل پایه | + 2000 جفت توسط انسان + داور LLM + وبسایت Chatbot Arena |
| تحلیل شکستها | 50 تصویر بازبینیشده بهصورت دستی | 500 تصویر دستی + مدل خودکار دستهبندی ایمنی |
گنجاندن هر چهار رکن در یک گزارش به معنی ادعایی قابلاتکاست؛ ارائهی هر کدام بهتنهایی صرفاً مانور بازاریابی است.
خروجی این درس
یک گزارش در مسیر outputs/skill-eval-report.md ذخیره کنید. این مهارت، چکپوینت (Checkpoint) مدل جدید را به همراه مدل پایه تحویل میگیرد و یک برنامهی ارزیابی کامل تدوین میکند: حجم نمونهها، سنجهها، آزمونهای اختصاصی برای سناریوهای شکست و معیارهای تایید نهایی خروجی.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. مقدار FID را برای N=100 و N=1000 روی توزیعهای ساختگی یکسان مقایسه کرده و اندازهی اریبی را گزارش دهید. - متوسط. معیار CMMD را بر اساس ویژگیهای ساختگیِ مشابه CLIP پیاده کنید (برای فرمول به مقالهی Jayasumana et al., 2024 رجوع کنید). حساسیت آن را نسبت به تغییرات کیفیت تصویر در مقایسه با FID بسنجید.
- پیشرفته. ساختار HPSv2 را بازسازی کنید: 1000 جفت تصویر-پرامپت را از زیرمجموعهی دیتای Pick-a-Pic بردارید، یک مدل امتیازدهی کوچک مبتنی بر CLIP را روی ترجیحات فاینتیون کنید، و میزان تطابق آن را با یک مجموعهی تست جداگانه بسنجید.
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای دقیق فنی |
|---|---|---|
| FID | «فاصلهی فرشه اینسپشن» | فاصلهی فرشه میان توزیعهای گاوسی فیتشده روی ویژگیهای واقعی و تولیدشده در شبکهی Inception. |
| CLIP score | «شباهت متن و تصویر» | شباهت کسینوسی میان امبدینگهای تصویر و متن در شبکهی CLIP. |
| CMMD | «جایگزین FID» | معیار MMD مبتنی بر ویژگیهای CLIP؛ اریبی کمتر و بدون فرض گاوسی بودن توزیع. |
| IS | «امتیاز اینسپشن» | فرمول Exp KL(p(y|x) || p(y))؛ در مدلهای امروزی همبستگی ضعیفی دارد و منسوخ شده است. |
| HPSv2 / ImageReward / PickScore | «معیارهای تخمینی ترجیح» | مدلهای کوچکی که بر اساس ترجیحات انسانی آموزش دیدهاند و داور خودکار محسوب میشوند. |
| Elo | «امتیاز شطرنجی» | روش تجمیع بردهای جفتی بر پایهی مدل آماری بردلی-تری. |
| PartiPrompts | «مجموعه پرامپت استاندارد» | 1,600 پرامپت تدوینشده توسط گوگل در 12 دستهبندی مختلف. |
| FD-DINO | «جایگزین خودنظارتی» | محاسبهی فاصلهی فرشه با ویژگیهای مدل DINOv2؛ گزینهای بهتر برای دامنههای خارج از ImageNet. |
نکتهی فنی پروداکشن: ارزیابی هم نوعی بار پردازشی اینفرس است
محاسبهی FID روی 10 هزار نمونه به معنی تولید 10 هزار تصویر است. اگر یک مدل پایهی SDXL را با 50 گام در ابعاد 1024² روی یک کارت گرافیک L4 اجرا کنید، این فرآیند بهازای هر درخواست مجزا حدود 11 ساعت زمان میبرد. هزینههای سختافزاری ارزیابی واقعی و جدی هستند و این کار دقیقاً ماهیتی شبیه به اینفرس آفلاین دارد (نرخ پردازش (Throughput) را به حداکثر برسانید و تاخیر (Latency) اولین توکن را نادیده بگیرید):
- بچها را سنگین ببندید و تاخیر را فراموش کنید. ارزیابی آفلاین یعنی استفاده از بچینگ ایستا (Static batching) با بزرگترین اندازهای که در حافظه جا میشود. اجرای
pipe(...).imagesباnum_images_per_prompt=8روی یک پردازندهی 80GB H100، زمان اجرا را 4 تا 6 برابر نسبت به پردازش تکی کاهش میدهد. - ویژگیهای دادهی واقعی را کش کنید. استخراج ویژگیهای Inception (برای FID) یا CLIP (برای امتیاز CLIP و CMMD) روی مجموعهمرجع واقعی باید فقط یکبار انجام و در قالب یک فایل
.npzذخیره شود. این محاسبه را در هر بار ارزیابی مجدداً تکرار نکنید.
برای پایپلاینهای CI و بررسی عدم افت کیفیت مدل: محاسبهی FID و امتیاز CLIP را روی یک زیرمجموعهی 500تایی در هر PR اجرا کنید (حدود 30 دقیقه)؛ و اجرای کامل با 10 هزار نمونه، ارزیابی HPSv2 و محاسبهی Elo را به تستهای شبانه واگذار کنید.
برای مطالعهی بیشتر
- هوسل و همکاران (2017). GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium (FID) — مقالهی مرجع FID.
- جایاسومانا و همکاران (2024). Rethinking FID: Towards a Better Evaluation Metric for Image Generation (CMMD) — مقالهی CMMD.
- ردفورد و همکاران (2021). Learning Transferable Visual Models from Natural Language Supervision (CLIP) — مقالهی مرجع CLIP.
- وو و همکاران (2023). HPSv2: A Comprehensive Human Preference Score — مقالهی HPSv2.
- شو و همکاران (2023). ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation — مقالهی ImageReward.
- یو و همکاران (2023). Scaling Autoregressive Models for Content-Rich Text-to-Image Generation (Parti + PartiPrompts) — مقالهی PartiPrompts.
- اشتاین و همکاران (2023). Exposing flaws of generative model evaluation metrics — مقالهی مروری روی نقاطضعف معیارهای ارزیابی.