
در سالهای آغازین ظهور شبکههای مقابلهای زایا (GAN)، خروجی این شبکهها بیشتر تصادفی و غیرقابل کنترل بود. تولید چهرههای تصادفی جذابیت بالایی در دموها داشت، اما برای کاربردهای مهندسی واقعی، به خروجی مقید و کنترلشده نیاز داریم؛ مثل تبدیل خطوط نقشه به تصویر هوایی یا تبدیل اسکچ دستی به عکسی واقعی. معماریهای شرطی (Conditional GAN) و به ویژه مدل Pix2Pix این امکان را فراهم کردند تا تصویر خروجی دقیقاً تابع ورودیِ هدایتکننده باشد.
اگرچه مدلهای نوین دیفیوژن در تولید تصاویر باکیفیت و تنوع بالا عملکرد خیرهکنندهای دارند، اما هزینه سنگین محاسباتی و تاخیر چندثانیهای آنها، استقرارشان را روی سرویسهای حساس به زمان پاسخ با چالش روبهرو میکند. مدل Pix2Pix به دلیل استنتاج تکمرحلهای (one-shot) بر بستر مولد U-Net، همچنان انتخابی بیرقیب برای تسکهای محدود با دادههای جفتشده است که زمان تاخیر را به کمتر از چند ده میلیثانیه میرساند.
با توجه به اینکه اجاره یا خرید پردازندههای گرافیکی قدرتمند خارجی برای توسعهدهندگان دشوار و پرهزینه است، یادگیری پیادهسازی مدلهای سبکی مانند cGAN و بهینهسازی آنها اهمیت دوچندانی دارد. در این درس با معماری شبکه مولد U-Net، تمایزگر محلی PatchGAN و ترفندهای آموزش پایدار این خانواده از مدلها آشنا میشوید.
اولین تحول بزرگ سالهای 2014 تا 2017، کنترل خروجی GAN بود؛ اینکه بتوانید یک برچسب، تصویر یا متن را به آن ضمیمه کنید. Pix2Pix نسخهی تصویری این ایده را پیاده کرد و هنوز هم در تسکهای محدود تصویربهتصویر، همهی مدلهای عمومی متنبهتصویر را پشت سر میگذارد.
صورت مسئله
یک GAN غیرشرطی چهرههایی تصادفی تولید میکند؛ برای دمو جذاب است، اما در محیط پروداکشن کاربردی ندارد. نیاز واقعی شما چنین مواردی است: تبدیل اسکچ به عکس واقعی، تبدیل نقشه به تصویر هوایی، تبدیل صحنهی روز به شب یا رنگی کردن عکس سیاهوسفید. در تمام این تسکها، یک تصویر ورودی به شما داده میشود و باید خروجی را با حفظ هماهنگی معنایی تولید کنید. بهازای هر ، چندین معقول وجود دارد. اگر از خطای میانگین مربعات (MSE) استفاده کنید، همهی این حالتها با هم ترکیب شده و خروجی شبیه به معجونی تار و غیرشفاف میشود. اما تابع زیان مقابلهای (adversarial loss) این مشکل را ندارد، چون معیار «واقعی به نظر رسیدن» بسیار شارپ و تفکیکشده است.
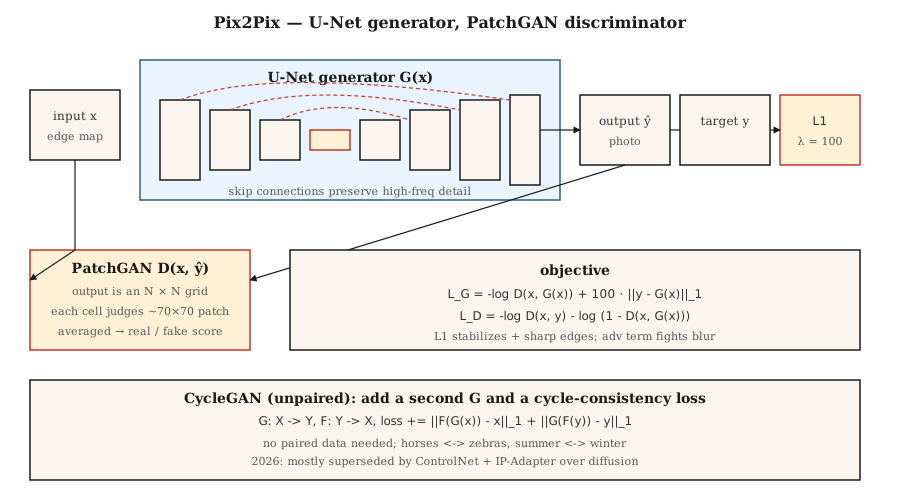
مدل Conditional GAN (میرزا و اوسیندرو، 2014) یک شرط را به عنوان ورودی به هر دو شبکهی و اضافه میکند. Pix2Pix (ایزولا و همکاران، 2017) این ایده را تخصصی کرد: شرط یک تصویر ورودی کامل است، مولد (generator) از معماری U-Net بهره میبرد، تمایزگر (discriminator) یک دستهبند مبتنی بر وصله (PatchGAN) است و تابع زیان (loss) ترکیبی از زیان مقابلهای به همراه L1 است. این فرمول حتی در سال 2026 هم در دامنههای محدود تصویربهتصویر، مدلهای متنبهتصویر آموزشدیده از صفر را پشت سر میگذارد؛ چرا که روی دادههای جفتشده (paired data) آموزش میبیند و دقیقاً همان سیگنال نظارتی لازم را در اختیارتان میگذارد.
مفاهیم کلیدی
مولد شرطی (Conditional G): . در Pix2Pix، متغیر در واقع همان دراپاوت درون شبکهی G است (نویز ورودی جداگانهای وجود ندارد؛ ایزولا دریافت که نویز صریح عملاً توسط مدل نادیده گرفته میشود).
تمایزگر شرطی (Conditional D): . ورودی تمایزگر یک جفت (شرط، خروجی) است. تفاوت کلیدی همینجاست: D باید قضاوت کند که آیا با همخوانی دارد یا خیر، نه اینکه صرفاً بررسی کند آیا واقعی به نظر میرسد.
مولد U-Net: یک ساختار انکودر-دیکودر همراه با اتصال جهشی (skip connection) که از روی گلوگاه مدل عبور میکند. این ویژگی برای تسکهایی که ورودی و خروجی ساختار سطح پایینی مثل لبهها یا خطوط مرزی مشترک دارند، حیاتی است. بدون این اتصالات جهشی، جزئیات فرکانسبالا از بین میروند.
تمایزگر PatchGAN: شبکهی D بهجای ارائهی یک امتیاز کلیِ واقعی/جعلی، یک شبکهی خروجی میدهد که در آن هر سلول، یک میدان دید (receptive field) در حدود 70×70 پیکسل را ارزیابی میکند؛ در نهایت از این مقادیر میانگین گرفته میشود. این سازوکار بر پایهی فرض میدان تصادفی مارکوف عمل میکند: کیفیت بصری و واقعگرایی ماهیتی محلی دارد. این رویکرد سرعت آموزش را بسیار بالاتر میبرد، پارامترهای کمتری میخواهد و خروجیهای شارپتری تحویل میدهد.
تابع زیان (Loss):
جملهی L1 آموزش را پایدار میکند و G را به سمت هدف مشخص push میکند. خطای L1 نسبت به L2 لبههای شارپتری تولید میکند (به دلیل تمرکز روی میانهها به جای میانگینها). مقدار پیشفرض در مقالهی Pix2Pix برابر با بود.
CycleGAN — وقتی دادههای جفتشده ندارید
مدل Pix2Pix به دادههای جفتشدهی وابسته است. CycleGAN (ژو و همکاران، 2017) این نیاز را با افزودن یک تابع زیان دیگر برطرف میکند: تابع زیان سازگاری چرخهای (cycle consistency loss). در اینجا دو مولد و حضور دارند. آموزش به شکلی انجام میشود که و برقرار باشند. این ترفند به شما اجازه میدهد اسب را به گورخر و تابستان را به زمستان تبدیل کنید، آن هم بدون داشتن نمونههای نظیربهنظیر.
در سال 2026، تبدیل تصاویر بدون جفت بیش از CycleGAN از طریق مدلهای دیفیوژن (مانند ControlNet و IP-Adapter) انجام میشود، اما ایدهی سازگاری چرخهای تقریباً در تمام مقالات حوزهی انطباق دامنه بدون جفت داده پابرجا مانده است.
پیادهسازی از صفر
فایل code/main.py یک مدل cGAN بسیار کوچک را روی دادههای 1 بعدی پیاده میکند. شرط در واقع برچسب کلاس (0 یا 1) است. هدف: تولید یک نمونه از توزیع شرطی برای کلاس دادهشده.
گام 1: الصاق شرط به ورودیهای G و D
def G(z, c, params):
    return mlp(concat([z, one_hot(c)]), params)

def D(x, c, params):
    return mlp(concat([x, one_hot(c)]), params)
استفاده از کدگذاری وانهات (one-hot encoding) سادهترین روش ممکن است. مدلهای بزرگتر از امبدینگهای یادگرفتنی، مدولاسیون FiLM یا کراساتنشن استفاده میکنند.
گام 2: آموزش شرطی
for step in range(steps):
    x, c = sample_real_conditional()
    noise = sample_noise()
    update_D(x_real=x, x_fake=G(noise, c), c=c)
    update_G(noise, c)
مولد باید با توزیع واقعی بهازای همان شرط مشخص مطابقت داشته باشد، نه با توزیع حاشیهای (marginal).
گام 3: اعتبارسنجی خروجی هر کلاس
for c in [0, 1]:
    samples = [G(noise, c) for noise in batch]
    mean_c = mean(samples)
assert_near(mean_c, real_mean_for_class_c)تلهها و خطاهای رایج
- نادیده گرفته شدن شرط: شبکهی G شرط را به حاشیه میراند و D هم به دلیل ضعف سیگنال شرط، آن را جریمه نمیکند. راهحل: شرطیسازی شبکهی D را تهاجمیتر کنید (اعمال شرط در لایههای ابتدایی و نه صرفاً لایههای پایانی)، یا از تمایزگر مبتنی بر تصویر کردن (projection discriminator؛ میاتو و کویاما، 2018) بهره بگیرید.
- وزن بسیار کم برای L1: شبکهی G به سمت تولید تصاویری میرود که صرفاً واقعی به نظر میرسند ولی به تصویر ورودی وفادار نیستند. برای تسکهای سبک Pix2Pix مقدار را از شروع کنید.
- وزن بسیار زیاد برای L1: خروجیهای G تار میشوند، زیرا L1 هم در نهایت یک نرم است. پس از پایدار شدن روند آموزش، مقدار آن را به تدریج کاهش دهید (anneal down).
- نشت دادههای زمینهی واقعیت (Ground-truth) در D: مقدار را حتماً به عنوان ورودی به D متصل (concatenate) کنید، نه فقط . بدون این کار، شبکهی D نمیتواند تطابق و یکدستی میان ورودی و خروجی را بررسی کند.
- فروپاشی مُد در هر کلاس: هر کلاس میتواند بهطور مستقل دچار فروپاشی مُد شود. تنوع خروجیها را به تفکیک کلاسها ارزیابی کنید.
استفاده در عمل
وضعیت تسکهای تصویربهتصویر در سال 2026:
| تسک | بهترین رویکرد |
|---|---|
| اسکچ به عکس، دامنهی یکسان، دادههای جفتشده | Pix2Pix / Pix2PixHD (همچنان سریع و شارپ) |
| اسکچ به عکس، دادههای جفتنشده | ControlNet همراه با مدل شرطیساز Scribble |
| بخشبندی معنایی به عکس | SPADE / GauGAN2 یا ترکیب SD + ControlNet-Seg |
| انتقال استایل (Style transfer) | مدلهای دیفیوژن با IP-Adapter یا LoRA؛ روشهای GAN دیگر قدیمی شدهاند |
| عمق به عکس | ControlNet-Depth روی بستر Stable Diffusion |
| تفکیکپذیری بالا (Super-resolution) | Real-ESRGAN (مبتنی بر GAN)، ESRGAN-Plus یا SD-Upscale (مبتنی بر دیفیوژن) |
| رنگیسازی عکس | ColTran، رنگآمیزهای مبتنی بر دیفیوژن یا Pix2Pix-color |
| تبدیل روز به شب، فصلها و وضعیت آبوهوا | CycleGAN یا روشهای مبتنی بر ControlNet |
مدل Pix2Pix همچنان بهترین انتخاب است زمانی که: الف) هزاران نمونهی جفتشده در اختیار دارید، ب) تسک محدود و تکرارپذیر است، و ج) به تاخیر پایین نیاز دارید. در تسکهای عمومی با دامنهی باز، مدلهای دیفیوژن برنده هستند.
خروجی نهایی
فایل outputs/skill-img2img-chooser.md را ذخیره کنید. این مهارت با دریافت شرح تسک، وضعیت دسترسی به داده (جفتشده یا جفتنشده، N نمونه) و بودجهی تاخیر/کیفیت، این موارد را خروجی میدهد: رویکرد مناسب (Pix2Pix، CycleGAN، انواعی از ControlNet، یا SDXL + IP-Adapter)، دادههای آموزشی موردنیاز، هزینهی استنتاج، و پروتکل ارزیابی (LPIPS، FID یا معیارهای اختصاصی تسک).
تمرینها
- ساده. فایل
code/main.pyرا تغییر دهید تا یک کلاس سوم هم اضافه شود. مطمئن شوید که G نویز هر کلاس را به مُد درست همان کلاس تصویر میکند. - متوسط. در همان فضای 1 بعدی، تابع زیان L1 را با یک تابع زیان مبتنی بر ادراک (perceptual-style loss) جایگزین کنید (مثلاً با قرار دادن یک شبکهی D منجمد و کوچک که مثل یک استخراجکنندهی ویژگی عمل کند). بررسی کنید که آیا این کار وضوح و دقت توزیع شرطی را تغییر میدهد یا خیر.
- سخت. طرح کلی یک CycleGAN را برای فضای 1 بعدی پیاده کنید: دو توزیع، دو مولد و تابع زیان چرخهای. نشان دهید که مدل بدون هیچ دادهی جفتشدهای یاد میگیرد چطور بین آنها نگاشت برقرار کند.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای فنی و دقیق |
|---|---|---|
| Conditional GAN | «یک GAN برچسبدار» | G(z, c) و D(x, c)؛ هر دو شبکه شرط را میبینند. |
| Pix2Pix | «GAN تصویربهتصویر» | یک cGAN با دادههای جفتشده، مولد U-Net، تمایزگر PatchGAN و تابع زیان L1. |
| U-Net | «انکودر-دیکودر با اتصالات جهشی» | شبکهی کانولوشنی متقارن؛ اتصالات جهشی جزئیات فرکانسبالا را حفظ میکنند. |
| PatchGAN | «دستهبند واقعگرایی محلی» | شبکهی D بهجای امتیاز کلی، بهازای هر وصله یک امتیاز محلی میدهد. |
| CycleGAN | «انتقال تصویر بدون دادههای جفت» | دو مولد همراه با تابع زیان سازگاری چرخهای؛ بدون نیاز به دادههای جفتشده. |
| SPADE | «همان GauGAN» | نرمالسازی فعالسازیهای میانی با نقشهی معنایی؛ برای تبدیل سگمنتیشن به عکس. |
| FiLM | «مدولاسیون خطی مبتنی بر ویژگی» | اعمال تبدیل آفین روی هر ویژگی بر اساس شرط؛ روشی ارزان برای اعمال شرط. |
نکتهی پروداکشن: Pix2Pix به عنوان پایهای برای سیستمهای مقید به تاخیر
وقتی دادههای جفتشده دارید و با تسک مشخص و محدودی روبهرو هستید (اسکچ به رندر، نقشهی سگمنتیشن به عکس، روز به شب)، استنتاج تکمرحلهای (one-shot) مدل Pix2Pix از نظر تاخیر با اختلافی نزدیک به یک مرتبهی بزرگی مدلهای دیفیوژن را شکست میدهد. مقایسهی پروداکشن معمولاً به این صورت است:
| مسیر پیادهسازی | تعداد گامها | تاخیر متداول در ابعاد 512² روی یک پردازندهی گرافیکی L4 |
|---|---|---|
| Pix2Pix (یک رفت مستقیم U-Net) | 1 | حدود 30 میلیثانیه |
| SD-Inpaint یا SD-Img2Img | 20 | حدود 1.2 ثانیه |
| SDXL-Turbo Img2Img | 1-4 | حدود 0.15-0.35 ثانیه |
| ControlNet + پایهی SDXL | 20-30 | حدود 3-5 ثانیه |
مدل Pix2Pix در نرخ پردازش بچهای ایستا برنده میشود (بار پردازشی یا FLOPs برای تمام درخواستها یکسان است). در مقابل، مدلهای دیفیوژن در کیفیت بصری و تعمیمپذیری دست بالا را دارند. راهکار مدرن در محیطهای پروداکشن این است که برای تسک محدود یک مدل تقطیرشده به سبک Pix2Pix مستقر کنید و از مدل دیفیوژن به عنوان سیستم جایگزین و پشتیبان (fallback) برای ورودیهای نامتعارف (tail inputs) بهره ببرید.
منابع برای مطالعهی بیشتر
- Mirza & Osindero (2014). Conditional Generative Adversarial Nets — مقالهی cGAN.
- Isola et al. (2017). Image-to-Image Translation with Conditional Adversarial Networks — مقالهی Pix2Pix.
- Zhu et al. (2017). Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks — مقالهی CycleGAN.
- Wang et al. (2018). High-Resolution Image Synthesis with Conditional GANs — مقالهی Pix2PixHD.
- Park et al. (2019). Semantic Image Synthesis with Spatially-Adaptive Normalization — مقالهی SPADE / GauGAN.
- Miyato & Koyama (2018). cGANs with Projection Discriminator — مقالهی تمایزگر Projection D.