
اگر تا به حال با خودکدگذارهای سنتی (Autoencoders) کار کرده باشید، احتمالاً متوجه شدهاید که این شبکهها در فشردهسازی و بازسازی ورودیها عملکرد بسیار خوبی دارند، اما نمیتوان از آنها برای تولید دادههای جدید استفاده کرد؛ زیرا فضای نهان (latent space) آنها ساختاریافته و پیوسته نیست و انتخاب یک نقطهی تصادفی معمولاً به خروجیهایی نامفهوم و نویزی ختم میشود.
خودکدگذار متغیر (Variational Autoencoder یا VAE) با اضافه کردن قیدهای آماری و ترفند هوشمندانهی بازپارامتریسازی (Reparameterization Trick)، فضای نهان را به یک توزیع مشخص و هموار تبدیل میکند. این نوآوری امکان نمونهگیری مستقیم و تولید دادههای معنادار را فراهم میسازد؛ عاملی که باعث شده VAE بخش جداییناپذیر پایپلاینهای مدرن تولید تصویر، مانند Stable Diffusion و Flux باشد.
برای اجرای کدهای این آموزش نیازی به کارتهای گرافیک گرانقیمت یا سرویسهای ابری خارجی ندارید. پیادهسازی گامبهگام ارائهشده در این درس بهصورت کاملاً پایه و با پایتون خالص نوشته شده و بدون وابستگی سنگین روی پردازندهی استاندارد (CPU) هر سیستمی بهراحتی اجرا میشود.
یک خودکدگذار (autoencoder) معمولی ابتدا داده را فشرده و سپس بازسازی میکند. داده را حفظ میکند، اما چیزی تولید نمیکند. کافی است یک ترفند به آن اضافه کنید — کد را وادار کنید توزیع گوسی داشته باشد — تا یک نمونهگیر (sampler) به دست آورید. همین یک ترفند، یعنی بازپارامتریسازیِ ، دلیل این است که ورودی همهی مدلهای تصویر دیفیوژن نهان (latent-diffusion) و تطبیق جریان (flow-matching) در سال 2026 یک VAE است.
صورت مسئله
یک رقم 784 پیکسلی دیتاست MNIST را در کدی متشکل از 16 عدد فشرده و سپس بازسازی کنید. یک خودکدگذار معمولی در خطای میانگین مربعات (MSE) بازسازی نمرهی عالی میگیرد، اما فضای کد آن ساختاری درهمریخته و پر از برآمدگی است. نقطهای تصادفی از این فضای کد بردارید و آن را دکود کنید؛ خروجی صرفاً نویز خواهد بود. چنین مدلی نمونهگیر ندارد و در واقع همان مدل فشردهسازی در لباسی دیگر است.
آنچه واقعاً میخواهید سه چیز است: (الف) فضای کد، توزیعی تمیز و هموار باشد که بتوان از آن نمونهگیری کرد — مثلاً یک گوسی همسانگرد ، (ب) دکود کردن هر نمونه، رقمی معقول بسازد، و (ج) انکودر و دکودر همچنان فشردهسازی خوبی داشته باشند. سه هدف، یک معماری، یک تابع زیان (loss).
مدل VAE کینگما در سال 2013 این مسئله را حل میکند: انکودر طوری آموزش میبیند که یک توزیع خروجی دهد ، این توزیع با جریمهی واگرایی کولبک-لایبلر (KL penalty) به سمت توزیع پیشین (prior) کشیده میشود، و سپس پیش از دکود کردن، از نمونهگیری میشود. هنگام استنتاج (inference)، انکودر را کنار بگذارید، را نمونهگیری کنید و دکود نمایید. جریمهی KL همان چیزی است که فضای کد را ساختاریافته میکند.
در سال 2026 مدلهای VAE بهندرت بهصورت مستقل عرضه میشوند — دیفیوژن از نظر کیفیت خام تصویر آنها را پشت سر گذاشته است — اما VAE انکودر انتخابی برای تمام مدلهای دیفیوژن نهان (SD 1/2/XL/3، Flux و AudioCraft) به شمار میرود. VAE را یاد بگیرید تا لایهی اول و نادیدنی تمام پایپلاینهای تصویریِ مورد استفادهتان را بشناسید.
مفاهیم پایه
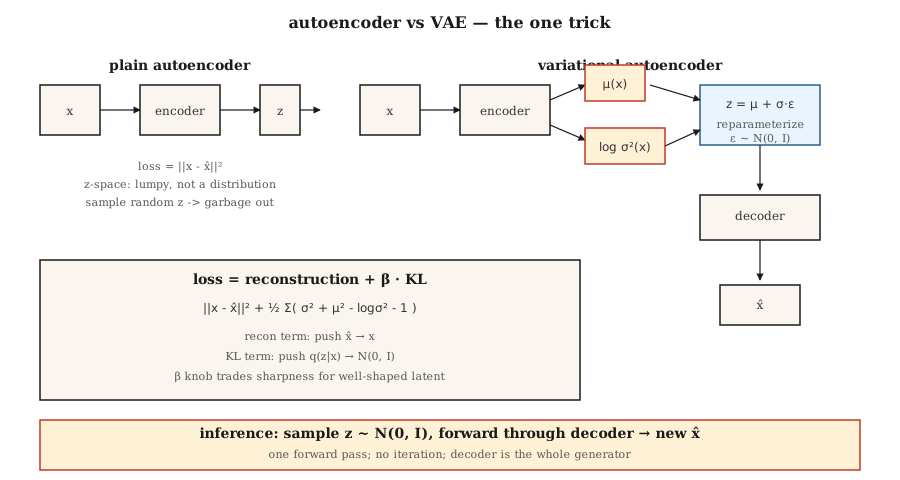
خودکدگذار. ، ، تابع زیان (loss) = . فضای کد بدون ساختار است.
انکودر VAE. دو بردار خروجی میدهد: و . این دو بردار را تعریف میکنند.
ترفند بازپارامتریسازی (Reparameterization Trick). نمونهگیری از مشتقپذیر نیست. نمونه را به شکل بازنویسی کنید که در آن . اکنون تابعی معین (deterministic) از بهعلاوهی نویزی بدون پارامتر است — گرادیانها از میان μ و جاری میشوند.
تابع زیان. حد پایین شواهد یا ELBO (مخفف Evidence Lower BOund)، شامل دو عبارت:
بخش بازسازی، را به سمت push میکند. جریمهی KL نیز را به سمت توزیع پیشین push میکند. بین این دو مصالحه برقرار است. مقادیر کوچک () = نمونههای شفافتر، اما فضای کدی با شباهت کمتر به گوسی. مقادیر بزرگ () = فضای کد مرتبتر، اما نمونههای تارتر. مدل β-VAE (هیگینز، 2017) این پیچ تنظیم را مشهور کرد و جرقهی پژوهشهای تفکیک متغیرها (disentanglement) را زد.
نمونهگیری. هنگام استنتاج: را نمونهگیری کنید و در یک گذر رو به جلو (forward pass) به دکودر بدهید. فقط یک گذر رو به جلو — بدون نیاز به نمونهگیری تکرارشونده مثل مدلهای دیفیوژن.
پیادهسازی
فایل code/main.py یک VAE جمعوجور را بدون استفاده از numpy یا torch پیاده میکند. ورودی، دادهای ساختگی و 8 بُعدی است که از یک مدل آمیختهی گوسی 2 مؤلفهای در فضای 8 بعدی نمونهگیری شده است. انکودر و دکودر پرسپترونهای چندلایهی (MLP) با یک لایهی پنهان هستند. ما تابع فعالسازی tanh، گذر رو به جلو، تابع زیان و یک گام رو به عقب (backward pass) دستنویس را پیاده میکنیم. نه برای پروداکشن — صرفاً با هدف آموزش.
گام 1: گذر رو به جلوی انکودر
def encode(x, enc):
    h = tanh(add(matmul(enc["W1"], x), enc["b1"]))
    mu = add(matmul(enc["W_mu"], h), enc["b_mu"])
    log_sigma2 = add(matmul(enc["W_sig"], h), enc["b_sig"])
    return mu, log_sigma2
به جای از استفاده میکنیم تا خروجی شبکه محدودیتی نداشته باشد (استفاده از softplus برای σ یک تله است — گرادیانها در صفر میشوند).
گام 2: بازپارامتریسازی و دکود کردن
def reparameterize(mu, log_sigma2, rng):
    eps = [rng.gauss(0, 1) for _ in mu]
    sigma = [math.exp(0.5 * lv) for lv in log_sigma2]
    return [m + s * e for m, s, e in zip(mu, sigma, eps)]

def decode(z, dec):
    h = tanh(add(matmul(dec["W1"], z), dec["b1"]))
    return add(matmul(dec["W_out"], h), dec["b_out"])
گام 3: ELBO
def elbo(x, x_hat, mu, log_sigma2, beta=1.0):
    recon = sum((a - b) ** 2 for a, b in zip(x, x_hat))
    kl = 0.5 * sum(math.exp(lv) + m * m - lv - 1 for m, lv in zip(mu, log_sigma2))
    return recon + beta * kl, recon, kl
چون هر دو توزیع گوسی هستند، فرم بستهی (closed-form) دقیق برای KL داریم. آن را بهصورت عددی انتگرالگیری نکنید. هنوز در سال 2026 کدهایی با تخمین مونتکارلو برای KL منتشر میشوند — کاری که بیدلیل سرعت را 3 برابر کمتر میکند.
گام 4: تولید داده
def sample(dec, z_dim, rng):
    z = [rng.gauss(0, 1) for _ in range(z_dim)]
    return decode(z, dec)
این کل مدل زایشی (generative model) است. فقط پنج خط.
چالشها و دامها
- فروپاشی توزیع پسین (Posterior collapse). عبارت KL چنان با شدت را پایین میآورد که هیچ اطلاعاتی دربارهی نگه نمیدارد. راهکار: بازپخت ضریب بتا (β-annealing) (شروع از و افزایش تا 1)، بیتهای آزاد (free bits)، یا صرفنظر از جریمهی KL در ابعاد غیرفعال.
- تار شدن نمونهها. درستنمایی (likelihood) گوسی دکودر مستلزم بازسازی با MSE است؛ این معیار برای L2 بهینهی بیزی است (میانگین) — و میانگینِ مجموعهای از ارقام باورپذیر، رقمی محو و مات خواهد بود. راهکار: دکودر گسسته (VQ-VAE ،NVAE)، یا استفاده از VAE صرفاً بهعنوان انکودر و سوار کردن دیفیوژن روی متغیرهای نهان (کاری که Stable Diffusion انجام میدهد).
- بزرگ بودن بیش از حد β در ابتدای کار. به بخش فروپاشی پسین مراجعه کنید. از شروع کنید و بهمرور مقدار را افزایش دهید.
- ابعاد نهان بیش از حد کوچک. فضای 16 بعدی برای MNIST، 256 بعدی برای ImageNet 256² و 2048 بعدی برای ImageNet 1024² جواب میدهد. مدل VAE در Stable Diffusion تصویر 512×512×3 را به 64×64×4 فشرده میکند (کاهش 8 برابری ابعاد در هر ضلع، کاهش 64 برابری مساحت؛ تعداد کانالها از 3 به 4 میرسد، یعنی در کل دادهها حدود 48 برابر کمتر میشوند).
کاربردها
پشتهی ابزارهای VAE در سال 2026:
| موقعیت | انتخاب |
|---|---|
| انکودر تصویر نهان برای دیفیوژن | VAE مربوط به Stable Diffusion (مدل sd-vae-ft-ema) یا VAE مدل Flux |
| انکودر صوت نهان | Encodec (از Meta)، SoundStream یا DAC (از Descript) |
| متغیرهای نهان ویدیو | پچهای فضا-زمانی Sora، مدل Latte VAE، یا WAN VAE |
| یادگیری بازنمایی تفکیکشده (Disentangled representation learning) | β-VAE، FactorVAE، TCVAE |
| متغیرهای نهان گسسته (برای مدلسازی با ترنسفورمر) | VQ-VAE، RVQ (کوآنتایزر باقیمانده) |
| متغیرهای نهان پیوسته برای تولید | VAE معمولی، سپس شرطیسازی مدل جریان/دیفیوژن در همان فضای نهان |
یک مدل دیفیوژن نهان در حقیقت همان VAE است که یک مدل دیفیوژن بین انکودر و دکودرش جا خوش کرده است. VAE فشردهسازی درشتدانه را انجام میدهد و مدل دیفیوژن بار سنگین کار را به دوش میکشد. همین الگو برای ویدیو (ترکیب VAE + ترنسفورمر DiT دیفیوژن ویدیو) و صدا (ترکیب Encodec + ترنسفورمر MusicGen) نیز حاکم است.
تحویل خروجی
فایل outputs/skill-vae-trainer.md را ذخیره کنید.
این مهارت مشخصات زیر را ورودی میگیرد: مشخصات دیتاست + بعد نهان هدف + کاربرد پاییندستی (بازسازی، نمونهگیری، یا ورودی مدل دیفیوژن نهان) و خروجی میدهد: انتخاب معماری (معمولی/β/VQ/RVQ)، برنامهی زمانی تغییرات β، بعد نهان، درستنمایی دکودر (گوسی در برابر دستهای)، و طرح ارزیابی (MSE بازسازی، KL به ازای هر بعد، و فاصلهی فرشه بین و ).
تمرینها
- ساده. مقدار را در
code/main.pyبه0.01،0.1،1.0و5.0تغییر دهید. مقادیر نهایی MSE بازسازی و KL را ثبت کنید. کدام مقدار برای دادههای ساختگی شما بهترین تعادل پارتو (Pareto-best) را به دست میدهد؟ - متوسط. درستنمایی گوسی دکودر را با درستنمایی برنولی (زیان آنتروپی متقاطع یا Cross-Entropy) جایگزین کنید. کیفیت نمونهها را روی نسخهی باینریشدهی همان دادههای ساختگی مقایسه کنید.
- سخت. کد
code/main.pyرا به یک VQ-VAE کوچک ارتقا دهید: متغیر پیوستهی را با جستوجوی نزدیکترین همسایه در یک کتابچهی کد (codebook) با 32=K مدخل جایگزین کنید. MSE بازسازی را مقایسه کنید و گزارش دهید چه تعداد از اعضای کتابچهی کد واقعاً استفاده میشوند (مسئلهی فروپاشی کتابچهی کد کاملاً واقعی است).
اصطلاحات کلیدی
| اصطلاح | عامه چه میگویند | واقعاً چه معنایی دارد |
|---|---|---|
| خودکدگذار (Autoencoder) | شبکهی انکود-دکود | ، یادگیری با MSE. زایشی نیست. |
| VAE | خودکدگذار با نمونهگیر | انکودر یک توزیع خروجی میدهد، جریمهی KL فضای کد را شکل میدهد. |
| حد پایین شواهد (ELBO) | کران پایین شواهد | ؛ وقتی مساوی و دقیق است که . |
| ترفند بازپارامتریسازی | بازنویسی گره تصادفی بهصورت تابعی معین بهعلاوهی نویز خالص؛ انتشار رو به عقب را از میان نمونهگیری ممکن میسازد. | |
| پیشین (Prior) | توزیع هدف برای متغیر نهان، که معمولاً است. | |
| فروپاشی توزیع پسین (Posterior collapse) | «جریمهی KL برنده شد» | انکودر را نادیده میگیرد و توزیع پیشین را تحویل میدهد؛ دکودر مجبور است توهم بزند. |
| مدل β-VAE | وزن قابلتنظیم برای KL | . مقادیر بالاتر = ویژگیهای تفکیکشدهتر اما نمونههای تارتر. |
| مدل VQ-VAE | متغیر نهان گسسته | جایگزینی پیوسته با نزدیکترین بردار کتابچهی کد؛ امکان مدلسازی با ترنسفورمر را فراهم میکند. |
نکتهی پروداکشن: VAE داغترین مسیر در سرورهای دیفیوژن است
در پایپلاین Stable Diffusion / Flux / SD3، مدل VAE در هر درخواست دو بار فراخوانی میشود — یک بار برای انکود (در صورت انجام کارهای تصویر-به-تصویر یا اینپینتینگ) و یک بار برای دکود. در وضوح 1024²، گذر دکودر معمولاً بالاترین اوج مصرف حافظهی اکتیویشن (activation memory) را در کل پایپلاین رقم میزند؛ زیرا باید متغیرهای نهان با ابعاد 128×128×16 را مجدداً به اندازهی 1024×1024×3 بزرگنمایی کند. این موضوع دو پیامد عملی دارد:
- دکود کردن برشی (Slicing) یا کاشیکاریشده (Tiling). پکیج
diffusersدو قابلیتpipe.vae.enable_slicing()وpipe.vae.enable_tiling()را در اختیارتان میگذارد. کاشیکاری با پذیرش یک خطای مرزی و درز جزئی، مصرف حافظه را از به کاهش میدهد. این ترفند برای اجرای رزولوشنهای 1024²+ روی پردازندههای گرافیکی تجاری حیاتی است. - دکودر با دقت bf16، محاسبات عددی fp32 برای تغییر اندازهی نهایی. مدل VAE در SD 1.x با دقت fp32 منتشر شد و در صورت تبدیل به fp16 در رزولوشنهای 1024²+ بیصدا مقادیر نامعتبر عددی (NaN) تولید میکند. در SDXL مدل
madebyollin/sdxl-vae-fp16-fixعرضه شده است — همیشه از این نسخهی اصلاحشده استفاده کنید یا سراغ دقت bf16 بروید.
برای مطالعهی بیشتر
- کینگما و ولینگ (2013). Auto-Encoding Variational Bayes — مقالهی پایهای VAE.
- هیگینز و همکاران (2017). β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework — مقالهی مدل β-VAE برای تفکیک ویژگیها.
- فن دن اوورد و همکاران (2017). Neural Discrete Representation Learning — مقالهی VQ-VAE.
- وحدت و کاتز (2021). NVAE: A Deep Hierarchical Variational Autoencoder — پیشرفتهترین معماری VAE برای تصویر.
- رومباخ و همکاران (2022). High-Resolution Image Synthesis with Latent Diffusion Models — مقالهی Stable Diffusion؛ استفاده از VAE بهعنوان انکودر.
- دوفوسز و همکاران (2022). High Fidelity Neural Audio Compression — مقالهی Encodec، استاندارد صنعتی VAE برای صوت.