
مدلهای زایشی پیش از ظهور دیفیوژن چالشهای بزرگی داشتند؛ شبکههای تقابلی انتسابگر (GAN) با بازیهای مینیمکس ناپایدار واگرا میشدند و خودرمزگذارهای متغیری (VAE) تصاویری تار تحویل میدادند. مدلهای احتمالاتی نویززدایی دیفیوژن (DDPM) با سادهسازی مسئله به تخمین نویز در گامهای متوالی، پایهی اصلی ابزارهای پیشرفتهای مانند Stable Diffusion، Flux و مدلهای زایشی تصویر و ویدیو شدند.
درک سازوکار داخلی DDPM و نحوهی استخراج فرم بستهی گامهای رفت و برگشت به شما کمک میکند که هنگام استفاده، شخصیسازی یا بهینهسازی مدلهای مدرن زایشی، دیدی فراتر از صرفاً اجرای اسکریپتهای آماده داشته باشید و تفاوت رویکردهای نویززدایی را به شکلی کاربردی بشناسید.
کد آموزشی این درس روی یک توزیع یکبعدی پیادهسازی شده و محاسبات بسیار سبکی دارد؛ بنابراین بدون نیاز به تهیهی کارتهای گرافیکی گرانقیمت یا سرویسهای ابری خارجی، بهراحتی روی پردازندهی معمولی سیستم شخصی شما اجرا میشود.
مقاله Ho، Jain و Abbeel (2020) فرمولی به این حوزه داد که دیگر نمیشد از آن دست کشید: دادهها را طی هزار گام کوچک با نویز نابود کنید؛ یک شبکهی عصبی را برای پیشبینی نویز آموزش دهید؛ و فرآیند را هنگام استنتاج (inference) معکوس کنید. امروزه تمام مدلهای جریان اصلی تصویر، ویدیو، سهبعدی و موسیقی بر پایهی همین حلقه اجرا میشوند؛ گاهی با اضافه شدن ترفندهای تطبیق جریان (flow matching) یا سازگاری (consistency).
صورت مسئله
شما یک نمونهگیر (sampler) برای میخواهید. شبکههای GAN وارد یک بازی مینیمکس (minimax) میشوند که اغلب واگرا میشود. مدلهای VAE نیز با دکودر گاوسی خود نمونههای تار تحویل میدهند. چیزی که واقعاً میخواهید، یک هدف آموزشی است که: (الف) یک تابع زیان (loss) منفرد و پایدار داشته باشد (نه نقطهی زینی و نه مینیمکس)، (ب) کران پایینی برای باشد (تا درستنمایی داشته باشید)، و (ج) نمونههایی همتراز با بهترین کیفیت روز (SOTA) بسازد.
سول-دیکستین و همکاران (2015) پاسخی تئوریک ارائه دادند: یک زنجیرهی مارکوف تعریف کنید که بهتدریج نویز گاوسی اضافه میکند، و سپس زنجیرهی معکوس را برای نویززدایی آموزش دهید. هو، جین و اَبیل (2020) نشان دادند که این تابع زیان را میتوان تا حد یک خط ساده کرد — پیشبینی نویز — و ریاضیات آن را پیراسته کردند. در سال 2020 این ایده صرفاً یک کار جالب بود؛ در 2021 نمونههایی در سطح SOTA ساخت؛ در 2022 به Stable Diffusion تبدیل شد؛ و در 2026 بستر اصلی کل این حوزه است.
مفهوم اصلی
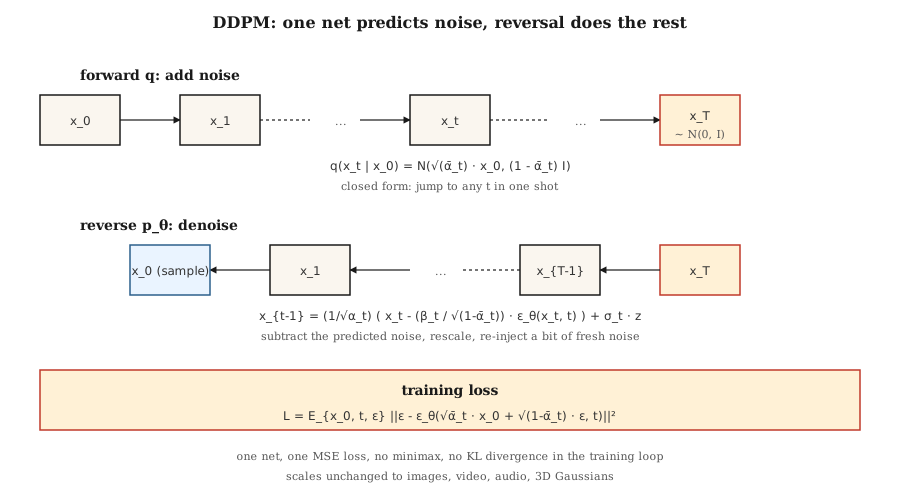
فرآیند رو به جلو . نویز گاوسی را طی گام کوچک اضافه کنید. دلیل اینکه ریاضیات مسئله حلشدنی باقی میماند، وجود فرم بسته (closed-form) است: گام تجمیعی نیز خود گاوسی است:
که در آن برای برنامهی زمانبندیِ (schedule) تعریف میشود. اگر را بهصورت خطی از 1e-4 تا 0.02 طی گام انتخاب کنید، مقدار تقریباً برابر خواهد بود.
فرآیند معکوس . شبکهی عصبیِ را برای پیشبینی نویز اضافهشده آموزش دهید. با داشتن ، نویززدایی را به این شکل انجام دهید:
که در آن میتواند برابر یا یک واریانس یادگرفتهشده باشد. ظاهر عبارت کمی شلوغ است اما در واقع فقط محاسبات جبری است: حل معادله برای با در نظر گرفتن توزیع پسین (posterior) یعنی ، و جایگزینی با تخمین حاصل از نویز پیشبینیشده.
تابع زیان آموزش.
دادهی را از مجموعهداده نمونهگیری کنید، یک گام تصادفی بردارید، نویز را نمونه بگیرید، دادهی نویزی را یکضرب از طریق فرم بسته به دست آورید و رگرسیون را روی نویز اجرا کنید. یک تابع زیان منفرد؛ بدون مینیمکس، بدون واگرایی KL و بدون ترفند بازپارامتریسازی (reparameterization trick).
نمونهگیری. با شروع کنید. گام معکوس را از تا 1 تکرار کنید. تمام.
چرا کار میکند؟
سه شهود کلیدی وجود دارد:
-
نویززدایی آسان است؛ تولید داده سخت. در ، داده کاملاً نویز خالص است؛ شبکه باید مسئلهای پیشپاافتاده را حل کند. در ، شبکه فقط باید چند پیکسل را تمیز کند. در مقادیر میانی ، مسئله دشوار است اما گرادیانهای فراوانی از تمام سطوح نویز از میان وزنهای مشترک شبکه عبور میکنند.
-
تطبیق امتیاز در لباس مبدل. وینسنت (2011) ثابت کرد پیشبینی نویز معادل با تخمین یا همان امتیاز (score) است. معادلۀ دیفرانسیل تصادفی معکوس (reverse SDE) از این امتیاز استفاده میکند تا در جهت گرادیان چگالی بالا برود؛ نوعی گشت تصادفی (random walk) هدایتشده به سمت نواحی با احتمال بالا.
-
ساده شدن ELBO به یک MSE ساده. کران پایین متغیری کامل برای هر گام زمانی یک عبارت KL دارد. با پارامتریسازی DDPM، این عبارات KL به یک تابع MSE روی پیشبینی نویز با ضرایبی مشخص تبدیل میشوند؛ هو این ضرایب را کنار گذاشت (و آن را زیان «ساده» نامید) و کیفیت در عمل بهتر شد.
پیادهسازی از صفر
فایل code/main.py یک مدل DDPM یکبعدی را پیادهسازی میکند. دادهها توزیعی با دو مُد (two-mode mixture) هستند. «شبکه» یک MLP بسیار کوچک است که را میگیرد و نویز پیشبینیشده را تحویل میدهد. آموزش با همان تابع زیان یکخطی انجام میشود و نمونهگیری هم زنجیرهی معکوس را تکرار میکند.
گام 1: زمانبندی فرآیند رو به جلو (فرم بسته)
betas = [1e-4 + (0.02 - 1e-4) * t / (T - 1) for t in range(T)]
alphas = [1 - b for b in betas]
alpha_bars = []
cum = 1.0
for a in alphas:
    cum *= a
    alpha_bars.append(cum)
گام 2: نمونهگیری یکباره از x_t
def forward_sample(x0, t, alpha_bars, rng):
    a_bar = alpha_bars[t]
    eps = rng.gauss(0, 1)
    x_t = math.sqrt(a_bar) * x0 + math.sqrt(1 - a_bar) * eps
    return x_t, eps
گام 3: یک گام آموزش
def train_step(x0, model, alpha_bars, rng):
    t = rng.randrange(T)
    x_t, eps = forward_sample(x0, t, alpha_bars, rng)
    eps_hat = model_forward(model, x_t, t)
    loss = (eps - eps_hat) ** 2
    return loss, gradient_step(model, ...)
گام 4: نمونهگیری معکوس
def sample(model, alpha_bars, T, rng):
    x = rng.gauss(0, 1)
    for t in range(T - 1, -1, -1):
        eps_hat = model_forward(model, x, t)
        beta_t = 1 - alphas[t]
        x = (x - beta_t / math.sqrt(1 - alpha_bars[t]) * eps_hat) / math.sqrt(alphas[t])
        if t > 0:
            x += math.sqrt(beta_t) * rng.gauss(0, 1)
    return x
برای یک مسئلهی یکبعدی با 40 گام زمانی و یک MLP با 24 واحد، این مدل توزیع دو مدی را در حدود 200 ایپاک یاد میگیرد.
شرطیسازی زمانی
شبکه باید بداند در حال نویززدایی از کدام گام زمانی است. دو گزینهی استاندارد وجود دارد:
- امبدینگ سینوسی (Sinusoidal embedding). شبیه کدگذاری مکانی (positional encoding) در ترنسفورمر: . آن را از یک MLP عبور دهید و به ابعاد شبکه برودکست (broadcast) کنید.
- شرطیسازی با FiLM یا Group-Norm. در هر بلوک، امبدینگ را به مقیاس (scale) و بایاس (bias) بهازای هر کانال نگاشت کنید (روش FiLM).
کد ساده و آموزشی ما از روش سینوسی و الحاق (concat) استفاده میکند؛ مدلهای U-Net عملیاتی از FiLM بهره میبرند.
دامها و چالشها
- زمانبندی اهمیت بسیار زیادی دارد. زمانبندی خطی پیشفرض DDPM است، اما زمانبندی کسینوسی (Nichol & Dhariwal, 2021) با همان میزان محاسبات، شاخص FID بهتری میدهد. اگر کیفیت مدل در نقطهای متوقف شد، زمانبندی را تغییر دهید.
- امبدینگ گام زمانی شکننده است. ارسال مستقیم بهصورت یک عدد اعشاری (float) برای مسائل سادهی یکبعدی جواب میدهد ولی برای تصاویر با شکست مواجه میشود؛ همیشه از یک امبدینگ اصولی استفاده کنید.
- پیشبینی V در برابر پیشبینی ε. در بازههای حدی (t بسیار کوچک یا بسیار بزرگ)، نسبت سیگنال به نویز ضعیفی دارد. پیشبینی V یا همان پایدارتر است؛ مدلهای SDXL، SD3 و Flux از این روش استفاده میکنند.
- هدایت بدون طبقهبند (Classifier-free guidance). هنگام استنتاج، هم پیشبینی شرطی و هم غیرشرطی را محاسبه کنید و سپس فرمول را با اعمال نمایید. این مبحث در درس 08 بررسی میشود.
- 1000 گام بسیار زیاد است. سیستمهای عملیاتی از الگوریتمهای DDIM (بین 20 تا 50 گام)، DPM-Solver (بین 10 تا 20 گام) یا تقطیر دانش (distillation) (بین 1 تا 4 گام) استفاده میکنند. درس 12 را ببینید.
استفاده از ابزارهای واقعی
| نقش | استک رایج در سال 2026 |
|---|---|
| دیفیوژن در فضای پیکسل تصویر (کوچک و آزمایشی) | DDPM + U-Net |
| دیفیوژن نهان تصویر | انکودر VAE به همراه U-Net یا DiT (درس 07) |
| دیفیوژن نهان ویدیو | DiT مکانی-زمانی (Sora، Veo، WAN) |
| دیفیوژن نهان صدا | Encodec به همراه ترنسفورمر دیفیوژن |
| علوم پایه (مولکولها، پروتئینها، فیزیک) | دیفیوژن هموردا (EDM، RFdiffusion، AlphaFold3) |
دیفیوژن بکبون (backbone) زایشی جهانشمول است. تطبیق جریان (درس 13) رقیب سالهای 2024 تا 2026 آن به شمار میرود که معمولاً با کیفیت یکسان، در سرعت استنتاج برنده میشود.
خروجی این درس
فایل outputs/skill-diffusion-trainer.md را ذخیره کنید. این مهارت، یک مجموعهداده و بودجهی محاسباتی را تحویل میگیرد و این موارد را خروجی میدهد: نوع زمانبندی (خطی/کسینوسی/سیگموئید)، هدف پیشبینی (ε/v/x)، تعداد گامها، مقیاس هدایت (guidance scale)، خانوادهی نمونهگیر، و پروتکل ارزیابی.
تمرینها
- ساده. در فایل
code/main.pyمقدار T را از 40 به 10 تغییر دهید. کیفیت نمونهها (هیستوگرام بصری خروجیها) چگونه افت میکند؟ در چه مقداری از T ساختار دو مدی فرومیپاشد؟ - متوسط. پیشبینی را از ε به v تغییر دهید. گام معکوس را از نو استخراج کنید. کیفیت نمونههای نهایی را مقایسه کنید.
- سخت. هدایت بدون طبقهبند را اضافه کنید. مدل را روی برچسب کلاس شرطی کنید، در 10% مراحل آموزش برچسب را نادیده بگیرید، و هنگام نمونهگیری از بهره ببرید. نرخ تولید مُد شرطی را در بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| فرآیند رو به جلو (Forward process) | «اضافه کردن نویز» | زنجیرهی مارکوف ثابت که داده را نابود میکند. |
| فرآیند معکوس (Reverse process) | «نویززدایی» | زنجیرهی آموزشدیدهی که داده را بازسازی میکند. |
| زمانبندی β | «نردبان نویز» | واریانس در هر گام؛ خطی، کسینوسی یا سیگموئید. |
| α̅ | «آلفا بار» | حاصلضرب تجمیعی ؛ ارائهی فرم بستهی از روی . |
| زیان ساده (Simple loss) | «خطای MSE روی نویز» | ؛ تمام بسطهای متغیری به همین فرمول ختم میشوند. |
| پیشبینی ε | «پیشبینی نویز» | خروجی مدل، نویز اضافهشده است؛ حالت استاندارد DDPM. |
| پیشبینی V | «پیشبینی سرعت» | خروجی مدل برابر است؛ شرطیسازی پایدارتر در تمام طول t. |
| DDPM | «مقالهی اصلی» | کار Ho et al. 2020؛ زمانبندی β خطی، 1000 گام، U-Net. |
| DDIM | «نمونهگیر معین (deterministic)» | نمونهگیر غیرمارکوفی، 20 تا 50 گام، با همان هدف آموزشی یکسان. |
| هدایت بدون طبقهبند (CFG) | «ضریب CFG» | ترکیب پیشبینیهای نویز شرطی و غیرشرطی برای تقویت شرط. |
نکتهی فنی محیط عملیاتی: استنتاج دیفیوژن در اصل مسئلهی تعداد گامهاست
مقالهی DDPM از T=1000 گام معکوس استفاده میکند. هیچکس در محیط عملیاتی چنین کاری نمیکند. هر استک استنتاج واقعی یکی از این سه استراتژی را در پیش میگیرد — که هر کدام دقیقاً مشخص میکند منشأ تاخیر (latency) کجاست:
- نمونهگیر سریعتر، مدل یکسان. ابزارهایی مثل DDIM (بین 20 تا 50 گام)، ++DPM-Solver (بین 10 تا 20 گام) و UniPC (بین 8 تا 16 گام). اینها جایگزین مستقیم حلقهی معکوس هستند و به وزنهای آموزشدیدهی دست نمیزنند. تاخیر را 20 تا 50 برابر کاهش میدهند.
- تقطیر دانش (Distillation). آموزش یک مدل شاگرد تا رفتار استاد را در گامهای کمتری بازسازی کند: تقطیر تدریجی (2 ← 1)، مدلهای سازگاری (هر تعداد گام ← 1 تا 4)، LCM، SDXL-Turbo و SD3-Turbo. تاخیر را 5 تا 10 برابر دیگر کم میکند ولی نیازمند بازآموزی است.
- کش کردن و کامپایل. استفاده از
torch.compile(unet, mode="reduce-overhead")، بکاندهای دیفیوژن در TensorRT-LLM، اتنشنهایxformers/SDPA و وزنهای bf16. تاخیر هر گام را حدود 2 برابر کم میکند و با موارد (1) و (2) نیز ترکیب میشود.
برای یک سرور دیفیوژن عملیاتی، فرمولبندی بودجه و هزینهها دقیقاً مشابه متون فنی مدلهای زبانی است: تاخیر برابر است با num_steps × step_cost + VAE_decode، و نرخ پردازش (throughput) از رابطهی batch_size × (num_steps × step_cost)^-1 به دست میآید. معیار TTFT کم است (معادل زمان یک گام)؛ اما معادل TPOT برابر با کل زمان پاسخدهی است، چون تولید تصویر از دیدگاه کاربر «یکجا و آنی» انجام میشود.
برای مطالعهی بیشتر
- سول-دیکستین و همکاران (2015). Deep Unsupervised Learning using Nonequilibrium Thermodynamics — مقالهی دیفیوژن، فراتر از زمانهی خود.
- هو، جین و اَبیل (2020). Denoising Diffusion Probabilistic Models — مقالهی DDPM.
- سانگ، منگ و اِرمون (2021). Denoising Diffusion Implicit Models — مقالهی DDIM و کاهش گامها.
- نیکول و داریوال (2021). Improved DDPM — زمانبندی کسینوسی و واریانس یادگرفتنی.
- داریوال و نیکول (2021). Diffusion Models Beat GANs on Image Synthesis — هدایت با طبقهبند (classifier guidance).
- هو و سالیمنز (2022). Classifier-Free Diffusion Guidance — هدایت بدون طبقهبند (CFG).
- کاراس و همکاران (2022). Elucidating the Design Space of Diffusion-Based Generative Models (EDM) — نمادگذاری یکپارچه و تمیزترین دستورالعمل پیادهسازی.