
پردازش مستقیم شکلموج خام صدا برای مدلهای زایشی امروزی ناممکن است؛ یک فایل صوتی 5 ثانیهای با کیفیت متوسط شامل دهها هزار نمونه است که طول زمینه ترنسفورمرها را بلافاصله پر میکند. راهکار مدرن این چالش در سیستمهای هوش مصنوعی صوتی، فشردهسازی دادهها به توکنهای گسسته با استفاده از کدکهای عصبی صوتی (Neural Audio Codecs) است.
در این درس ساختار کدکهایی مثل Encodec و DAC را بررسی میکنید و میبینید چگونه توکنهای برآمده از کوانتیزاسیون برداری باقیمانده (RVQ)، توسط مدلهای خودبازگشتی و مدلهای مبتنی بر تطبیق جریان (Flow Matching) به گفتار طبیعی، افکت صوتی یا قطعات موسیقی تبدیل میشوند.
برای توسعهدهندگان ایرانی، دسترسی مستقیم به APIهای تجاری پردازش صوت مانند ElevenLabs یا سرویس صوتی OpenAI با چالشهایی مثل عدم امکان پرداخت مستقیم با کارتهای بانکی داخلی یا اختلالات مقطعی شبکه روبهروست. شناخت ساختار این خط لولهها امکان میدهد از مدلهای وزنباز مثل MusicGen یا ابزارهای محلی استفاده کنید و سیستمهای خود را بدون وابستگی کامل به زیرساختهای ابری خارجی پیادهسازی نمایید.
صوت یک سیگنال 1-D با نرخ 16 تا 48 kHz است. یک کلیپ 5 ثانیهای شامل 80 تا 240 هزار نمونه است. هیچ ترنسفورمری نمیتواند مستقیماً به چنین توالی بلندی توجه کند. راهکار تمام مدلهای پروداکشن صوتی در سال 2026 یکسان است: یک کدک عصبی (Encodec، SoundStream، DAC) صدا را با نرخ 50 تا 75 Hz به توکنهای گسسته فشرده میکند، و سپس یک ترنسفورمر یا مدل دیفیوژن (Diffusion Model) این توکنها را تولید میکند.
صورت مسئله
سه تسک تولید صوت:
- تبدیل متن به گفتار (Text-to-speech): تولید گفتار بر اساس متن ورودی. گفتار شفاف پهنای باند محدودی دارد و از ساختار آوایی قوی بهره میبرد؛ ترنسفورمر روی توکنها این مسئله را بهخوبی حل میکند. مثل VALL-E (از مایکروسافت)، NaturalSpeech 3، ElevenLabs و OpenAI TTS.
- تولید موسیقی: تولید موسیقی بر اساس یک پرامپت (متن، ملودی، توالی آکورد، سبک). توزیع داده در اینجا بسیار گستردهتر است. مثل MusicGen (از متا)، Stable Audio 2.5، Suno v4، Udio و Riffusion.
- افکتهای صوتی / طراحی صدا: تولید صدای محیطی یا فولی (Foley) بر اساس یک پرامپت. مثل AudioGen، AudioLDM 2 و Stable Audio Open.
هر سه تسک روی یک بستر مشترک اجرا میشوند: کدک عصبی صدا + تولیدکنندهی خودبازگشتی بر پایهی توکن (Token-AR) یا دیفیوژن.
مفاهیم پایه
کدکهای عصبی صدا
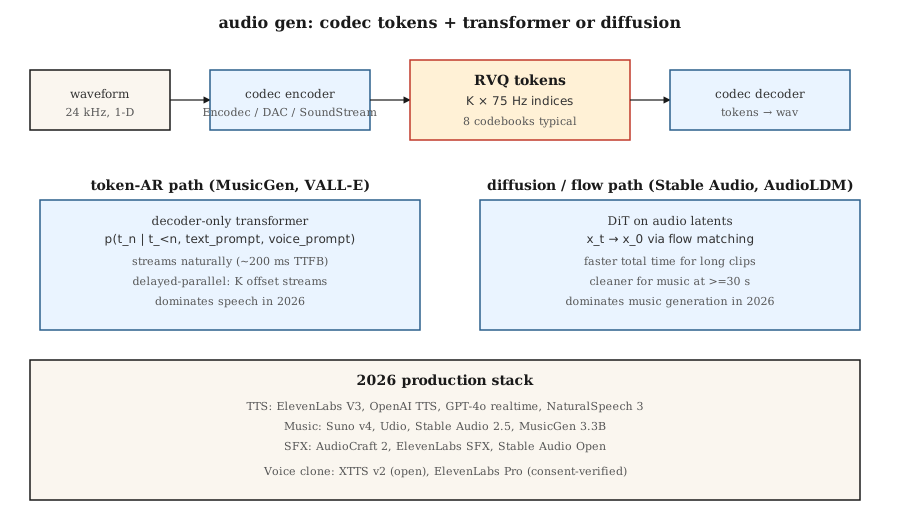
Encodec (متا، 2022)، SoundStream (گوگل، 2021) و Descript Audio Codec یا DAC (سال 2023). یک انکودر کانولوشنی، شکل موج صوتی را به یک بردار در هر گام زمانی فشرده میکند؛ سپس کوانتیزاسیون برداری باقیمانده (Residual Vector Quantization یا RVQ) هر بردار را به آبشاری از K ایندکسِ کتابکد (Codebook) تبدیل میکند. دیکودر این فرایند را معکوس میکند. صدای 24 kHz با بیتریت 2 kbps با استفاده از 8 کتابکد RVQ در نرخ 75 Hz، معادل 600 توکن در ثانیه است.
waveform (16000 samples/sec)
    └─ encoder conv ─┐
                     ├─ RVQ layer 1 → indices at 75 Hz
                     ├─ RVQ layer 2 → indices at 75 Hz
                     ├─ ...
                     └─ RVQ layer 8
دو پارادایم زایشی مکمل
خودبازگشتی مبتنی بر توکن. توکنهای RVQ را به یک توالی تخت (Flatten) تبدیل کنید و یک ترنسفورمر فقطدیکودر (Decoder-only) روی آن اجرا کنید. مدل MusicGen از روش «موازی تاخیریافته» (Delayed parallel) برای تولید همزمان K استریم کتابکد با آفستهای مجزا به ازای هر استریم استفاده میکند. مدل VALL-E توکنهای گفتار را از یک پرامپت متنی بههمراه یک نمونه صدای 3 ثانیهای میسازد.
دیفیوژن نهان (Latent Diffusion). توکنهای کدک را بهصورت متغیرهای نهان پیوسته بستهبندی کنید یا آنها را با دیفیوژن دستهای (Categorical diffusion) مدلسازی کنید. مدل Stable Audio 2.5 از تطبیق جریان (Flow matching) روی فضاهای نهان پیوستهی صوتی استفاده میکند. مدل AudioLDM 2 دیفیوژن را بهصورت متن به اسپکتروگرام مل و سپس به صدا اجرا میکند.
روند سالهای 2024 تا 2026: روش تطبیق جریان در حوزهی موسیقی گوی سبقت را ربوده است (اینفرنس سریعتر، خروجیهای شفافتر)، در حالی که رویکرد خودبازگشتی توکنی همچنان بر گفتار مسلط است؛ زیرا ذاتاً علیتی (Causal) است و بهخوبی استریم میشود.
چشمانداز مدلهای پروداکشن
| سیستم | تسک | بکبون | تاخیر |
|---|---|---|---|
| ElevenLabs V3 | گفتار (TTS) | خودبازگشتی توکنی + ووکوودر عصبی | حدود 300 ms تا اولین توکن |
| صوت OpenAI GPT-4o | گفتار دوطرفه همزمان (Full-duplex) | خودبازگشتی چندوجهی سرتاسری (End-to-end) | حدود 200 ms |
| NaturalSpeech 3 | گفتار (TTS) | تطبیق جریان در فضای نهان | غیر استریمینگ |
| Stable Audio 2.5 | موسیقی / افکت صوتی | ترنسفورمر دیفیوژن (DiT) + تطبیق جریان روی فضاهای نهان صوتی | حدود 10 s برای کلیپ 1 دقیقهای |
| Suno v4 | آهنگ کامل | نامشخص؛ احتمالاً خودبازگشتی توکنی | حدود 30 s برای هر آهنگ |
| Udio v1.5 | آهنگ کامل | نامشخص | حدود 30 s برای هر آهنگ |
| MusicGen 3.3B | موسیقی | خودبازگشتی توکنی روی Encodec با فرکانس 32 kHz | بلادرنگ |
| AudioCraft 2 | موسیقی + افکت صوتی | تطبیق جریان | حدود 5 s برای کلیپ 5 ثانیهای |
| Riffusion v2 | موسیقی | دیفیوژن روی اسپکتروگرام | حدود 10 s |
پیادهسازی
فایل code/main.py ایدهی اصلی را شبیهسازی میکند: آموزش یک ترنسفورمر کوچک پیشبینی توکن بعدی روی توالیهایی از «توکنهای صوتی» سنتزی که بر اساس دو «سبک» کاملاً مجزا تولید شدهاند (تناوب توکنهای پایین و بالا برای سبک A، شیب یکنواخت صعودی برای سبک B). سپس بر اساس سبک شرطیسازی کرده و نمونهبرداری کنید.
گام 1: توکنهای صوتی سنتزی
def make_tokens(style, length, vocab_size, rng):
    if style == 0:  # "speech-like": alternating
        return [i % vocab_size for i in range(length)]
    # «مشابه موسیقی»: شیب
    return [(i * 3) % vocab_size for i in range(length)]
گام 2: آموزش یک پیشبین توکن کوچک
یک پیشبین به سبک بایگرام (Bigram) که بر اساس سبک شرطیسازی شده است. اصل ماجرا الگو است: توکنهای کدک ← آموزش با آنتروپی متقاطع (Cross-Entropy) ← نمونهبرداری خودبازگشتی.
گام 3: نمونهبرداری شرطی
با در دست داشتن توکن سبک و یک توکن آغازین، توکن بعدی را از توزیع پیشبینیشده نمونهبرداری کنید. این کار را برای 20 تا 40 توکن ادامه دهید.
چالشها و دامها
- کیفیت کدک سقف کیفیت خروجی را تعیین میکند. اگر کدک نتواند صدایی را دقیق بازنمایی کند، کیفیت بالای مدل زایشی هم دردی را دوا نمیکند. در حال حاضر DAC بهترین گزینهی متنباز است.
- تجمع خطای RVQ. هر لایه در RVQ باقیماندهی لایهی قبل را مدل میکند. خطای لایهی 1 به لایههای بعدی سرایت میکند. نمونهبرداری با دمای 0 روی لایههای بالاتر به مهار این مشکل کمک میکند.
- ساختار موسیقی. 30 ثانیه توکن با نرخ 75 Hz معادل بیش از 20 هزار توکن است؛ پردازش این حجم برای ترنسفورمرها دشوار است. MusicGen از پنجرهی لغزان (Sliding window) همراه با ادامهی پرامپت استفاده میکند؛ Stable Audio کلیپهای کوتاهتر میسازد و آنها را فید متقاطع (Crossfade) میکند.
- آرتیفکت در مرزهای اتصال. فید متقاطع بین کلیپهای تولیدشده نیازمند روش دقیق همپوشانی و جمع (Overlap-add) است.
- اشتهای سیریناپذیر برای دادههای پاک. مدلهای تولید موسیقی به دهها هزار ساعت موسیقی دارای لایسنس نیاز دارند. شکایت RIAA از Suno و Udio در سال 2024 این مسئله را آشکار کرد.
- اخلاق کلون کردن صدا. یک نمونهی 3 ثانیهای بههمراه یک پرامپت متنی برای کلون کردن صدا با VALL-E، XTTS یا ElevenLabs کافی است. تمام مدلهای پروداکشن به سیستمهای تشخیص سوءاستفاده و لیستهای عدم رضایت (Opt-out) نیاز دارند.
استفادهی عملی
| تسک | استک سال 2026 |
|---|---|
| تبدیل متن به گفتار تجاری | ElevenLabs، OpenAI TTS یا Azure Neural |
| کلون کردن صدا (با رضایت تاییدشده) | XTTS v2 (متنباز) یا ElevenLabs Pro |
| موسیقی پسزمینه، سریع | API مدل Stable Audio 2.5، Suno یا Udio |
| موسیقی با شعر | Suno v4 یا Udio v1.5 |
| افکتهای صوتی / Foley | ابزار AudioCraft 2، ElevenLabs SFX یا Stable Audio Open |
| ایجنت صوتی بلادرنگ | GPT-4o realtime یا Gemini Live |
| پژوهش روی موسیقی با وزنهای متنباز | MusicGen 3.3B، Stable Audio Open 1.0، AudioLDM 2 |
| دوبله / ترجمه | HeyGen، ElevenLabs Dubbing |
تحویل به پروداکشن
فایل outputs/skill-audio-brief.md را ذخیره کنید. این مهارت بریف صوتی (تسک، مدتزمان، سبک، صدا، لایسنس) را دریافت کرده و این موارد را تحویل میدهد: انتخاب مدل و هاستینگ، فرمت پرامپت (تگهای سبک، توصیفکنندهها، نشانگرهای ساختاری)، زنجیرهی کدک + تولیدکننده + ووکوودر، پروتکل سید و برنامهی ارزیابی (MOS، امتیاز CLAP، معیار CER برای TTS، و تست A/B کاربران).
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید و سبک را صریحاً مشخص نمایید. بررسی کنید که آیا توالیهای تولیدشده با الگوی آن سبک همخوانی دارند یا خیر. - متوسط. دیکودینگ موازی تاخیریافته را اضافه کنید: 2 استریم توکن را شبیهسازی کنید که باید به اندازهی 1 گام از یکدیگر آفست داشته باشند. یک پیشبین مشترک آموزش دهید.
- سخت. با کتابخانهی Transformers از HuggingFace، مدل MusicGen-small را بهصورت محلی اجرا کنید. یک کلیپ 10 ثانیهای با سه پرامپت مختلف بسازید و میزان انطباق با سبک را با تست A/B ارزیابی کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای فنی دقیق |
|---|---|---|
| Codec | «فشردهسازی عصبی» | انکودر / دیکودر صوت؛ خروجی معمول آن توکنهایی با نرخ 50 تا 75 Hz است. |
| RVQ | «کوانتیزاسیون باقیمانده» | آبشاری از K کوانتیایزر؛ هرکدام خطای باقیماندهی کوانتیایزر قبلی را مدل میکند. |
| Token | «یک نماد کدک» | ایندکس گسسته در کتابکد؛ معمولاً 1024 یا 2048. |
| Delayed parallel | «کتابکدهای با آفست» | تولید K استریم توکن با آفستهای پلکانی برای کاهش طول توالی. |
| Flow matching | «برگ برندهی 2024 برای صوت» | جایگزینی با مسیر مستقیمتر برای دیفیوژن؛ نمونهبرداری سریعتر. |
| Voice prompt | «نمونهی 3 ثانیهای» | امبدینگ گوینده یا پیشوندی از توکنها که صدای کلونشده را هدایت میکند. |
| Mel spectrogram | «نمایش بصری» | اسپکتروگرام ادراکی لگاریتمی از بزرگی؛ مورد استفاده در بسیاری از سیستمهای TTS. |
| Vocoder | «تبدیل مل به موج» | کامپوننت عصبی که اسپکتروگرامهای مل را دوباره به صوت تبدیل میکند. |
نکتهی پروداکشن: صوت یک مسئلهی استریمینگ است
صوت تنها مدالیتهی خروجی است که کاربران انتظار دارند آن را همگام با تولید دریافت کنند، نه یکجا در انتهای کار. در اصطلاح پروداکشن، این یعنی معیار TPOT (زمان به ازای هر توکن خروجی) حیاتی است؛ زیرا سرعت شنیدن کاربر نرخ پردازش هدف به حساب میآید، نه سرعت خواندن او. برای صدای 16 kHz که با نرخ حدود 75 توکن در ثانیه توکنایز شده است (مثل Encodec)، سرور باید حداقل 75 توکن بر ثانیه برای هر کاربر تولید کند تا پخش صدا پیوسته و روان بماند.
این نکته دو پیامد معماری دارد:
- مدلهای صوتی تطبیق جریان را نمیتوان بهسادگی استریم کرد. Stable Audio 2.5 و AudioCraft 2 یک کلیپ با طول ثابت را در یک مرحله رندر میکنند. برای استریم، باید کلیپ را تکهتکه کرده و مرزها را روی هم بیندازید — یعنی دیفیوژن با پنجرهی لغزان — که 100 تا 300 ms اورهد تاخیر در مقایسه با یک مدل AR مبتنی بر کدک اضافه میکند.
اگر محصول «چت صوتی زنده» یا «ادامهدادن بلادرنگ موسیقی» است، مسیر کدک AR را پیش بگیرید. اما اگر هدف «رندر کردن کلیپ 30 ثانیهای پس از ارسال درخواست» است، تطبیق جریان از نظر کیفیت و تاخیر کل برنده خواهد بود.
برای مطالعهی بیشتر
- Défossez et al. (2022). Encodec: High Fidelity Neural Audio Compression — استاندارد کدکها.
- Zeghidour et al. (2021). SoundStream — نخستین کدک صوتی عصبی پرکاربرد.
- Kumar et al. (2023). High-Fidelity Audio Compression with Improved RVQGAN (DAC) — کدک DAC.
- Wang et al. (2023). Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers (VALL-E) — مدل VALL-E.
- Copet et al. (2023). Simple and Controllable Music Generation (MusicGen) — مدل MusicGen.
- Liu et al. (2023). AudioLDM 2: Learning Holistic Audio Generation with Self-supervised Pretraining — مدل AudioLDM 2.
- Stability AI (2025). Stable Audio 2.5 — تبدیل متن به موسیقی با تطبیق جریان در سال 2025.