
مدلهای سنتی دیفیوژن مانند DDPM برای تولید یک تصویر ناچارند مسیری خمیده و تصادفی را در دهها یا صدها گام طی کنند. این تعداد بالای گامها در زمان استنتاج، گلوگاه بزرگی برای تأخیر و هزینههای محاسباتی ایجاد میکند؛ مشکلی که معماریهای مدرن سال 2024 به بعد مانند Stable Diffusion 3 و Flux.1 را به سمت تکنیکهای تطبیق جریان یا فلو مچینگ (Flow Matching) سوق داد.
فلو مچینگ با تعریف درونیابی مستقیم بین نویز و داده، نیاز به شبیهسازیهای سنگین حین آموزش را حذف میکند و به کمک روشهایی مانند جریان تصحیحشده (Rectified Flow)، امکان استنتاج با کیفیت بالا را تنها در 2 تا 4 گام اولر فراهم میسازد. در این درس، مبانی نظری، تفاوت جبری آن با دیفیوژن استاندارد و نحوه پیادهسازی عملی آن را بررسی میکنید.
مدلهای دیفیوژن (Diffusion Models) به 20 تا 50 گام نمونهگیری نیاز دارند، چون مسیری منحنی را از نوفه (noise) تا داده طی میکنند. تطبیق جریان یا فلو مچینگ (Flow matching؛ لیپمن و همکاران، 2023) و جریان تصحیحشده (Rectified Flow؛ لیو و همکاران، 2022) مسیرهایی مستقیم را آموزش دادند. مسیرهای مستقیمتر یعنی گامهای کمتر و استنتاج سریعتر. در سال 2024، مدلهای Stable Diffusion 3، Flux.1 و AudioCraft 2 همگی به فلو مچینگ مهاجرت کردند.
صورت مسئله
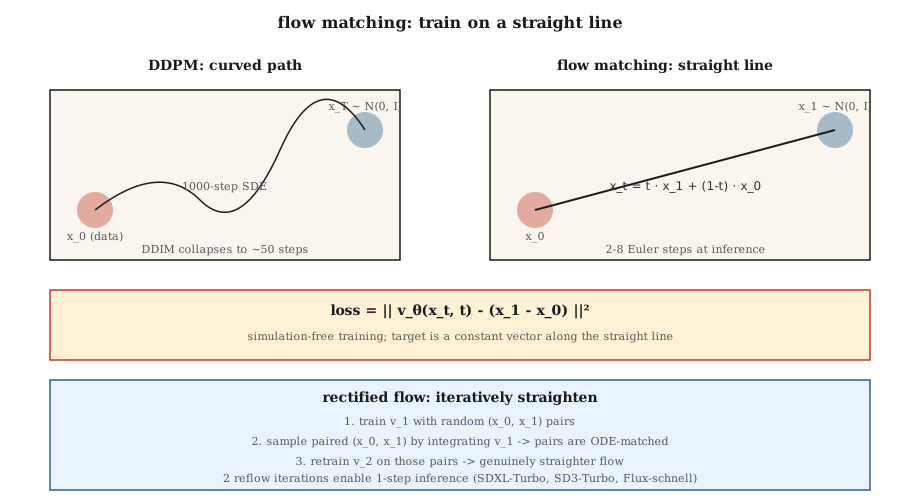
فرآیند معکوس در مدلهای DDPM یک پیمایش تصادفیِ 1000 گامه از به سمت توزیع داده است. مدل DDIM این مسیر را به 20 تا 50 گام قطعی کاهش داد. شما گامهای کمتری میخواهید؛ در حالت ایدهآل فقط یک گام. مانع اصلی این است که معادله دیفرانسیل معمولی (ODE) حاکم بر فرآیند معکوس، یک معادلهی سفت (stiff) است و مسیر انحنا دارد.
اگر بتوانید مدل را طوری آموزش دهید که مسیر حرکت از نوفه تا داده یک خط مستقیم باشد، یک گام اولر (Euler step) ساده از به کفایت میکند. فلو مچینگ دقیقاً همین را میسازد: یک درونیابی خط مستقیم میان و تعریف کنید، یک میدان برداری (vector field) با نماد را برای انطباق با مشتق زمانی آن آموزش دهید و در زمان استنتاج، از آن انتگرال بگیرید.
جریان تصحیحشده (لیو، 2022) یک قدم فراتر میرود: با تکرار فرآیندی به نام جریاندهی مجدد (reflow)، مسیرها را صافتر میکند تا ODE رفتهرفته به رفتار خطی نزدیکتر شود. پس از دو بار تکرار reflow، یک نمونهگیر (sampler) دوگامه میتواند با کیفیت یک DDPM پنجاهگامه برابری کند.
مفاهیم پایه
جریان خط مستقیم
تعریف میکنیم:
که در آن و است. مشتق زمانی در امتداد این خط مستقیم همواره ثابت میماند:
حال یک میدان برداری عصبی تعریف میکنیم و آن را طوری آموزش میدهیم که بر این مشتق منطبق شود:
این رابطه همان تابع زیان (loss) فلو مچینگ شرطی (Conditional flow matching؛ لیپمن، 2023) است. آموزش در این روش بدون شبیهسازی (simulation-free) انجام میشود؛ یعنی در طول آموزش هیچ نیازی به باز کردن گامبهگام ODE ندارید. فقط کافی است را نمونهگیری کنید و رگرسیون را انجام دهید.
نمونهگیری
در زمان استنتاج، روی میدان برداری یادگرفتهشده در جهت معکوس زمان انتگرالگیری کنید:
از شروع کنید و با گامهای اولر به سمت پایین بیایید.
جریان تصحیحشده (لیو، 2022)
جریان خط مستقیم کار میکند، اما مسیرهای یادگرفتهشده در عمل کاملاً مستقیم نیستند؛ این مسیرها خمیده میشوند چون ممکن است چندین مختلف به یک یکسان متصل شوند. مرحلهی reflow در جریان تصحیحشده اینگونه عمل میکند:
- مدل جریان را با جفتهای تصادفی آموزش دهید.
- با انتگرالگیری از از نقطهی تا رسیدن به مقصد آن یعنی ، تعداد N جفت دادهی تولید کنید.
- مدل را روی این نمونههای جفتشده آموزش دهید. چون جفتها اکنون «منطبق بر ODE» هستند، درونیاب خط مستقیم بین آنها واقعاً صافتر خواهد بود.
- این فرآیند را تکرار کنید.
در عمل، 2 بار تکرار reflow مسیر را به حالت تقریباً خطی میرساند و امکان استنتاج با 2 تا 4 گام را فراهم میسازد. مدلهای SDXL-Turbo، SD3-Turbo و LCM همگی مدلهایی هستند که با تقطیر دانش (distillation) از فلو مچینگ ساخته شدهاند.
چرا این روش در سال 2024 برندهی حوزهی تصویر شد
سه دلیل:
- آموزش بدون شبیهسازی: نیازی به باز کردن ODE در طول آموزش نیست و پیادهسازی آن بسیار ساده است.
- هندسهی بهتر تابع زیان: مسیرهای مستقیم نسبت سیگنال به نوفهی یکنواختی دارند؛ در حالی که تابع زیان ε در DDPM در لبههای بازهی زمانی، SNR نامناسبی پیدا میکند.
- استنتاج سریعتر: 4 تا 8 گام با کیفیت SDXL-Turbo؛ 1 گام با تقطیر سازگاری (consistency distillation).
فلو مچینگ در برابر DDPM؛ ارتباط ریاضی دقیق
فلو مچینگ با یک مسیر شرطی گوسی، در واقع همان دیفیوژن با یک برنامهی نوفهی مشخص است. برنامهی را انتخاب کنید تا فلو مچینگ دقیقاً دیفیوژنِ بازفرمولبندیشده به شیوهی استراتونوویچ (Stratonovich) همراه با را بازتولید کند. این دو برای مسیرهای گوسی از نظر جبری کاملاً معادلاند.
ارزش افزودهی فلو مچینگ: شفافیتِ متغیر هدف (یک بردار سرعت ساده)، یک تابع زیان تمیزتر و اجازهی آزمایش با درونیابهای غیرگوسی.
پیادهسازی
فایل code/main.py فلو مچینگ تکبعدی را روی یک مدل آمیختهی گوسی دومودی پیادهسازی میکند. میدان برداری یک MLP کوچک است که با متغیر هدفِ خط مستقیم آموزش میبیند. در مرحلهی استنتاج، با 1، 2، 4 و 20 گام اولر انتگرالگیری کنید و کیفیت نمونهها را بسنجید.
گام 1: تابع زیان آموزش
def train_step(x0, net, rng, lr):
x1 = rng.gauss(0, 1)
t = rng.random()
x_t = t * x1 + (1 - t) * x0
target = x1 - x0
pred = net_forward(x_t, t)
loss = (pred - target) ** 2
# انتشار به عقب + بهروزرسانیگام 2: استنتاج چندگامه
def sample(net, num_steps):
    x = rng.gauss(0, 1)
    for i in range(num_steps):
        t = 1.0 - i / num_steps
        dt = 1.0 / num_steps
        x -= dt * net_forward(x, t)
    return x
گام 3: مقایسهی تعداد گامها
انتظار داشته باشید که نمونهگیر 4 گامه با کیفیت 20 گامه برابری کند؛ دستاوردی بزرگ برای کاهش تاخیر (latency).
دامها
- پارامترسازی زمان: فلو مچینگ از استفاده میکند که در آن نشاندهندهی داده و نشاندهندهی نوفه است. DDPM از استفاده میکند که داده و نوفه است. جهت یکی است اما مقیاسها تفاوت دارند. مقالهها مدام این را اشتباه میگیرند.
- انتخاب برنامهی زمانی: خط مستقیمِ جریان تصحیحشده، برنامهی استاندارد فلو مچینگ است؛ اما میتوانید برای پوشش بهتر مقیاسها، از نمونهگیری زمانی کسینوسی یا لاجیت-نرمال استفاده کنید (کاری که SD3 انجام میدهد).
- هزینهی reflow: ساخت دیتاست جفتشده برای reflow، به ازای هر نمونه نیازمند یک دور استنتاج کامل است. فقط زمانی به سراغ reflow بروید که واقعاً به استنتاج 1 یا 2 گامه نیاز دارید.
- راهنمایی بدون طبقهبند (Classifier-free guidance) همچنان اعمال میشود: کافی است در ترکیب خطی، را با جایگزین کنید: .
کاربردها
| کاربرد | ابزارهای استاندارد 2026 |
|---|---|
| تبدیل متن به تصویر، بالاترین کیفیت | فلو مچینگ: SD3، Flux.1-dev |
| تبدیل متن به تصویر، 1 تا 4 گام | فلو مچینگ تقطیرشده: Flux.1-schnell، SD3-Turbo، SDXL-Turbo |
| استنتاج بلادرنگ | تقطیر سازگاری از پایهی فلو مچینگ (LCM، PCM) |
| تولید صوت | فلو مچینگ: Stable Audio 2.5، AudioCraft 2 |
| تولید ویدیو | ترکیب فلو مچینگ با دیفیوژن (Sora، Veo، Stable Video) |
| علوم پایه و فیزیک (مسیر ذرات، مولکولها) | فلو مچینگ + میدان برداری هموردا (equivariant) |
هر وقت در مقالات سالهای 2025 و 2026 عبارت «سریعتر از دیفیوژن» را دیدید، تقریباً همیشه با فلو مچینگ + تقطیر دانش طرف هستید.
تحویل پروژه
فایل outputs/skill-fm-tuner.md را ذخیره کنید. این مهارت مشخصات مدلی از جنس دیفیوژن را میگیرد و آن را به کانفیگ آموزش فلو مچینگ تبدیل میکند: انتخاب برنامهی زمانی، توزیع نمونهگیری زمان (یکنواخت / لاجیت-نرمال)، بهینهساز، برنامهی reflow، تعداد گامهای هدف و شیوهنامهی ارزیابی.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید و خطای میانگین مربعات (MSE) نمونهگیری 1 گامه و 20 گامه را نسبت به توزیع واقعی داده بسنجید. - متوسط. نمونهگیری یکنواخت را به لاجیت-نرمال تغییر دهید (این کار نمونهگیری را روی مقادیر میانی t متمرکز میکند). آیا کیفیت مدل بهتر میشود؟
- سخت. یک مرحله reflow را پیادهسازی کنید: با حل عددی اولین مدل، جفتهای را بسازید، مدل دوم را روی این جفتها آموزش دهید و کیفیت نمونهگیری 1 گامه را مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای فنی دقیق |
|---|---|---|
| فلو مچینگ (Flow matching) | «دیفیوژن با خط مستقیم» | آموزش برای انطباق با در امتداد یک درونیاب. |
| جریان تصحیحشده (Rectified flow) | «جریاندهی مجدد (Reflow)» | فرآیندی تکرارشونده که جریانهای یادگرفتهشده را صاف میکند. |
| میدان سرعت (Velocity field) | «v_θ» | خروجی مدل؛ جهتی که باید را در امتداد آن حرکت داد. |
| درونیاب خط مستقیم (Straight-line interpolant) | «مسیر» | رابطهی ؛ مشتق هدفِ بدیهی. |
| نمونهگیر اولر (Euler sampler) | «حلکنندهی ODE مرتبه اول» | سادهترین انتگرالگیر؛ وقتی مسیرها مستقیم باشند عالی کار میکند. |
| t لاجیت-نرمال (Logit-normal t) | «نمونهگیری SD3» | متمرکز کردن نمونهگیری به سمت مقادیر میانی؛ جایی که گرادیانها قویترین هستند. |
| تقطیر سازگاری (Consistency distillation) | «نمونهگیر 1 گامه» | آموزش یک مدل دانشآموز برای نگاشت مستقیم هر به . |
| CFG با سرعت (CFG with velocity) | «v-CFG» | استفاده از رابطهی ؛ همان ترفند قبلی با متغیری جدید. |
یادداشت محیط عملیاتی: Flux.1-schnell اوج سرعت در فلو مچینگ است
برگ برندهی فلو مچینگ در محیط عملیاتی، Flux.1-schnell است؛ یک ترنسفورمر دیفیوژن (DiT) مبتنی بر فلو مچینگ که به 1 تا 4 گام استنتاج تقطیر شده، در حالی که کیفیت در سطح Flux-dev را حفظ میکند. نوتبوک نیلز با عنوان «اجرای Flux روی سیستمی با 8 گیگابایت حافظه»، دستورالعمل مرجع استقرار است: کدگذاری با T5 و CLIP، نوفهزدایی با MMDiT کوانتایزشده (در 4 گام برای schnell در مقایسه با 50 گام برای dev) و دیکود با VAE. حسابوکتاب هزینهها:
| نسخه | گامها | تاخیر روی L4 در ابعاد 1024² | مجموع محاسبات تئوری (FLOPs نسبی) |
|---|---|---|---|
| Flux.1-dev (خام) | 50 | حدود 15 ثانیه | 1.0× |
| Flux.1-schnell | 4 | حدود 1.2 ثانیه | 0.08× (12 برابر سریعتر) |
| SDXL-base | 30 | حدود 4 ثانیه | 0.25× |
| SDXL-Lightning دوگامه | 2 | حدود 0.3 ثانیه | 0.03× |
قاعدهی محیط عملیاتی: پایهی فلو مچینگ + تقطیر دانش = استاندارد پیشفرض سال 2026 برای تبدیل سریع متن به تصویر. همهی شرکتهای مطرح این ترکیب را عرضه میکنند: SD3-Turbo (ترکیب SD3 + جریان + تقطیر)، Flux-schnell (ترکیب Flux-dev + صافسازی با جریان تصحیحشده) و CogView-4-Flash. پایههای دیفیوژن خالص فقط برای چکپوینتهای قدیمی باقی ماندهاند.
برای مطالعهی بیشتر
- Liu, Gong, Liu (2022). Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow — جریان تصحیحشده.
- Lipman et al. (2023). Flow Matching for Generative Modeling — فلو مچینگ.
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — مدل SD3 و جریان تصحیحشده در مقیاس بالا.
- Albergo, Vanden-Eijnden (2023). Stochastic Interpolants — چارچوبی عمومی که فلو مچینگ و دیفیوژن را پوشش میدهد.
- Song et al. (2023). Consistency Models — تقطیر 1 گامهی دیفیوژن / جریان.
- Sauer et al. (2023). Adversarial Diffusion Distillation (SDXL-Turbo) — نسخهی توربو.
- Black Forest Labs (2024). Flux.1 models — فلو مچینگ در محیط عملیاتی.