
مدلهای مولد سنتی مانند VAE اغلب تصاویری تار تولید میکنند، زیرا بهینهسازی بر اساس خطای میانگین مربعات (MSE) ذاتاً به سمت میانگینگیری از دادهها میل میکند. شبکههای مولد متخاصم (GAN) این نقص را با طراحی یک بازی دونفره بین مولد و تفکیککننده دور زدند و توانستند تصاویری با وضوح و جزئیات بسیار بالا خلق کنند.
اگرچه مدلهای انتشار بخش عمدهای از فضای تولید تصویر را تسخیر کردهاند، درک سازوکار GAN هنوز حیاتی است. امروزه آموزش متخاصم زیربنای مدلهای تقطیرشده و فوقسریع مانند SDXL-Turbo است که میتوانند فرایند چندمرحلهای انتشار را به استنتاجی تکضرب و کمهزینه تبدیل کنند.
ترفند گودفلو (Goodfellow) در سال 2014 دور زدن کامل تخمین چگالی احتمال بود: دو شبکه. یکی دادهی جعلی میسازد، دیگری مچش را میگیرد. آنقدر با هم رقابت میکنند تا نمونههای جعلی از واقعی غیرقابلتشخیص شوند. روی کاغذ نباید جواب بدهد؛ خیلی وقتها هم جواب نمیدهد. اما وقتی کار میکند، شفافترین و دقیقترین نمونههای موجود در مقالات را برای دامنههای محدود تولید میکند.
صورت مسئله
خروجی مدلهای VAE تار است، چون تابع زیان MSE در بخش دیکودر از نظر بیزی برای تصویر «میانگین» بهینه است؛ و میانگین چند رقمِ محتمل، یک رقم محو و ناواضح خواهد بود. شما به تابع زیانی نیاز دارید که به «باورپذیری» پاداش دهد، نه نزدیکی پیکسلبهپیکسل به یک هدف خاص. برای باورپذیری هیچ فرم بستهای (closed-form) وجود ندارد؛ باید آن را یاد بگیرید.
ایدهی گودفلو این بود: یک طبقهبند آموزش دهید تا تصاویر واقعی را از جعلی تشخیص دهد. یک مولد هم آموزش دهید تا را فریب دهد. سیگنال تابع زیان برای همان برداشتی است که در حال حاضر از یک تصویر «واقعی» دارد. این سیگنال با پیشرفت مدام بهروزرسانی میشود و یک هدف متحرک را دنبال میکند. اگر هر دو شبکه همگرا شوند، توزیع داده را بدون نوشتن حتی یک رابطهی log p(x) یاد گرفته است.
به این سازوکار آموزش متخاصم (adversarial training) میگویند. مدل ریاضی آن یک بازی مینیماکس (minimax) است:
در سال 2026، شبکههای GAN دیگر بهترین مولدهای روز (SOTA) نیستند (مدلهای انتشار و تطبیق جریان این تاج را ربودهاند). با این حال، StyleGAN 2/3 هنوز هم شفافترین مدلهای چهره به شمار میروند، تفکیککنندههای GAN بهعنوان «توابع زیان ادراکی» در آموزش مدلهای انتشار به کار میروند، و آموزش متخاصم موتور محرک روشهای تقطیر تکمرحلهای سریع (مثل SDXL-Turbo، SD3-Turbo و LCM) است که امکان عرضهی مدلهای انتشارِ بلادرنگ را فراهم میکنند.
مفهوم پایه
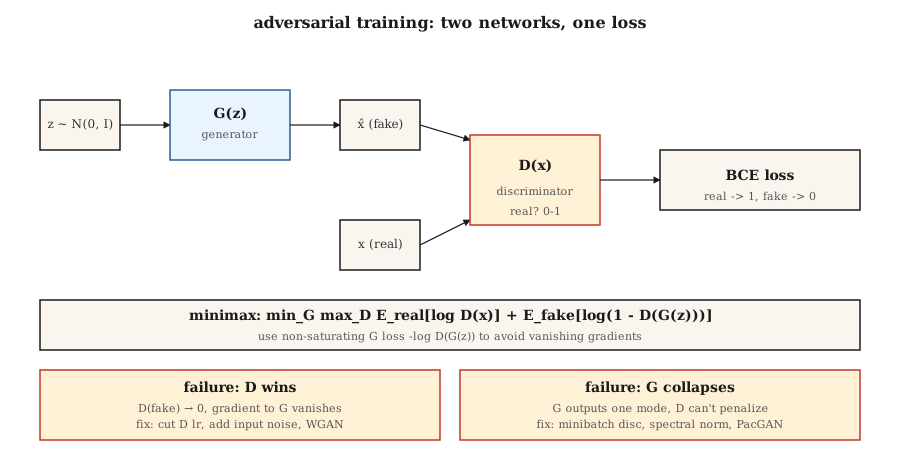
مولد . بردار نویز را به یک نمونهی نگاشت میکند. شبکهای با معماری شبیه دیکودر (متراکم یا کانولوشن ترانهاده).
تفکیککننده . نمونه را به یک احتمال اسکالر (یا امتیاز) نگاشت میکند؛ واقعی ← 1، جعلی ← 0.
تابع زیان (loss). دو بهروزرسانی متناوب:
- آموزش : . آنتروپی متقاطع دودویی (Binary Cross-Entropy) با برچسب 1 برای واقعی و 0 برای جعلی.
- آموزش : . این همان فرم «غیراشباعکننده» است که گودفلو استفاده کرد (فرم اصلیِ وقتی اطمینان بالایی دارد، اشباع میشود و گرادیانها را از بین میبرد).
حلقهی آموزش. یک گام برای ، یک گام برای . تکرار مداوم.
دلیل کارکرد. اگر کاملاً با منطبق شود، عملکردی بهتر از شانس نخواهد داشت و همهجا خروجی 0.5 میدهد؛ در نتیجه دیگر گرادیانی به نمیرسد. نقطهی تعادل.
دلایل شکست. فروپاشی مُد (Mode collapse) (وقتی یک مُد را پیدا میکند که قادر به تشخیصش نیست و مدام همان را ضرب میکند)، محو شدگی گرادیان (Vanishing gradient) (وقتی بیش از حد سریع یاد میگیرد و اشباع میشود)، و ناپایداری آموزش (بهخاطر نرخ یادگیری، اندازهی بچ یا هر عامل دیگر).
انواعی که GAN را به بازدهی رساندند
| سال | نوآوری | مشکلی که حل شد |
|---|---|---|
| 2015 | DCGAN | استفاده از لایههای کانولوشن/دیکانولوشن، Batch norm و LeakyReLU؛ اولین معماری پایدار. |
| 2017 | WGAN، WGAN-GP | جایگزینی BCE با فاصلهی واسرشتاین (Wasserstein Distance) بههمراه جریمهی گرادیان؛ حل مشکل محو شدگی گرادیان. |
| 2017 | نرمالسازی طیفی (Spectral normalization) | مقید کردن تفکیککننده به شرط لیپشیتز؛ روشی که هنوز در تفکیککنندههای سال 2026 استفاده میشود. |
| 2018 | Progressive GAN | آموزش ابتدا با وضوح پایین و سپس افزودن تدریجی لایهها؛ نخستین نتایج مگاپیکسلی. |
| 2019 | StyleGAN / StyleGAN2 | شبکهی نگاشت بههمراه نرمالسازی تطبیقی نمونهها (AdaIN)؛ بهترین سطح تصویرسازی واقعگرایانه برای دامنههای ثابت. |
| 2021 | StyleGAN3 | بدون تغییر پلهای (Alias-free) و هموردای انتقالی؛ هنوز هم تا سال 2026 استاندارد طلایی چهره است. |
| 2022 | StyleGAN-XL | شرطی، آگاه از کلاس و در مقیاس بزرگتر. |
| 2024 | R3GAN | بازآفرینی با منظمسازی (regularization) قویتر؛ کار روی وضوح 1024² بدون نیاز به ترفندهای جانبی. |
پیادهسازی از صفر
اسکریپت code/main.py یک GAN بسیار کوچک را روی دادههای 1 بعدی (ترکیبی از دو توزیع گوسی) آموزش میدهد. مولد و تفکیککننده، MLPهایی با یک لایهی پنهان هستند. ما گذر رو به جلو (forward pass)، پسانتشار و حلقهی مینیماکس را دستی مینویسیم. هدف این است که دو حالت شکست اصلی (فروپاشی مُد + محو شدگی گرادیان) را همانطور که رخ میدهند مشاهده کنیم.
گام 1: تابع زیان غیراشباعکننده
تابع زیان پایهی گودفلو یعنی ، وقتی D با اطمینان بالا تصویر جعلی G را شناسایی کند، به سمت 0 میل میکند. در این نقطه، گرادیان G عملاً صفر است؛ یعنی G دیگر نمیتواند پیشرفت کند. فرم غیراشباعکنندهی رفتار مجانبی معکوسی دارد: وقتی D اطمینان بالایی دارد منفجر میشود و سیگنال قدرتمندی به G میدهد.
def g_loss(d_fake):
    # maximize log D(G(z))  <=>  minimize -log D(G(z))
    return -sum(math.log(max(p, 1e-8)) for p in d_fake) / len(d_fake)
گام 2: یک گام تفکیککننده بهازای هر گام مولد
for step in range(steps):
    # train D
    real_batch = sample_real(batch_size)
    fake_batch = [G(z) for z in sample_noise(batch_size)]
    update_D(real_batch, fake_batch)

    # train G
    fake_batch = [G(z) for z in sample_noise(batch_size)]  # fresh fakes
    update_G(fake_batch)
باید برای G نمونههای جعلی تازه بسازید، وگرنه گرادیانها کهنه میشوند.
گام 3: زیر نظر گرفتن فروپاشی مُد
if step % 200 == 0:
    samples = [G(z) for z in sample_noise(500)]
    mode_a = sum(1 for s in samples if s < 0)
    mode_b = 500 - mode_a
    if min(mode_a, mode_b) < 50:
print(" [!] mode collapse: one mode is starved")نشانهی کلاسیک این مشکل: تولید یکی از دو مُدِ واقعی متوقف میشود. تفکیککننده هم اصلاح آن را متوقف میکند، چون دیگر اصلاً بهعنوان دادهی جعلی دیده نمیشود.
دامهای رایج
- تفکیککنندهی بیش از حد قوی. نرخ یادگیری D را 2 تا 5 برابر کاهش دهید، یا به ورودیها/لایهها نویز اضافه کنید. اگر دقت D به بالای 95% برسد، کار G تمام است.
- بهخاطرسپاری یک مُد توسط مولد. به ورودیهای D نویز بیفزایید، از لایهی تفکیککنندهی مینیبچ استفاده کنید، یا سراغ WGAN-GP بروید.
- نشت آمار در Batch norm. عبور بچِ دادههای واقعی و بچِ دادههای جعلی از یک لایهی BN مشترک، آمارههای آنها را با هم ترکیب میکند. بهجای آن از Instance norm یا نرمالسازی طیفی استفاده کنید.
- بازی با امتیازهای Inception. معیارهای FID و IS در تعداد نمونههای کم دچار نوسان و نویز بالایی هستند؛ برای ارزیابی حداقل از 10k نمونه استفاده کنید.
- نمونهگیری تکمرحلهای در وظایف شرطی دروغی بیش نیست. برای گرفتن خروجی قابلاستفاده، هنوز هم به مقیاسهای CFG، ترفندهای هرس (truncation) و نمونهگیری مجدد نیاز دارید.
استفاده از ابزارهای واقعی
ترکیب پیشنهادی GAN در سال 2026:
| موقعیت | ابزار انتخابی |
|---|---|
| چهرههای واقعگرایانهی انسان با ژست ثابت | StyleGAN3 (شفافترین، سبکترین) |
| چهرههای انیمهای / سبکدار | StyleGAN-XL یا LoRA روی Stable Diffusion |
| تبدیل تصویر به تصویر | Pix2Pix / CycleGAN (فاز 8 · 04) یا ControlNet (فاز 8 · 08) |
| تبدیل متن به تصویر سریع و 1 مرحلهای | تقطیر متخاصم از مدل انتشار (SDXL-Turbo، SD3-Turbo) |
| تابع زیان ادراکی درون ترینر مدل انتشار | تفکیککنندهی کوچک GAN روی برشهایی از تصویر (crops) |
| هر تسک چندوجهی و بیپایان | استفاده نکنید؛ سراغ مدلهای انتشار یا تطبیق جریان بروید |
مدلهای GAN تصاویری بسیار شفاف و شارپ میسازند، اما دامنهشان محدود است. بهمحض اینکه دامنهی کار گسترده شد (عکسهای عمومی، پرامپتهای متنی دلخواه، ویدیو)، سراغ مدلهای انتشار بروید. ترفند متخاصم همچنان زنده است، اما نه بهعنوان یک مولد مستقل، بلکه در قالب یک مؤلفه (توابع زیان ادراکی، تقطیر دانش).
عرضهی نهایی
فایل outputs/skill-gan-debugger.md را ذخیره کنید. این مهارت مشخصات یک فرایند ناموفق GAN (شامل منحنیهای تابع زیان، ماتریس نمونهها و حجم دیتاست) را دریافت میکند و فهرستی رتبهبندیشده از دلایل احتمالی، راهحلهای کوتاه تکخطی و پروتکل اجرای مجدد تحویل میدهد.
تمرینها
- ساده. اسکریپت
code/main.pyرا با تنظیمات پیشفرض اجرا کنید. سپس مقدارD_LR = 5 * G_LRرا قرار دهید و دوباره اجرا کنید. تابع زیان G با چه سرعتی روی یک مقدار ثابت متوقف و فریز میشود؟ - متوسط. تابع زیان BCE گودفلو را با تابع زیان WGAN جایگزین کنید: و ، و وزنهای D را روی بازهی
[-0.01, 0.01]برش دهید (clip). آیا آموزش پایدارتر میشود؟ زمان واقعی (wall-clock) رسیدن به همگرایی را مقایسه کنید. - سخت. این مثال 1 بعدی را به دادههای 2 بعدی (ترکیب 8 گوسی روی یک حلقه) تعمیم دهید. بررسی کنید مولد چند مورد از این 8 مُد را در گامهای 1k، 5k و 10k پوشش میدهد. تفکیک مینیبچ (minibatch discrimination) را پیادهسازی و دوباره آزمایش کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | تعریف دقیق فنی |
|---|---|---|
| مولد (Generator) | «شبکهی G» | شبکهی تبدیل نویز به نمونه، G: z → x̂. |
| تفکیککننده (Discriminator) | «شبکهی D» | طبقهبند D: x → [0, 1]، تفکیک دادهی واقعی از جعلی. |
| مینیماکس (Minimax) | «بازی» | روی یک تابع هدف مشترک. |
| تابع زیان غیراشباعکننده (Non-saturating loss) | «راهحل مشکل» | استفاده از برای G بهجای . |
| فروپاشی مُد (Mode collapse) | «G روی یک چیز قفل کرده» | مولد با وجود تنوع دادهها، خروجیهای بسیار محدودی تولید میکند. |
| مدل WGAN | «واسرشتاین» | جایگزینی BCE با فاصلهی جابهجایی بار (Earth-Mover) بههمراه جریمهی گرادیان؛ گرادیانهای هموارتر. |
| نرمالسازی طیفی (Spectral norm) | «ترفند لیپشیتز» | مقید کردن نُرم وزنهای D برای مهار شیب آن؛ پایدارسازی آموزش. |
| مدل StyleGAN | «مدلی که جواب میده» | شبکهی نگاشت بههمراه AdaIN؛ هنوز تا سال 2026 برترین ابزار برای چهره. |
نکتهی پروداکشن: استنتاج تکضرب، مزیت ماندگار GAN
در تولید محتوا برای دامنههای نامحدود، شبکههای GAN دیگر از نظر کیفیت نمونه برنده نیستند، اما از نظر هزینهی استنتاج همچنان دست بالا را دارند. با ادبیات فنی حوزهی استنتاج در محیط پروداکشن، یک GAN این ویژگیها را دارد:
- حذف مراحل prefill و decode. فقط یک گذر رو به جلو در . در نتیجه TTFT تقریباً برابر با کل تاخیر (latency) خواهد بود.
- نبود بار روی حافظهی کش KV. تنها متغیر موجود، وزنهای مدل است. محدودیت اندازهی بچ (batch size) فقط با حافظهی اکتیویشن تعیین میشود، نه کش.
- Continuous batching بسیار ساده. چون مصرف FLOPs برای تمام درخواستها مقداری کاملاً ثابت است، معمولاً تشکیل یک بچ استاتیک بر اساس ظرفیت هدف سرور بهترین بازدهی را دارد؛ نیازی هم به اسکژولر (scheduler) برای درخواستهای در حال اجرا (in-flight) نیست.
به همین دلیل است که تقطیر GAN (مثل SDXL-Turbo، SD3-Turbo، ADD و LCM) در سال 2026 تکنیک مسلط برای تولید سریع متن به تصویر است: این روش یک پایپلاین انتشار 20 تا 50 مرحلهای را تنها به 1 تا 4 گذر رو به جلو از نوع GAN فشرده میکند، درحالیکه توزیع مدل پایهی انتشار را هم حفظ میکند. تابع زیان متخاصم هنوز زنده است؛ ابزاری در زمان آموزش برای تبدیل مولدهای کند به سیستمهایی فوقسریع.
برای مطالعهی بیشتر
- گودفلو و همکاران (2014). Generative Adversarial Nets — مقالهی اصلی GAN.
- رادفورد و همکاران (2015). Unsupervised Representation Learning with DCGAN — نخستین معماری پایدار.
- آرجوفسکی، شینتالا و بوتو (2017). Wasserstein GAN — مدل WGAN.
- میاتو و همکاران (2018). Spectral Normalization for GANs — نرمالسازی طیفی (SN).
- کاراس و همکاران (2020). Analyzing and Improving the Image Quality of StyleGAN — مدل StyleGAN2.
- کاراس و همکاران (2021). Alias-Free Generative Adversarial Networks — مدل StyleGAN3.
- زاور و همکاران (2023). Adversarial Diffusion Distillation — مدل SDXL-Turbo.