
اجرای مدلهای دیفیوژن مستقیماً روی پیکسلهای خام تصاویر با رزولوشن بالا، نیازمند توان پردازشی سرسامآوری است که برای اکثر توسعهدهندگان توجیه اقتصادی ندارد. مدلهای دیفیوژن نهان (Latent Diffusion) با انتقال فرایند نویززدایی به یک فضای فشردهتر با ابعاد کوچکتر، بار محاسباتی را بهشدت کاهش میدهند و کیفیت بصری را کاملاً حفظ میکنند. شناخت این معماری کلید درک سازوکار مدلهای معروفی مثل Stable Diffusion و Flux است.
در عمل، توسعهدهندگان هنگام کار با این مدلها با چالشهایی مثل مدیریت حافظهی گرافیکی و هزینه اجرای سنگین روبهرو میشوند. برای کاربرانی که دسترسی به سرویسهای ابری خارجی یا GPUهای پیشرفته برایشان دشوار و پرهزینه است، پیادهسازی تکنیکهایی مثل کوانتایز 4 بیتی، تخلیه حافظه روی پردازنده اصلی (CPU Offload) و بارگذاری مرحلهبهمرحله اجازه میدهد حتی مدلهای چند ده میلیاردی را روی کارتهای گرافیک مصرفی خانگی اجرا کنید.
اجرای دیفیوژن در فضای پیکسل (pixel-space) روی تصاویر 512×512 یک جنایت جنگی محاسباتی است! رومباخ و همکاران (2022) متوجه شدند که برای تولید یک تصویر اصلاً نیازی به تمام 786 هزار بُعد ندارید؛ فقط ابعادی را میخواهید که ساختار معنایی را نگه دارند، و یک دیکودر جداگانه هم بقیهی جزئیات را بازسازی کند. دیفیوژن را داخل فضای نهان (latent space) یک VAE اجرا کنید. همین یک ایده یعنی همان Stable Diffusion.
صورت مسئله
دیفیوژن در فضای پیکسل با ابعاد 512² یعنی U-Net روی تنسورهایی با ابعاد [B, 3, 512, 512] اجرا میشود. هر گام نمونهگیری برای یک U-Net با 500 میلیون پارامتر حدود 100 گیگافلاپس (GFLOPS) پردازش میبرد. 50 گام یعنی 5 ترافلاپس (TFLOPS) به ازای هر تصویر. حالا مدل را روی یک میلیارد تصویر آموزش دهید تا ببینید هزینهی پردازش سر به فلک میکشد.
بیشتر این فلاپسها صرف عبور دادن جزئیاتی از شبکه میشوند که از نظر ادراکی چندان اهمیتی ندارند؛ یعنی همان بافتهای فرکانسبالایی که یک VAE اتلافی میتواند آنها را فشرده و حذف کند. ایدهی رومباخ ساده بود: یک بار VAE را آموزش دهید (مرحلهی اول)، وزنش را فریز کنید، و بعد دیفیوژن را تماماً در فضای نهان 4 کاناله با ابعاد 64×64 اجرا کنید (مرحلهی دوم). با همان U-Net، فقط با یکشانزدهم تعداد پیکسلها، به کیفیتی مشابه میرسید؛ آن هم با حدود 64 برابر فلاپس کمتر.
این همان فرمول ساخت Stable Diffusion است. نسخههای SD 1.x / 2.x از یک U-Net با 860 میلیون پارامتر روی فضاهای نهان 64×64×4 استفاده کردند، SDXL از یک U-Net با 2.6 میلیارد پارامتر روی 128×128×4 بهره برد، و SD3 این U-Net را با یک ترنسفورمر دیفیوژن (Diffusion Transformer یا DiT) با تطبیق جریان (flow matching) جایگزین کرد. مدل Flux.1-dev (از Black Forest Labs، سال 2024) با یک DiT-MMDiT دوازده میلیارد پارامتری عرضه شد. همهی اینها روی همان بستر دومرحلهای کار میکنند.
مفاهیم پایه
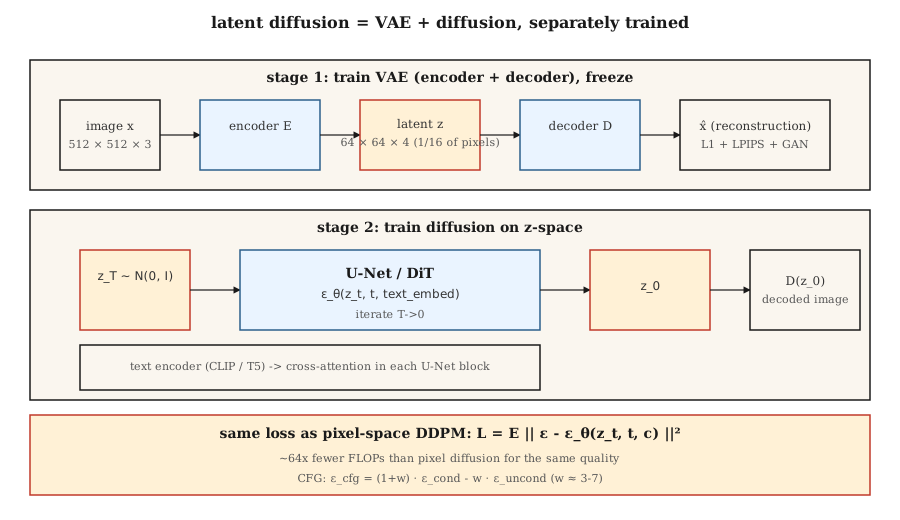
دو مرحله که جداگانه آموزش میبینند:
-
مرحلهی 1 — VAE. انکودر ، دیکودر . هدف فشردهسازی: کاهش ابعاد (downsample) به میزان 8 برابر در هر بُعد فضایی + تنظیم تعداد کانالها به شکلی که حجم کل فضای نهان تقریباً یکشانزدهم تعداد پیکسلها شود. تابع زیان (loss) = بازسازی (L1 + زیان ادراکی LPIPS) + واگرایی KL (با ضریب کم تا بیش از حد وادار به توزیع گوسی نشود، چون نیازی به نمونهگیری دقیق از نداریم). معمولاً همراه با یک تابع زیان ادورساریال (adversarial loss) آموزش داده میشود تا تصاویر دیکودشده کاملاً شارپ از آب درآیند.
-
مرحلهی 2 — دیفیوژن روی . به مثل دادههای ورودی نگاه کنید. یک U-Net (یا DiT) را برای حذف نویز از آموزش دهید. در زمان استنتاج: را با دیفیوژن نمونهگیری کنید و سپس .
شرطیسازی با متن (Text conditioning). دو مؤلفهی اضافه نیاز داریم: یک انکودر متن فریزشده (CLIP-L برای SD 1.x، ترکیب CLIP-L+OpenCLIP-G برای SD 2/XL، و T5-XXL برای SD3 و Flux)، و تزریق از طریق کراساتنشن (cross-attention): هر بلوک U-Net مقادیر [Q = image features, K = V = text tokens] را میگیرد و با هم مخلوط میکند. توکنها تنها پلی هستند که متن از طریق آنها روی تصویر اثر میگذارد.
تابع زیان دقیقاً همان فرمول درس 06 است. همان خطای میانگین مربعات (MSE) نویز در DDPM یا flow matching؛ تنها چیزی که عوض شده، دامنهی دادهها است.
گونههای معماری
| مدل | سال | بکبون | شکل فضای نهان | انکودر متن | پارامترها |
|---|---|---|---|---|---|
| SD 1.5 | 2022 | U-Net | 64×64×4 | CLIP-L (77 توکن) | 860M |
| SD 2.1 | 2022 | U-Net | 64×64×4 | OpenCLIP-H | 865M |
| SDXL | 2023 | U-Net + ریفاینر | 128×128×4 | CLIP-L + OpenCLIP-G | 2.6B + 6.6B |
| SDXL-Turbo | 2023 | تقطیرشده (Distilled) | 128×128×4 | مشابه بالا | نمونهگیری در 1 تا 4 گام |
| SD3 | 2024 | MMDiT (ترنسفورمر چندوجهی) | 128×128×16 | T5-XXL + CLIP-L + CLIP-G | 2B / 8B |
| Flux.1-dev | 2024 | MMDiT | 128×128×16 | T5-XXL + CLIP-L | 12B |
| Flux.1-schnell | 2024 | MMDiT تقطیرشده | 128×128×16 | T5-XXL + CLIP-L | 12B، در 1 تا 4 گام |
روند مشخص است: جایگزینی U-Net با DiT (ترنسفورمر روی پچهای فضای نهان)، بزرگتر کردن انکودر متن (T5 در پیروی از پرامپت CLIP را پشت سر میگذارد)، و افزایش کانالهای فضای نهان (حرکت از 4 به 16، دست مدل را برای جزئیات خیلی بازتر میکند).
پیادهسازی
کد code/main.py یک «VAE» یکبعدی آموزشی (یک انکودر با مقیاس ثابت 0.5 و معکوس دقیقش به عنوان دیکودر؛ صرفاً برای نمایش ایده، چرا که VAE واقعی یک شبکهی کانوولوشنی است) را روی DDPM درس 06 میگذارد و شرطیسازی مبتنی بر کلاس را با classifier-free guidance به آن اضافه میکند. این کد نشان میدهد فرقی نمیکند روی مقادیر خام یکبعدی کار کنید یا مقادیر انکودشده؛ تابع زیان دیفیوژن در هر دو حالت جواب میدهد. ایدهی اصلی دقیقاً همین است.
گام 1: انکودر/دیکودر
def encode(x):    return x * 0.5          # toy "compression" to smaller scale
def decode(z):    return z * 2.0
یک VAE واقعی وزنهای آموزشدیده دارد. برای آموزش، همین نگاشت خطی کافی است تا نشان دهیم دیفیوژن چطور روی کار میکند بدون اینکه کوچکترین اهمیتی به فضای اولیهی دادهها بدهد.
گام 2: دیفیوژن در فضای z
همان DDPM درس 06. دادهای که شبکه دریافت میکند است. بعد از نمونهگیری ، آن را با دیکود کنید.
گام 3: هدایت بدون طبقهبند (Classifier-Free Guidance)
در طول آموزش، برچسب کلاس را در 10٪ مواقع حذف کنید (و با یک توکن پوچ یا null جایگزینش کنید). در زمان استنتاج، هر دو مقدار و را به دست آورید و سپس:
eps_cfg = (1 + w) * eps_cond - w * eps_uncondمقدار یعنی بدون هدایت (حداکثر تنوع)، حالت پیشفرض است، و خروجی را بیش از حد اشباع و زیادی شارپ میکند.
گام 4: شرطیسازی متنی (مفهوم، بدون کد)
برچسب کلاس را با خروجی یک انکودر متنِ فریزشده جایگزین کنید. امبدینگ متن را هم از طریق کراساتنشن به U-Net بفرستید:
h = h + CrossAttention(Q=h, K=text_embed, V=text_embed)تنها تفاوت بنیادین میان یک مدل دیفیوژن شرطیشده روی کلاس و Stable Diffusion همین است.
دامهای رایج
- ناهماهنگی در ضریب مقیاس VAE. مدلهای SD 1.x یک ضریب مقیاس ثابت (
scaling_factor ≈ 0.18215) دارند که بعد از انکود اعمال میشود. اگر این ضریب را از قلم بیندازید، U-Net روی دادههای نهانی آموزش میبیند که واریانسشان از زمین تا آسمان با واقعیت فرق دارد. هر چکپوینت چنین ضریبی همراه خود دارد. - خطای خاموش در انکودر متن. مدل SD3 به T5-XXL با حداقل 128 توکن نیاز دارد، و اگر مدل را فقط به CLIP محدود کنید کیفیت بهشدت افت میکند. همیشه مطمئن شوید
use_t5=Trueباشد، وگرنه میزان وفاداری به پرامپت سقوط میکند. - ترکیب فضاهای نهان ناسازگار. مدلهای SDXL، SD3 و Flux هر کدام VAE متفاوتی دارند. یک LoRA که روی فضاهای نهان SDXL آموزش دیده روی SD3 اصلاً کار نخواهد کرد. کتابخانهی diffusers در Hugging Face از نسخهی 0.30 به بعد اجازهی بارگذاری چکپوینتهای ناسازگار را نمیدهد.
- مقدار بیش از حد CFG. اگر
w > 10باشد، تصاویر بیش از حد اشباع و روغنی میشوند و مدل به قیمت قربانی کردن تنوع، روی پرامپت اورفیت میکند. بازهی ایدهآلw = 3-7است. - نشتی پرامپت منفی. اگر پرامپت منفی خالی بماند، به توکن پوچ تبدیل میشود؛ اما اگر چیزی بنویسید تبدیل به میشود. این دو با هم یکی نیستند؛ در حالی که برخی پایپلاینها بیسروصدا پیشفرض را روی توکن پوچ میگذارند.
استفادهی عملی
پشتههای نرمافزاری پروداکشن در سال 2026:
| هدف | بکبون پیشنهادی |
|---|---|
| دامنهی محدود، دادههای جفتشده، آموزش مدل از صفر | فاینتیون SDXL (به صورت LoRA یا کامل) — سریعترین مسیر تحویل |
| تولید تصویر از متن در دامنهی باز، وزنهای متنباز | Flux.1-dev (12B، با مجوز آپاچی / غیرتجاری) یا SD3.5-Large |
| سریعترین زمان استنتاج، وزنهای متنباز | Flux.1-schnell (1 تا 4 گام، آپاچی) یا SDXL-Lightning |
| بهترین وفاداری به پرامپت، سرویسهای ابری | GPT-Image / DALL-E 3 (همچنان)، Midjourney v7، Imagen 4 |
| فرایندهای ویرایش تصویر | Flux.1-Kontext (دسامبر 2024) — ورودی متن و تصویر را مستقیماً دریافت میکند |
| پژوهش، بیسلاین | SD 1.5 — قدیمی اما کاملاً بررسیشده و قابل اتکا |
محصول پایانی
فایل outputs/skill-sd-prompter.md را ذخیره کنید. این مهارت پرامپت متنی و سبک هدف را میگیرد و این موارد را تحویل میدهد: مدل و چکپوینت، مقدار ضریب CFG، نمونهگیر، پرامپت منفی، رزولوشن، ترکیب اختیاری ControlNet/IP-Adapter، و یک چکلیست تضمین کیفیت برای تکتک گامها.
تمرینها
- ساده. کد
code/main.pyرا با هدایت اجرا کنید. میانگین نمونهها را به تفکیک هر کلاس ثبت کنید. در چه مقداری از ، میانگین کلاسها از میانگین دادههای واقعی فاصله میگیرد؟ - متوسط. انکودر خطی ساده را با یک زوج انکودر/دیکودر MLP با فعالساز tanh و تابع زیان بازسازی جایگزین کنید. دیفیوژن را روی فضاهای نهان جدید بازآموزی کنید. آیا کیفیت نمونهها تغییر میکند؟
- سخت. یک پایپلاین استنتاج واقعی Stable Diffusion را با diffusers بسازید: چکپوینت
sdxl-baseرا لود کنید، 30 گام اویلر (Euler) را با CFG=7 اجرا کرده و زمان بگیرید. حالا بهsdxl-turboبا 4 گام و CFG=0 جابهجا شوید. با یک سوژهی مشترک به کیفیتهای متفاوتی میرسید — تفاوتها و دلیلشان را تحلیل کنید.
اصطلاحات کلیدی
| اصطلاح | در مکالمات روزمره | معنای دقیق فنی |
|---|---|---|
| مرحلهی اول (First stage) | «همان VAE» | زوج انکودر/دیکودر آموزشدیده که تصاویر 512² را به 64² فشرده میکند. |
| مرحلهی دوم (Second stage) | «همان U-Net» | مدل دیفیوژن که روی فضای نهان اجرا میشود. |
| CFG | «ضریب هدایت» (Guidance scale) | ضریب که شدت شرطیسازی را تنظیم میکند. |
| توکن پوچ (Null token) | «امبدینگ پرامپت خالی» | امبدینگ غیرشرطی که برای به کار میرود. |
| کراساتنشن (Cross-attention) | «روش تزریق متن» | هر بلوک U-Net با توکنهای متنی مثل K و V رفتار میکند و به آنها اتنشن میزند. |
| DiT | «ترنسفورمر دیفیوژن» | جایگزینی U-Net با ترنسفورمر روی پچهای فضای نهان؛ مقیاسپذیری بسیار بهتری دارد. |
| MMDiT | «DiT چندوجهی» | معماری مدل SD3: مسیرهای پردازش متن و تصویر مجزا ولی با اتنشن مشترک. |
| ضریب مقیاس VAE | «عدد جادویی» | مقادیر نهان را بر حدود 5.4 تقسیم میکند تا دیفیوژن در فضایی با واریانس یک کار کند. |
نکتهی پروداکشن: اجرای Flux-12B روی پردازندهی گرافیکی 8 گیگابایتی
پیادهسازی مرجع Flux بهترین پاسخ به این سوال است که «من یک GPU معمولی دارم؛ چطور این مدل را پروداکشن کنم؟». ترفند کار، همان سهگانهی معروفی است که در منابع حوزهی استنتاج برای یک DiT دیفیوژن توصیه میشود:
- بارگذاری مرحلهبهمرحله (Staggered loading). مدل Flux چهار شبکه دارد که اصلاً نیازی نیست همزمان در حافظهی گرافیکی (VRAM) جا خوش کنند: انکودر متنی T5-XXL (حدود 10 گیگابایت در حالت fp32)، انکودر کمحجم CLIP-L، شبکهی 12 میلیاردی MMDiT، و خود VAE. ابتدا پرامپت را انکود کنید، انکودرها را از حافظه حذف کنید، DiT را لود کنید، نویززدایی را پیش ببرید، DiT را حذف کنید، VAE را لود کنید و در نهایت دیکود را انجام دهید. کارتهای گرافیک 8 گیگابایتی مصرفی در هر لحظه فقط گنجایش یکی از این بخشها را دارند.
- کوانتایز 4 بیتی با bitsandbytes. تنظیم
BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.bfloat16)روی هر دوی انکودر T5 و DiT. این کار حافظه را 8 برابر کاهش میدهد، در حالی که طبق بنچمارکهای Aritra (لینکشده در نوتبوک)، افت کیفیت خروجی در تولید تصویر از متن تقریباً به چشم نمیآید. - تخلیه روی پردازندهی اصلی (CPU offload). با فعالسازی
pipe.enable_model_cpu_offload()، ماژولها حین اجرای هر گذر رو به جلو (forward pass) بهطور خودکار بین CPU و GPU دستبهدست میشوند. این کار 10 تا 20 درصد به تاخیر (latency) اضافه میکند، اما در عوض اجرای کل پایپلاین را روی چنین سختافزاری ممکن میسازد.
حسابوکتاب مصرف حافظه به این صورت است: انکودر T5 به میزان 10 گیگابایت تقسیم بر 8 = 1.25 گیگابایت کوانتایزشده، مدل DiT به صورت 12 میلیارد پارامتر ضربدر 0.5 بایت = حدود 6 گیگابایت کوانتایزشده، به اضافهی اکتیویشنها. به تعبیر stas00، این حالت نهایتِ استنتاج روی TP=1 است — یعنی بدون هیچگونه توازی مدل (model parallelism) و با حداکثر فشردهسازی و کوانتایز. در محیط پروداکشن واقعی معمولاً روی کارتهای H100 از TP=2 یا TP=4 استفاده میکنید؛ اما برای یک لپتاپ برنامهنویسی، راهکار عملی دقیقاً همین است.
برای مطالعهی بیشتر
- رومباخ و همکاران (2022). High-Resolution Image Synthesis with Latent Diffusion Models — مقالهی بنیادین Stable Diffusion.
- پودل و همکاران (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis — مقالهی SDXL.
- پیبلز و شیه (2023). Scalable Diffusion Models with Transformers (DiT) — مقالهی DiT.
- اسر و همکاران (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — مقالهی SD3 و MMDiT.
- هو و سالیمنز (2022). Classifier-Free Diffusion Guidance — مقالهی CFG.
- لبز (2024). Flux.1 — بیانیهی معرفی Black Forest Labs — خانوادهی مدلهای Flux.1.
- مستندات Diffusers در Hugging Face — پیادهسازی مرجع برای تکتک چکپوینتهای بالا.