
در شبکههای زایای متخاصم کلاسیک، متغیر پنهان به صورت یکجا به لایههای اولیه تزریق میشد. این ساختار باعث درهمتنیدگی شدید ویژگیها میشد؛ بهطوریکه تغییر زاویهی سر، رنگ پوست یا هویت فرد را هم ناخواسته دستخوش تغییر میکرد. StyleGAN با بازتعریف این فرآیند و جداسازی مولفههای سبک از ساختار کلی، امکان کنترل دقیق و مستقل ویژگیهای بصری را فراهم آورد.
این درس به شما نشان میدهد چطور شبکهی نگاشت (mapping network) و لایههای نرمالسازی انطباقی (AdaIN) فضای درهمتنیدهی ورودی را به یک فضای پنهان تفکیکشده تبدیل میکنند. همچنین با بررسی تفاوتهای StyleGAN نسخهی 1، 2 و 3، یاد میگیرید چگونه در محیطهای پروداکشن تصویری باکیفیت و با تأخیر کمتر از 10 میلیثانیه تولید کنید.
اغلب مولدها را همزمان به خورد همهی لایهها میدهند. StyleGAN این ساختار را تفکیک کرد: ابتدا را به یک فضای میانی نگاشت میکند، سپس را در هر سطح از تفکیکپذیری از طریق AdaIN تزریق میکند. همین یک تغییر، گرههای فضای پنهان را باز کرد و تولید چهرههای واقعگرایانه (photorealistic) را هفت سال متوالی به یک مسئلهی حلشده تبدیل ساخت.
صورت مسئله
مدل DCGAN با پشتهای از کانولوشنهای ترانهاده (transposed convolutions)، را به یک تصویر نگاشت میکند. مشکل اینجاست: همهچیز را کنترل میکند — زاویهی سر، نورپردازی، هویت فرد، پسزمینه — که همگی درهمتنیدهاند. اگر در امتداد یک محور از حرکت کنید، هر چهار متغیر با هم تغییر میکنند. نمیتوانید از مدل بخواهید «همان فرد، اما با زاویهی سری دیگر»؛ چون بازنمایی مدل به این شکل تفکیکپذیر نیست.
کاراس و همکاران (2019، NVIDIA) راهحلی پیشنهاد دادند: تغذیهی مستقیم لایههای کانولوشن با را متوقف کنید. در عوض، یک تنسور ثابت 4×4×512 را به عنوان ورودی شبکه بفرستید. یک MLP هشتلایهای یاد بگیرید که را مینگارد. سپس را در هر رزولوشن از طریق نرمالسازی نمونهای تطبیقی (AdaIN) تزریق کنید: هر نقشهی ویژگی (feature map) کانولوشن را نرمال کرده و سپس با تصویر کردنِ آفینِ ، مقیاس و جابهجایی آن را تغییر دهید. برای جزئیات تصادفی (روزنههای پوست، تارهای مو) هم به ازای هر لایه نویز جداگانه اضافه کنید.
نتیجه: محورهای تقریباً عمود بر هم برای «استایل سطح بالا» (زاویهی سر، هویت) در برابر «استایل ریز» (نور، رنگ) پیدا میکند. حالا میتوانید استایل دو تصویر را با هم جابهجا کنید؛ کافی است تصویر A را برای سطوح با رزولوشن پایین و تصویر B را برای سطوح با رزولوشن بالا به کار ببرید. این تغییر، قفل ویرایش، انتقال استایل بین دامنهها و کل شاخهی پژوهشی «وارونسازی StyleGAN» (StyleGAN-inversion) را باز کرد.
مفهوم
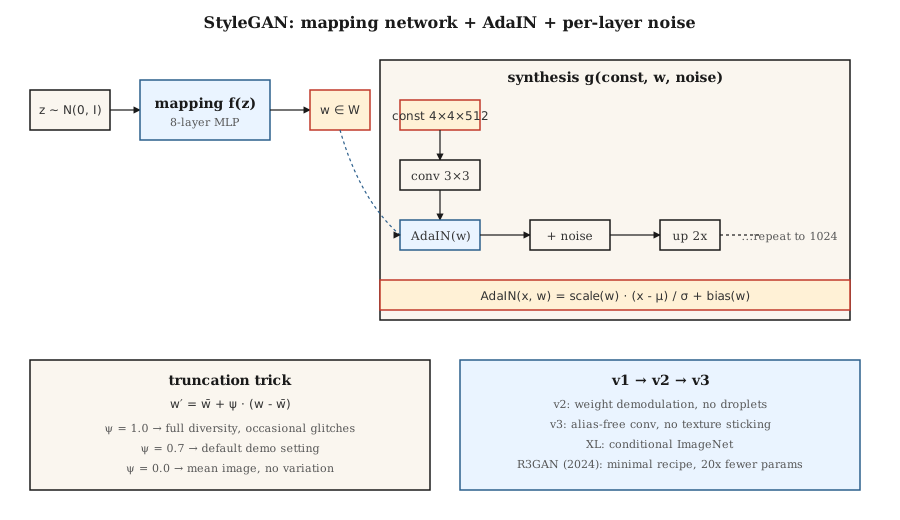
شبکهی نگاشت (Mapping network): ساختار ، یک MLP هشتلایهای. . فضای مجبور نیست حتماً گاوسی بماند — شکلی متناسب با توزیع دادهها یاد میگیرد.
شبکهی سنتز (Synthesis network): با یک مقدار ثابتِ یادگرفتنی 4×4×512 شروع میشود. هر بلوک رزولوشن: upsample → conv → AdaIN(w_i) → noise → conv → AdaIN(w_i) → noise. رزولوشنها دو برابر میشوند: 4، 8، 16، 32، 64، 128، 256، 512، 1024.
AdaIN:
که در آن و از تصویر کردن آفینِ به دست میآیند. نرمالسازی برای هر نقشهی ویژگی جداگانه انجام میشود و سپس استایلدهی مجدد صورت میگیرد. «استایل» در اینجا همان آمارههای مرتبه اول و دوم نقشهی ویژگی است.
نویزِ هر لایه: نویز گاوسی تککاناله که به هر نقشهی ویژگی اضافه شده و با یک ضریب یادگرفتنی به ازای هر کانال مقیاسبندی میشود. این سازوکار جزئیات تصادفی را بدون دستزدن به ساختار کلی تصویر کنترل میکند.
ترفند هرس (Truncation trick): در زمان استنتاج، ابتدا را نمونهگیری کنید، را به دست آورید و سپس را محاسبه کنید؛ که در آن میانگین روی تعداد زیادی نمونه است. مقدار تنوع را فدای کیفیت میکند. تقریباً در تمام دموهای StyleGAN از استفاده میشود.
روند تکامل: StyleGAN 1 → 2 → 3
| نسخه | سال | نوآوری |
|---|---|---|
| StyleGAN | 2019 | شبکهی نگاشت + AdaIN + نویز + رشد تدریجی (progressive growing). |
| StyleGAN2 | 2020 | جایگزینی AdaIN با مدولاسیونزدایی وزنها (weight demodulation برای حذف لکههای آبمانند)؛ معماری با اتصالات میانبر/باقیمانده؛ منظمسازی طول مسیر (path-length regularization). |
| StyleGAN3 | 2021 | کانولوشنهای بدون آلیاسینگ (Alias-free) + کرنلهای هموردا؛ حذف چسبندگی بافت به شبکهی پیکسلی. |
| StyleGAN-XL | 2022 | شرطیشده بر پایه کلاس، رزولوشن 1024²، ImageNet. |
| R3GAN | 2024 | بازطراحی با منظمسازی قویتر؛ بستن فاصلهی کیفی با مدلهای دیفیوژن روی FFHQ-1024 با 20 برابر پارامتر کمتر. |
در سال 2026، مدل StyleGAN3 همچنان گزینهی پیشفرض برای این موارد است: (الف) خروجی واقعگرایانه در دامنههای محدود با نرخ فریم بالا، (ب) انطباق دامنه با چند نمونه (آموزش روی دیتاست جدید با 100 تصویر، فریز کردن شبکهی نگاشت)، (ج) ویرایش مبتنی بر وارونسازی (پیدا کردن که یک عکس واقعی را بازسازی کند، سپس ویرایش همان ). اما برای تولید تصویر از متن در دامنههای باز اصلاً ابزار مناسبی نیست؛ آنجا قلمرو دیفیوژن است.
پیادهسازی از صفر
فایل code/main.py یک نسخهی ساده و تکبعدی از سبکِ StyleGAN را پیادهسازی کرده است: یک MLP نگاشت، یک تابع سنتز که بردار ثابت یادگرفتنی را میگیرد و آن را با مقیاس/بایاسِ مشتقشده از مدوله میکند، همراه با نویز هر لایه. این پیادهسازی نشان میدهد که تزریق از طریق مدولاسیون آفین با الحاق (concatenate) مستقیم به ورودی مولد برابری میکند یا حتی عملکرد بهتری دارد.
گام 1: شبکهی نگاشت
def mapping(z, M):
    h = z
    for i in range(num_layers):
        h = leaky_relu(add(matmul(M[f"W{i}"], h), M[f"b{i}"]))
    return h
گام 2: نرمالسازی نمونهای تطبیقی (AdaIN)
def adain(x, w_scale, w_bias):
    mu = mean(x)
    sd = std(x)
    x_norm = [(xi - mu) / (sd + 1e-8) for xi in x]
    return [w_scale * xi + w_bias for xi in x_norm]
مقیاس و بایاس به ازای هر نقشهی ویژگی، از طریق تصویر کردن خطیِ (linear projection) به دست میآیند.
گام 3: نویز به ازای هر لایه
def add_noise(x, sigma, rng):
    return [xi + sigma * rng.gauss(0, 1) for xi in x]
سیگما به ازای هر کانال یادگرفتنی است.
دامها و خطاهای رایج
- لکههای آبمانند (Droplet artifacts): در StyleGAN 1 به این دلیل که AdaIN میانگین را صفر میکرد، لکههایی قطرهمانند روی نقشههای ویژگی ایجاد میشد. مدولاسیونزدایی وزنها در StyleGAN 2 این مشکل را با مقیاسبندی وزنهای کانولوشن (بهجای اکتیویشنها) برطرف کرد.
- چسبندگی بافت (Texture sticking): در StyleGAN 1 و 2، بافتها مختصات پیکسلی را دنبال میکردند نه مختصات شیء را (که موقع درونیابی کاملاً مشخص بود). کانولوشنهای بدون آلیاسینگ در StyleGAN 3 به کمک فیلترهای پنجرهای sinc این ایراد را برطرف کردند.
- پوشش مُدها (Mode coverage): ترفند هرس با
ψ < 0.7خروجی بسیار تمیزی میدهد، اما از یک مخروط باریک نمونهگیری میکند؛ اگر به تنوع نیاز دارید، ازψ = 1.0استفاده کنید. - اتلاف در فرآیند وارونسازی (Lossy Inversion): وارونسازی عکس واقعی و بردن آن به فضای معمولاً با بهینهسازی یا به کمک یک انکودر (مثل e4e ،ReStyle یا HyperStyle) انجام میشود. نتایج در طول تکرارهای زیاد دچار رانش (drift) میشوند.
استفاده از ابزارهای واقعی
| کاربرد | رویکرد |
|---|---|
| چهرههای انسانی کاملاً واقعی (انیمه، عکاسی محصول، دامنههای محدود) | مدل StyleGAN3 روی FFHQ / فاینتیون اختصاصی |
| ویرایش چهره از روی عکس | وارونسازی با e4e + جهتهای StyleSpace یا InterFaceGAN |
| تعویض چهره / بازآفرینی حرکات (reenactment) | ترکیب StyleGAN + انکودر + ترکیب تصویر (blending) |
| پایپلاینهای ساخت آواتار | مدل StyleGAN3 به همراه ADA برای فاینتیون با دادهی کم |
| انطباق دامنه با چند تصویر معدود | فریز کردن شبکهی نگاشت، فاینتیون شبکهی سنتز |
| تولید تصویر چندحالته یا شرطیشده بر متن | اصلاً استفاده نکنید — از دیفیوژن استفاده کنید |
برای محصولات پروداکشن که پاسخ نهایی منحصراً «عکس چهرهی یک انسان» است، StyleGAN از نظر هزینهی استنتاج (یک گذر رو به جلو، زیر 10 میلیثانیه روی یک کارت 4090) و وضوح در کیفیتی برابر، دیفیوژن را کاملاً شکست میدهد.
خروجی این درس
فایل outputs/skill-stylegan-inversion.md را ذخیره کنید. این مهارت یک عکس واقعی دریافت میکند و خروجی میدهد: روش وارونسازی (e4e / ReStyle / HyperStyle)، تابع زیان (loss) پنهان مورد انتظار، حد مجاز ویرایش (اینکه چه مقدار در پیش بروید قبل از اینکه آرتیفکت ظاهر شود)، و فهرستی از جهتهای ویرایشی مطمئن و آزمودهشده (سن، حالت چهره، زاویهی سر).
تمرینها
- ساده. اسکریپت
code/main.pyرا با دو حالتadain_on=Trueوadain_on=Falseاجرا کنید. پراکندگی خروجیها را برای یک متغیر پنهانِ ثابت در برابر متغیر پنهانِ آشفتهشده مقایسه کنید. - متوسط. منظمسازی ترکیبی (mixing regularization) را پیادهسازی کنید: برای یک بچ آموزشی، مقادیر و را محاسبه کنید؛ سپس را برای نیمهی اول سنتز و را برای نیمهی دوم اعمال کنید. بررسی کنید که آیا دیکودر استایلهای تفکیکشده را یاد میگیرد؟
- دشوار. یک مدل ازپیشآموزشدیدهی StyleGAN3 FFHQ (فایل ffhq-1024.pkl) را بردارید. با آموزش یک SVM روی نمونههای برچسبدار، جهت بردار «لبخند» را در بیابید؛ گزارش دهید که چقدر میتوانید متغیر را بدون تغییر هویت چهره push کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها | در واقعیت چه کار میکند |
|---|---|---|
| Mapping network | «همان شبکه MLP» | ساختار با 8 لایه، ساختار هندسی فضای پنهان را از آمارههای دادهها تفکیک میکند. |
| W space | «فضای استایل» | خروجی شبکهی نگاشت؛ تا حد زیادی تفکیکشده (disentangled). |
| AdaIN | «نرمالسازی انطباقی» | نرمالسازی نقشهی ویژگی، و سپس مقیاسبندی + جابهجایی با تصویر کردنِ . |
| Truncation trick | «پارامتر سای (Psi)» | فرمول ، که در آن تنوع را فدای کیفیت میکند. |
| Path-length regularization | «منظمسازی طول مسیر» | تغییرات شدید تصویر را به ازای هر واحد تغییر در جریمه میکند؛ فضای را هموارتر میسازد. |
| Weight demodulation | «ترفند اصلاحی StyleGAN2» | نرمالسازی وزنهای کانولوشن بهجای اکتیویشنها؛ حذف آرتیفکتهای قطرهای. |
| Alias-free | «ترفند StyleGAN3» | فیلترهای پنجرهای sinc؛ حذف چسبندگی بافت به شبکهی پیکسلی. |
| Inversion | «پیدا کردن w برای عکس واقعی» | بهینهسازی یا استفاده از انکودر برای یافتن به گونهای که . |
نکتهی محیط عملیاتی: چرا در سال 2026 هنوز StyleGAN در پروداکشن استفاده میشود؟
مدل StyleGAN3 روی یک 4090 تصویری با رزولوشن 1024² از FFHQ را در کمتر از 10 میلیثانیه میسازد — یعنی num_steps = 1، بدون رمزگشایی VAE، و بدون گذرِ کراساتنشن (cross-attention). در مقیاس پروداکشن، این کمترین تاخیر (latency) ممکن برای هر مولد تصویر است. یک پایپلاین 50 مرحلهای از مدل SDXL به همراه دیکد VAE در همان رزولوشن حدود 3 ثانیه زمان میبرد. یعنی 300 برابر اختلاف؛ برای محصولات با دامنهی محدود (سرویسهای آواتار، پایپلاینهای مدارک هویتی، تولید چهرههای استوک)، این مدل از نظر هزینهی کل مالکیت برنده است.
دو پیامد عملیاتی مهم:
- نه اسکژولری در کار است، نه بچسازی. یک بچ استاتیک با حد اشغال بهینه کافی است. بچسازی پیوسته (continuous batching که برای LLMها و دیفیوژن ضروری است) هیچ فایدهای ندارد؛ چون بار محاسباتی (FLOPs) هر درخواست دقیقاً یکسان است.
- پارامتر هرس
ψپیچ تنظیم ایمنی است. شرطψ < 0.7نمونهگیری را در مخروط باریکی از دامنهی شبکهی نگاشت نگه میدارد. این تنها اهرم لایهی سرویسدهی برای کنترل واریانس نمونههاست. در ساعات اوج بار، مقدارψرا کم کنید و برای کاربران پریمیوم آن را افزایش دهید.
برای مطالعهی بیشتر
- Karras et al. (2019). A Style-Based Generator Architecture for GANs — معرفی StyleGAN.
- Karras et al. (2020). Analyzing and Improving the Image Quality of StyleGAN — معماری StyleGAN2.
- Karras et al. (2021). Alias-Free Generative Adversarial Networks — معماری StyleGAN3.
- Tov et al. (2021). Designing an Encoder for StyleGAN Image Manipulation — وارونسازی با روش e4e.
- Sauer et al. (2022). StyleGAN-XL: Scaling StyleGAN to Large Diverse Datasets — مقیاسپذیری StyleGAN-XL.
- Huang et al. (2024). R3GAN: The GAN is dead; long live the GAN! — فرمول مدرن و مینیمال برای شبکههای زایای رقیب (GAN).