
ورود به دنیای مدلهای زایشی (Generative Models) با بمبارانی از معماریها و مقالههای متنوع همراه است؛ از GAN و VAE گرفته تا مدلهای دیفیوژن و روشهای نوین تطبیق جریان (Flow Matching). بدون داشتن یک نقشهی ذهنی دقیق، درک شباهتها و تفاوتهای ریاضی این مدلها سردرگمکننده خواهد بود. این درس دقیقاً همین مشکل را حل میکند: پنج خانوادهی اصلی مدلهای زایشی را دستهبندی کرده و نشان میدهد هرکدام چه بدهبستانی میان دقت آماری و سرعت محاسباتی انجام میدهند.
فهم این ردهبندی برای هر مهندسی که قصد دارد سیستمهای زایشی را در محیط عملیاتی پیادهسازی کند ضروری است. با تحلیل رفتار استنتاج و هزینههای محاسباتی هر خانواده، متوجه خواهید شد که چرا در حوزههایی مانند تولید تصویر عمومی، ویدیو یا شبیهسازی بلادرنگ، انتخاب معماری نادرست به معنای هدررفت سنگین منابع پردازشی است.
تمام مدلهای تصویر، متن، ویدیو و سهبعدی در یکی از این پنج دسته جا میگیرند. اگر دستهی اشتباه را انتخاب کنید، هفتهها با ریاضیات سرشاخ خواهید شد؛ اما دستهی درست را برگزینید تا پیشرفتهای دوازده سال گذشتهی این حوزه خیلی تروتمیز در ذهنتان بنشیند.
صورت مسئله
یک مدل زایشی (generative model) تنها یک وظیفه دارد: گرفتن نمونههای آموزشی از یک توزیع نامشخص و تولید نمونههای جدیدی که به نظر برسد از همان توزیع آمدهاند. چهرهها، جملات، فایلهای MIDI، ساختارهای پروتئینی — اگر از دور نگاه کنید، همگی یک مسئلهاند.
چالش کار اینجاست: در فضایی با میلیونها بُعد زندگی میکند (یک تصویر رنگی 512x512 حدود 786 هزار بُعد دارد)، نمونهها روی یک خمینهی (manifold) باریک درون این فضا مینشینند، و شما شاید نهایتاً 10 میلیون نمونه داشته باشید. تخمین مستقیم چگالی با روشهای جستوجوی جامع (brute-force) محال است. هر مدل زایشی نوعی مصالحه است؛ یک مسئلهی سخت را فدا میکند تا مسئلهای با درجهی سختی کمی پایینتر را حل کند.
در دوازده سال گذشته پنج خانواده از مدلها دوام آوردهاند. وقتی بدانید هر خانواده چه مصالحهای انجام داده، متوجه میشوید چرا در بعضی کارها پیروز میدان است و در بعضی دیگر به بنبست میخورد.
مفهوم
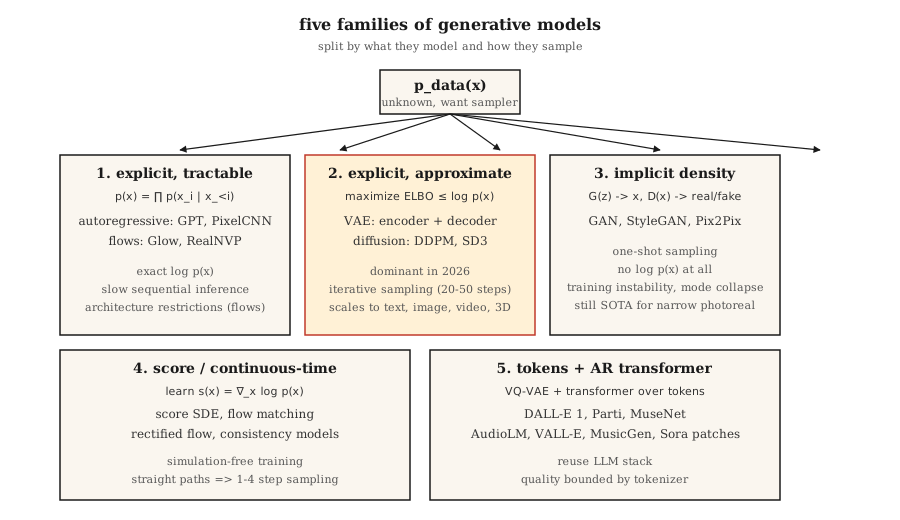
1. چگالی صریح، محاسبهپذیر. رابطهی را طوری مینویسید که واقعاً قابل محاسبه باشد. مدلهای خودبازگشتی (autoregressive) مانند PixelCNN، WaveNet و GPT توزیع را به صورت فاکتور میگیرند. جریانهای نرمالسازی (normalizing flows) نظیر RealNVP و Glow رابطهی را به صورت تبدیل معکوسپذیرِ یک توزیع پایهی ساده میسازند. مزیت: درستنمایی (likelihood) دقیق، تابع زیان (loss) تمیز در آموزش. عیب: استنتاج در مدلهای خودبازگشتی ترتیبی است (برای توالیهای طولانی کُند میشود) و جریانها به معماریهای معکوسپذیر نیاز دارند (محدودیت شدید در طراحی معماری).
2. چگالی صریح، تقریبی. برای یک کران پایین شواهد (ELBO) تعیین کرده و همان کران را بهینه میکنند. مدلهای VAE (کینگما، 2013) از یک انکودر-دیکودر با پسین (posterior) متغیر استفاده میکنند. مدلهای دیفیوژن (Diffusion Models نظیر DDPM، هو، 2020) یک حذفکنندهی نویز (denoiser) را آموزش میدهند که بهطور ضمنی یک ELBO وزندار را بهینه میکند. در سال 2026، دیفیوژن همچنان بکبون (backbone) اصلی تصویر، ویدیو و مدلهای سهبعدی است.
3. چگالی ضمنی. تخمین چگالی را کلاً دور بیندازید؛ در عوض یک مولد یاد بگیرید که نمونه بسازد و یک تمایزگر که دادهی واقعی را از ساختگی تشخیص دهد. یعنی همان شبکههای GAN (گودفلو، 2014). زمان استنتاج فوقالعاده سریع است (فقط یک گذر رو به جلو یا forward pass)، اما ناپایداری آنها هنگام آموزش زبانزد است. با این حال StyleGAN 1/2/3 حتی در سال 2026 نیز برای تصاویر واقعگرایانهی دامنههای خاص (مانند چهره یا اتاق خواب) در لبهی فناوری قرار دارند.
4. مبتنی بر اسکور / زمانپیوسته. گرادیانِ (gradient) لگاریتم چگالی (اسکور) را مستقیماً یاد میگیرند. سانگ و ارمون (2019) نشان دادند تطبیق اسکور (score matching)، دیفیوژن را به یک معادله دیفرانسیل تصادفی (SDE) تعمیم میدهد. تطبیق جریان (flow matching) معرفیشده توسط لیپمن (2023) برگ برنده و موضوع داغ سالهای 2024 تا 2026 است: آموزش بدون نیاز به شبیهسازی، مسیرهای مستقیمتر و 4 تا 10 برابر نمونهگیری سریعتر نسبت به DDPM. مدلهای Stable Diffusion 3، Flux و AudioCraft 2 همگی از تطبیق جریان استفاده میکنند.
5. خودبازگشتیِ توکنمحور روی کدهای گسسته. دادههای با ابعاد بالا را به کمک VQ-VAE یا یک کوانتایزر پسماند (residual quantizer) به توالی کوتاهی از توکنهای گسسته فشرده میکنند، سپس از یک ترنسفورمر (Transformer) برای مدلسازی این توالی توکنها بهره میگیرند. مدلهای Parti، MuseNet، AudioLM، VALL-E و توکنایزر پچ در Sora همگی از این رویکرد استفاده میکنند. این در واقع همان دستهی اول است، منتها همراه با یک توکنایزر یادگرفتهشده.
مروری کوتاه بر تاریخچه
| سال | مدل | دلیل اهمیت |
|---|---|---|
| 2013 | VAE (کینگما) | اولین مدل زایشی عمیق با تابع زیان آموزشی کاربردی. |
| 2014 | GAN (گودفلو) | چگالی ضمنی، بدون درستنمایی — خروجیهایی با وضوح شگفتانگیز. |
| 2015 | DRAW، PixelCNN | تولید ترتیبی تصویر. |
| 2017 | Glow، RealNVP | جریانهای معکوسپذیر؛ درستنمایی دقیق به کمک عمق شبکه. |
| 2017 | Progressive GAN | اولین چهرههای یک مگاپیکسلی. |
| 2019 | StyleGAN / StyleGAN2 | چهرههای واقعگرایانهای که در آن دامنهی خاص هنوز شکستدادنشان سخت است. |
| 2020 | DDPM (هو) | مدلهای دیفیوژن کاربردی و عملیاتی میشوند. |
| 2021 | CLIP، DALL-E 1، VQGAN | تبدیل متن به تصویر فراگیر میشود. |
| 2022 | Imagen، Stable Diffusion 1، DALL-E 2 | دیفیوژن نهان (Latent Diffusion) + شرطیسازی با متن = دسترسی عمومی. |
| 2022 | ControlNet، LoRA | کنترل دقیق روی مدلهای دیفیوژن ازپیشآموزشدیده. |
| 2023 | SDXL، Midjourney v5، تطبیق جریان | مقیاس بزرگتر + پویایی بهتر در آموزش. |
| 2024 | Sora، Stable Diffusion 3، Flux.1 | دیفیوژن ویدیو؛ تطبیق جریان پیروز میدان میشود. |
| 2025 | Veo 2، Kling 1.5، Runway Gen-3، Nano Banana | ویدیوهای مناسب محیط پروداکشن. |
| 2026 | Consistency + Rectified Flow | نمونهگیری تکمرحلهای از بکبونهای دیفیوژن. |
تریاژ پنجسوالی
هنگامی که مقالهی جدیدی در حوزهی مدلهای زایشی منتشر میشود، پیش از خواندن بخش روششناسی، به این پنج پرسش پاسخ دهید:
- چه چیزی مدل میشود؟ پیکسلها، متغیرهای نهان، توکنهای گسسته، پاششهای گوسی سهبعدی (Gaussian Splatting)، مشها یا شکل موج صوتی؟
- چگالی صریح است یا ضمنی؟ آیا اصلاً فرمولی برای مینویسند؟
- نمونهگیری: تکمرحلهای است یا تکرارشونده؟ تکرارشونده یعنی استنتاج کُندتر؛ تکمرحلهای معمولاً نشانهی رویکردهای رقابتی یا تقطیرشده است.
- شرطیسازی: بدون شرط، بر اساس کلاس، متن، تصویر یا وضعیت بدنی (pose)؟ این مورد نوع تابع زیان و معماری پشتیبان را تعیین میکند.
- ارزیابی: FID، امتیاز CLIP، امتیاز IS، ترجیح انسانی یا دقت تسک؟ هر کدام نقاط ضعف شناختهشدهای دارند (درس 14 را ببینید).
در طول این فصل برای هر درس به این پنج سوال پاسخ خواهید داد؛ طوری که تا پایان، این بررسی به یک واکنش ناخودآگاه تبدیل شود.
پیادهسازی از صفر
کد این درس یک بصریسازی سبک است: برازش یک توزیع ترکیبی گوسی یکبعدی از روی نمونهها با سه رویکرد ساده (برآورد چگالی کرنل یا Kernel density، هیستوگرام گسسته و یک مولد شبهGAN بر اساس نزدیکترین نمونه). هدف این است که تفاوت چگالی صریح در برابر ضمنی را در مسئلهای ببینید که خروجیاش روی یک صفحه جا میشود.
فایل code/main.py را اجرا کنید. این کد 2000 نمونه از یک ترکیب گوسی دوحالته میکشد و سپس چاپ میکند:
explicit density (histogram): p(x in [-0.5, 0.5]) ≈ 0.38
approximate density (KDE):     p(x in [-0.5, 0.5]) ≈ 0.41
implicit (nearest-sample gen): 20 new samples printed, no p(x)
دقت کنید: دو روش اول به شما اجازه میدهند بپرسید «این نقطه چقدر محتمل است؟» سومی نمیتواند. این همان تمایز صریح در برابر ضمنی است که در تمامی درسهای آینده تعیینکننده خواهد بود.
استفاده از ابزارهای واقعی
در سال 2026، کدام خانواده برای کدام تسک مناسب است؟
| تسک | بهترین خانواده | دلیل |
|---|---|---|
| چهرههای واقعگرایانه، دامنهی محدود | StyleGAN 2/3 | همچنان واضحترین خروجی، سریعترین استنتاج. |
| تبدیل متن به تصویر عمومی | دیفیوژن نهان + تطبیق جریان | SD3، Flux.1، DALL-E 3. |
| تبدیل سریع متن به تصویر | جریان تصحیحشده (Rectified Flow) + تقطیر دانش (Distillation) | SDXL-Turbo، SD3-Turbo، LCM. |
| تبدیل متن به ویدیو | ترنسفورمر دیفیوژن + تطبیق جریان | Sora، Veo 2، Kling. |
| گفتار + موسیقی | مدلهای خودبازگشتی توکنمحور (AudioLM، VALL-E، MusicGen) یا تطبیق جریان (AudioCraft 2) | مقیاسپذیری ارزان با توکنهای گسسته. |
| صحنههای سهبعدی | برازش پاشش گوسی، پیشینِ (prior) دیفیوژن | پاشش گوسی سهبعدی برای بازسازی، دیفیوژن برای زوایای دید جدید. |
| تخمین چگالی (بدون نمونهگیری) | جریانها | تنها خانوادهای که فرمول دقیق را به دست میدهد. |
| شبیهسازی / فیزیک | تطبیق جریان، SDE مبتنی بر اسکور | مسیرهای مستقیم، میدانهای برداری هموار. |
خروجی این درس
خروجی را در مسیر outputs/skill-model-chooser.md ذخیره کنید.
این مهارت شرح یک تسک را دریافت کرده و این موارد را خروجی میدهد: (1) کدام خانواده باید استفاده شود، (2) فهرستی اولویتبندیشده از سه گزینهی متنباز و سه سرویس میزبانیشده، (3) حالت شکست یا خطای احتمالی که باید حواستان به آن باشد، و (4) بودجهی زمانی و توان پردازشی مورد نیاز.
تمرینها
- ساده. برای هر یک از این پنج محصول، خانوادهی مدل و بکبون آن را مشخص کنید: بخش تصویر ChatGPT، مدل Midjourney v7، Sora، Runway Gen-3 و ElevenLabs. شواهد (evidence) باید برگرفته از گزارشهای فنی عمومی باشد.
- متوسط. مقالهای که فردا میخوانید ادعا میکند نمونهگیری را 100 برابر سریعتر از دیفیوژن انجام میدهد. سه پرسش بنویسید تا بررسی کنید آیا این افزایش سرعت، در صورت اعمال شرطیسازی و رزولوشن بالا همچنان برقرار میماند یا خیر.
- سخت. یک حوزه که برایتان اهمیت دارد را انتخاب کنید (مثلاً ساختار پروتئین، CAD، مولکولها، مسیر حرکت اشیاء). برای مدل پیشتاز (SOTA) کنونی در آن حوزه، به تریاژ پنجسوالی پاسخ دهید و طرح کلی تغییراتی را رسم کنید که در صورت ساخت یک مدل بهتر پیاده میکردید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عمومی | معنای دقیق فنی |
|---|---|---|
| Generative model (مدل زایشی) | «چیزهای جدید میسازد» | یک نمونهگیر (sampler) برای یاد میگیرد و در صورت امکان را ارائه میدهد. |
| Explicit density (چگالی صریح) | «میتوانید محاسبهاش کنید» | مدل یک رابطهی فرم بسته (closed-form) یا محاسبهپذیر برای فراهم میکند. |
| Implicit density (چگالی ضمنی) | «مدلهای سبک GAN» | صرفاً یک نمونهگیر است — راهی برای ارزیابی یک نقطهی فرضی وجود ندارد. |
| ELBO | «کران پایین شواهد» | کران پایینی با امکان محاسبهی آسان برای ؛ مدلهای VAE و دیفیوژن آن را بهینه میکنند. |
| Score (اسکور) | «گرادیانِ لگاریتم چگالی» | همان رابطه ؛ مدلهای دیفیوژن و SDE این میدان را یاد میگیرند. |
| Manifold hypothesis (فرضیه خمینه) | «دادهها روی یک سطح نشستهاند» | دادههای با ابعاد بالا روی یک خمینهی کمبُعد متمرکز میشوند؛ دلیلی که باعث میشود کاهش ابعاد جواب بدهد. |
| Autoregressive (خودبازگشتی) | «بخش بعدی را پیشبینی کن» | فاکتورگیری توزیع توأم به صورت حاصلضرب توزیعهای شرطی. |
| Latent (نهان) | «کد فشردهشده» | نمایش کمبُعدی از داده که یک دیکودر میتواند ورودی را از روی آن بازسازی کند. |
نکتهی پروداکشن: پنج خانواده، پنج رفتار در استنتاج
هر خانواده منحنی هزینهی متفاوتی روی سرورهای استنتاج دارد. در ادبیات استنتاج محیط پروداکشن، استنتاج مدلهای زبانی به دو بخش پیشتکمیل (prefill) و رمزگشایی (decode) تقسیم میشود؛ همین تفکیک در اینجا هم برقرار است:
- مدلهای خودبازگشتی (دستههای 1 و 5). رمزگشایی ترتیبی بخش اصلی تاخیر (latency) را رقم میزند؛ کش کلید-مقدار (KV-cache)، دستهبندی پیوسته (continuous batching) و رمزگشایی گمانهزن (speculative decoding) همگی مستقیماً در اینجا کاربرد دارند.
- مدلهای VAE / دیفیوژن / تطبیق جریان (دستههای 2 و 4). در اینجا چیزی به نام Decode با تعریف رایج در مدلهای زبانی وجود ندارد. هزینه برابر است با
num_steps × step_cost؛ که در آنstep_costیک گذر رو به جلو در ترنسفورمر یا U-Net با رزولوشن کامل متغیر نهان است. اهرمهای تنظیم عملکرد در محیط پروداکشن عبارتند از تعداد گامها (با کمک روشهایی مثل DDIM ،DPM-Solver یا تقطیر دانش)، اندازهی دسته (batch size) و دقت (precision نظیر bf16 / fp8 / int4). - مدلهای GAN (دستهی 3). یک گذر رو به جلو. نه زمانبندی گامبهگامی در کار است و نه KV-cache. زمان تا اولین توکن (TTFT) تقریباً با کل تاخیر سیستم برابر است. به همین دلیل StyleGAN هنوز هم در تجربهی کاربریِ تسکهای با دامنهی محدود برنده است.
وقتی در چکیدهی مقالهای عبارت «سریعتر از دیفیوژن» را دیدید، آن را به «تعداد گامهای کمتر × همان هزینهی هر گام» یا «تعداد گام یکسان × هزینهی کمتر برای هر گام» ترجمه کنید. غیر از این هرچه باشد صرفاً بازاریابی است.
برای مطالعهی بیشتر
- Goodfellow et al. (2014). Generative Adversarial Nets — مقالهی اصلی GAN.
- Kingma & Welling (2013). Auto-Encoding Variational Bayes — مقالهی اصلی VAE.
- Ho, Jain, Abbeel (2020). Denoising Diffusion Probabilistic Models — مقالهی اصلی DDPM.
- Song et al. (2021). Score-Based Generative Modeling through SDEs — مدلهای دیفیوژن در قالب معادلات دیفرانسیل تصادفی (SDE).
- Lipman et al. (2023). Flow Matching for Generative Modeling — مقالهی تطبیق جریان.
- Esser et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — مقالهی Stable Diffusion 3.