
پرامپتهای متنی بهتنهایی نمیتوانند جزئیات دقیقی مانند حالت قرارگیری سوژه، زوایای دوربین، یا ترکیببندی فضایی صحنه را به مدل تصویرساز منتقل کنند. برای طراحان و توسعهدهندگانی که میخواهند از هوش مصنوعی در پروژههای جدی تجاری استفاده کنند، تولید تصاویر کاملاً تصادفی پاسخگوی نیاز نیست. راهکار عملی، استفاده از تکنیکهای کنترل شرطی نظیر ControlNet و افزونههای کمرتبه مثل LoRA است تا بدون نیاز به بازآموزی مدلهای غولپیکر چند میلیارد پارامتری، خروجیهایی دقیق و پایدار تولید شود.
در استفاده از این ابزارها در ایران، دانلود مدلها و چکپوینتهای سنگین از پلتفرمهایی مانند Hugging Face یا نصب کتابخانهها از مخازن پایتون گاهی با افت سرعت و ناپایداری شبکه همراه است. همچنین اجارهی پردازندههای گرافیکی خارجی به دلیل چالشهای پرداخت ارزی هزینه و پیچیدگی زیادی دارد. با این حال، زیبایی معماریهایی مانند LoRA و ControlNet این است که با افزودن وزنهای بسیار کوچک به مدلهای پایهی کوآنتایزشده، امکان اجرای کارآمد و حتی سرویسدهی سبک را روی منابع پردازشی محدودتر فراهم میکنند.
متن بهتنهایی سیگنال کنترلی ناشیانهای است. با ControlNet میتوانید یک مدل دیفیوژن (Diffusion Model) از پیش آموزشدیده را شبیهسازی (clone) کنید و آن را با نقشهی عمق (depth map)، اسکلت ژست حرکتی (pose skeleton)، طرح اولیه (scribble) یا تصویر لبهها هدایت کنید. LoRA هم به شما امکان میدهد یک مدل 2 میلیارد پارامتری را تنها با آموزش دادن 10 میلیون پارامتر فاینتیون کنید. ترکیب این دو، Stable Diffusion را از یک ابزار سرگرمی به پایپلاین (Pipeline) تولید تصویر سال 2026 تبدیل کرد که حالا در تمام آژانسهای تبلیغاتی و خلاقیت به کار گرفته میشود.
صورت مسئله
پرامپتی (Prompt) مثل «زنی با لباس قرمز در حال قدم زدن با سگش در خیابانی شلوغ»، هیچ اطلاعاتی دربارهی اینکه سگ کجاست، زن در چه حالتی قرار دارد یا زاویهی دید خیابان چگونه است به مدل نمیدهد. متن تنها حدود 10% از جزئیات لازم برای تعیین دقیق یک تصویر را مشخص میکند. باقی جزئیات ماهیت بصری دارند و نمیتوان آنها را با کلمات بهشکلی بهینه توصیف کرد.
آموزش یک مدل شرطیِ جدید از صفر برای هر سیگنال (ژست حرکتی، عمق، لبههای canny، بخشبندی معنایی) هزینهی سرسامآوری دارد. راهکار ایدهآل این است: بکبون (Backbone) 2.6 میلیارد پارامتری SDXL را فریز نگه دارید، یک شبکهی فرعی کوچک برای خواندن شرایط به آن متصل کنید و بگذارید ویژگیهای میانی بکبون را کمی تغییر دهد. این دقیقاً همان کاری است که ControlNet انجام میدهد.
علاوه بر این، احتمالاً میخواهید مفاهیم جدیدی را (مثل چهرهی خودتان، محصولتان یا سبک خاصتان) بدون آموزش مجدد کل مدل به آن یاد دهید. برای این کار به یک دلتای (تغییراتِ) 100 برابر کوچکتر نیاز دارید. اینجاست که LoRA وارد میشود: آداپتورهای کمرتبه که مستقیماً به وزنهای اتنشن (Attention) فعلی متصل میشوند.
ControlNet + LoRA + متن = جعبهابزار کاربردی متخصصان در سال 2026. بیشتر پایپلاینهای عملیاتیِ تولید تصویر، 2 تا 5 مدل LoRA، بین 1 تا 3 مدل ControlNet و یک ماژول IP-Adapter را روی مدل پایهی SDXL، SD3 یا Flux سوار میکنند.
مفاهیم پایه
ControlNet (ژانگ و همکاران، 2023)
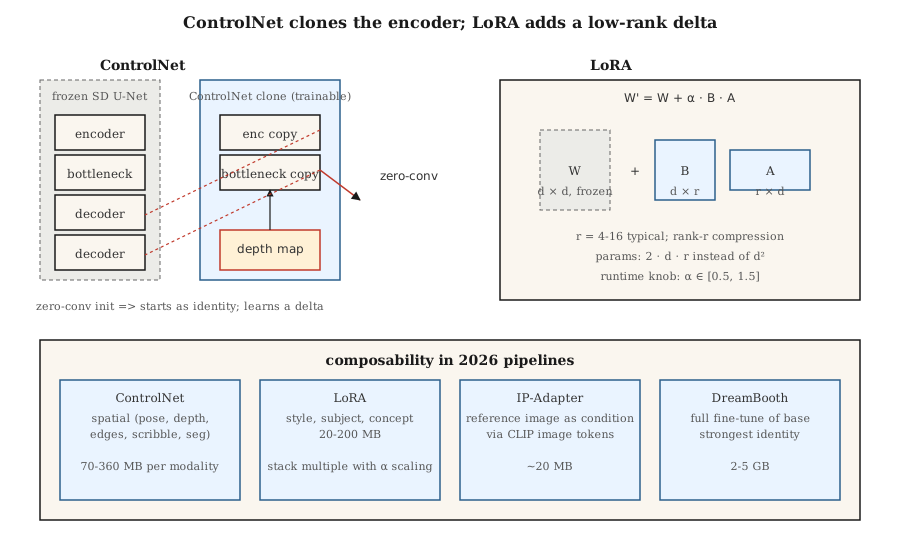
یک مدل SD از پیش آموزشدیده را در نظر بگیرید. نیمهی انکودر ساختار U-Net آن را شبیهسازی (clone) کنید. نسخهی اصلی را فریز کنید. مدل شبیهسازیشده را طوری آموزش دهید که یک ورودی شرطیِ اضافی (لبهها، عمق، ژست حرکتی) دریافت کند. در نهایت، خروجیهای این مدل را از طریق اتصالهای جهشی (Skip connection) با کانولوشن صفر (zero-convolution) به نیمهی دکودر مدل اصلی وصل کنید (کانولوشنهای 1×1 که مقدار اولیهی وزنهایشان صفر است؛ یعنی در ابتدا هیچ اثری ندارند و کمکم یک دلتا را یاد میگیرند).
SD U-Net decoder: ... ← orig_enc_features + zero_conv(controlnet_enc(condition))مقداردهی اولیهی کانولوشن صفر یعنی ControlNet در ابتدای کار مثل یک تابع همانی عمل میکند؛ پس حتی پیش از شروع آموزش هم هیچ اختلالی در خروجی مدل اصلی ایجاد نمیکند. برای آموزش آن، از 1 میلیون سهگانه (Triple) از (پرامپت، شرط بصری، تصویر) به همراه تابع زیان (loss) استاندارد دیفیوژن استفاده میشود.
مدلهای ControlNet برای هر نوع سیگنال، بهصورت مدلهای جانبی کوچک عرضه میشوند (حدود 360 مگابایت برای SDXL و حدود 70 مگابایت برای SD 1.5). در زمان استنتاج میتوانید چند مدل را با هم ترکیب کنید:
features += weight_a * control_a(depth) + weight_b * control_b(pose)LoRA (هو و همکاران، 2021)
برای هر لایهی خطی در مدل، وزنهای را فریز کرده و یک دلتای کمرتبه به آن اضافه کنید:
با شرطِ . رتبهی (Rank) 4 تا 16 برای لایههای اتنشن استاندارد است و رتبهی 64 تا 128 برای فاینتیونهای سنگین استفاده میشود. تعداد پارامترهای جدید به میرسد، در حالی که لایهی اصلی پارامتر داشت. در لایهی اتنشن SDXL با ابعاد و ، بهجای 410 هزار پارامتر، تنها به 20 هزار پارامتر برای هر آداپتور نیاز دارید؛ یعنی کاهشی 20 برابری. در کل ساختار مدل نیز حجم یک LoRA معمولاً بین 20 تا 200 مگابایت است، در حالی که مدل پایه حدود 5 گیگابایت فضا میگیرد.
در زمان استنتاج میتوانید وزن LoRA را تغییر مقیاس دهید: . ضریب حالت عادی است. همچنین میتوانید چندین LoRA را بهصورت جمعی روی هم اعمال کنید (البته با در نظر گرفتن این نکته که این مدلها ممکن است برهمکنشهای غیرخطی با یکدیگر داشته باشند).
IP-Adapter (یه و همکاران، 2023)
آداپتور بسیار کوچکی است که علاوه بر متن، یک تصویر را هم بهعنوان شرط دریافت میکند. این ابزار از انکودر تصویر CLIP برای تولید توکنهای (Token) تصویری استفاده کرده و آنها را در کنار توکنهای متنی وارد کراساتنشن (Cross-Attention) میکند. حجم آن برای هر مدل پایه حدود 20 مگابایت است و به شما اجازه میدهد بدون نیاز به LoRA، دستورهایی مثل «تصویری به سبک این نمونهی مرجع بساز» را اجرا کنید.
جدول مقایسه و ترکیبپذیری ابزارها
| ابزار | چه چیزی را کنترل میکند | حجم | زمان استفاده |
|---|---|---|---|
| ControlNet | ساختار فضایی (ژست، عمق، لبهها) | 70 تا 360 مگابایت | چیدمان دقیق، ترکیببندی |
| LoRA | سبک، سوژه، مفهوم | 20 تا 200 مگابایت | شخصیسازی، سبک هنری |
| IP-Adapter | سبک یا سوژه بر اساس تصویر مرجع | 20 مگابایت | وقتی هیچ متنی نمیتواند ظاهر تصویر را توصیف کند |
| Textual Inversion | تعریف مفهوم جدید در قالب یک توکن تازه | 10 کیلوبایت | قدیمی؛ عمدتاً با LoRA جایگزین شده است |
| DreamBooth | فاینتیون کامل مدل روی یک سوژه | 2 تا 5 گیگابایت | شباهت دقیق چهره یا شیء، مصرف پردازشی بالا |
| T2I-Adapter | جایگزین سبکتر برای ControlNet | 70 مگابایت | دستگاههای لبه (edge)، محدودیت توان پردازشی |
به بیان ساده: ControlNet ساختار فضایی را هدایت میکند و LoRA بار معنایی را به دوش میکشد. از هر دو در کنار هم استفاده کنید.
پیادهسازی از صفر
کد code/main.py این دو سازوکار را در فضایی یکبعدی شبیهسازی میکند:
-
LoRA: یک لایهی خطیِ از پیش آموزشدیده . آن را فریز میکنیم. سپس ماتریس کمرتبهی را طوری آموزش میدهیم که خروجی با یک لایهی خطی هدف منطبق شود. در ادامه نشان میدهیم که رتبهی برای یادگیری بینقص یک تصحیح با رتبهی 1 کاملاً کافی است.
-
ControlNet سبک (ControlNet-lite): یک مدل پیشبینیکنندهی «پایهی فریزشده» به همراه یک «شبکهی فرعی» که سیگنال کمکی را میخواند. خروجی شبکهی فرعی توسط یک اسکالرِ قابل یادگیری که مقدار اولیهاش صفر است کنترل میشود (نسخهی ما از کانولوشن صفر). مدل را آموزش میدهیم و میبینیم که چگونه این ضریب کنترلی بهمرور بالا میرود.
گام 1: محاسبات ریاضی LoRA
def lora(W, A, B, x, alpha=1.0):
    # W is frozen; A, B are the trainable low-rank factors.
    return [W[i][j] * x[j] for i, j in ...] + alpha * (B @ (A @ x))
گام 2: شبکهی فرعی با مقداردهی اولیهی صفر
side_out = control_net(x, condition)
gated = gate * side_out  # gate initialized to 0
h = base(x) + gated
در گام 0، خروجی شبکه دقیقاً با خروجی مدل پایه یکی است. در مراحل ابتدایی آموزش، پارامتر gate بهآرامی بهروزرسانی میشود و هیچ پرش یا افت ناگهانی در کیفیت خروجی رخ نمیدهد.
خطاهای رایج
- بزرگ کردن بیش از حد ضریب LoRA: تنظیم یا ترفند رایجی برای «قویتر کردن افکت» است، اما معمولاً خروجیهایی غیرطبیعی، اغراقشده یا کاملاً خراب تولید میکند. مقیاس را در محدودهی نگه دارید.
- تداخل وزنهای چند ControlNet: اگر همزمان یک ControlNet ژست حرکتی با وزن 1.0 و یک ControlNet عمق با وزن 1.0 اعمال کنید، مدل معمولاً زیادهروی میکند. یک پیشفرض امن این است که مجموع وزنها را حوالی 1.0 نگه دارید.
- استفاده از LoRA روی مدل پایهی اشتباه: فایلهای LoRA ساختهشده برای SDXL، روی SD 1.5 کار نمیکنند و بدون هیچ خروجی خاصی نادیده گرفته میشوند، چون ابعاد اتنشن در این دو مدل فرق دارد. نسخههای 0.30 به بعد کتابخانهی diffusers در این حالت هشدار میدهند.
- افت کیفیت Textual Inversion در جابهجایی مدلها: توکنهایی که روی یک چکپوینت (Checkpoint) آموزش دیدهاند، روی چکپوینت دیگر عملکرد بسیار ضعیفی دارند. LoRA بسیار قابلانتقالتر است.
- ادغام وزنهای LoRA و نگهداری آنها: میتوانید برای بالا بردن سرعت استنتاج، وزنهای LoRA را مستقیماً داخل وزنهای مدل پایه merge کنید تا نیازی به جمع زدن لایهها در زمان اجرا (runtime) نباشد؛ اما با این کار، امکان تغییر مقیاس در زمان اجرا را از دست میدهید. بهتر است هر دو نسخه را نگه دارید.
استفاده از ابزارهای واقعی
| هدف | پایپلاین پیشنهادی در سال 2026 |
|---|---|
| بازتولید سبک بصری یک برند | آموزش LoRA روی حدود 30 تصویر گلچینشده با رتبهی 32 |
| قرار دادن چهره در تصویر تولیدی | DreamBooth یا ترکیب LoRA با IP-Adapter-FaceID |
| ایجاد ژست حرکتی دقیق همراه پرامپت | ترکیب ControlNet-Openpose با SDXL و پرامپت متنی |
| ترکیببندی دقیق با درک عمق صحنه | ترکیب ControlNet-Depth با SD3 |
| استفاده از تصویر مرجع به همراه پرامپت | ترکیب IP-Adapter با پرامپت متنی |
| کنترل دقیق چیدمان عناصر | استفاده از ControlNet-Scribble یا ControlNet-Canny |
| جایگزینی پسزمینه | ترکیب ControlNet-Seg با اینپینتینگ (Inpainting) (درس 09) |
| اعمال سبک در سریعترین زمان (تکمرحلهای) | استفاده از LCM-LoRA روی SDXL-Turbo |
خروجی این درس
فایل outputs/skill-sd-toolkit-composer.md را ذخیره کنید. این مهارت (Skill) ورودیهای مسئله (شامل پرامپت، تصویر مرجع اختیاری، ژست حرکتی اختیاری، نقشهی عمق اختیاری یا طرح اولیه) را تحویل میگیرد و پشتهی ابزارها، وزنهای مناسب هر کدام و پروتکل مقداردهی بذر تصادفی (seed) برای تکرارپذیری نتیجه را ارائه میدهد.
تمرینها
- ساده. در فایل
code/main.py، رتبهیrدر LoRA را بین 1 تا 4 تغییر دهید. در چه رتبهای، LoRA میتواند یک ماتریس هدف با رتبهی 2 را بدون خطا بازسازی کند؟ - متوسط. دو مدل LoRA جداگانه برای دو تبدیلِ هدفِ متفاوت آموزش دهید. هر دو را همزمان لود کرده و رفتار جمعپذیر آنها را ارزیابی کنید. اثر خطی این دو مدل در چه نقطهای مختل میشود؟
- پیشرفته. با استفاده از کتابخانهی diffusers این پشته را بسازید: مدل پایهی SDXL + ابزار Canny-ControlNet (با وزن 0.8) + یک LoRA سبک هنری (با برابر با 0.8) + ماژول IP-Adapter (با وزن 0.6). با تغییر وزنهای این پشته، تعادل میان معیار کیفی FID و میزان وفاداری به پرامپت (prompt-adherence) را بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها چه میگویند | معنای دقیق فنی |
|---|---|---|
| ControlNet | «کنترل فضایی» | انکودر شبیهسازیشده بههمراه اتصالات کانولوشن صفر که یک تصویر شرطی را پردازش میکند. |
| Zero convolution | «از همانی شروع میشود» | کانولوشن 1×1 با مقداردهی اولیهی صفر؛ بنابراین ControlNet در ابتدا خروجی را تغییر نمیدهد. |
| LoRA | «آداپتور کمرتبه» | تغییر وزنها بهصورت ، ؛ با 100 برابر پارامتر کمتر نسبت به فاینتیون کامل. |
| رتبه r (rank r) | «پیچ تنظیم» | فشردهسازی در LoRA؛ معمولاً بین 4 تا 16 و برای شخصیسازیهای سنگین 64 به بالا. |
| «شدت یا قدرت LoRA» | تغییر مقیاس دلتای LoRA در زمان استنتاج. | |
| IP-Adapter | «تصویر مرجع» | آداپتور سبکِ تصویر بهعنوان شرط ورودی با بهرهگیری از توکنهای تصویر CLIP. |
| DreamBooth | «فاینتیون کامل سوژه» | آموزش کل مدل روی حدود 30 تصویر از یک سوژهی مشخص. |
| Textual Inversion | «توکن جدید» | یادگیری صرفاً یک امبدینگ کلمه (Word embedding) جدید؛ قدیمی شده و جای خود را به LoRA داده است. |
نکتهی پروداکشن: تعویض LoRA، لاینهای موازی ControlNet و سرویسدهی چندکاربره
یک محصول نرمافزاری واقعی در حوزهی تولید تصویر، صدها LoRA و چندین مدل ControlNet مختلف را روی یک مدل پایهی یکسان سرو میکند. مدیریت این زیرساخت شباهت زیادی به سرویسدهی چندکاربره در مدلهای زبانی بزرگ دارد (موضوعی که در ادبیات فنی با عناوینی مثل continuous batching و LoRAX / S-LoRA بررسی میشود):
- مدلهای LoRA را در لحظه جابهجا کنید و آنها را merge نکنید. ادغام وزنهای در دل مدل پایه، سرعت هر گام استنتاج را تنها حدود 3 تا 5 درصد بیشتر میکند، اما دست شما را برای تغییر و مدل پایه میبندد. وزنهای LoRA را بهعنوان دلتاهای کمرتبه در حافظهی گرافیکی (VRAM) آماده نگه دارید؛ در diffusers میتوانید با متدهای
pipe.load_lora_weights()وpipe.set_adapters([...], adapter_weights=[...])آنها را بهازای هر درخواست بهسرعت فعال کنید. هزینهی این جابهجایی صرفاً بارگذاری وزنهای فرمول2 · d · r · num_layersاست که در حد چند مگابایت بوده و زیر یک ثانیه زمان میبرد. - اجرای ControlNet در لاین اتنشن دوم. انکودر شبیهسازیشده بهصورت موازی با مدل اصلی اجرا میشود. فعالسازی همزمان دو ControlNet با وزن 1.0، یعنی در هر مرحله باید دو گذر رو به جلو (forward pass) اضافه انجام شود، نه اینکه همهچیز در یک مرحله merge شود. این کار فضای آزاد شما برای بچسایز (batch size) را بهشدت کاهش میدهد. در محاسبات منابع، بهازای هر ControlNet فعال، هزینهی هر مرحله را تقریباً 1.5 برابر در نظر بگیرید.
- کوآنتایز کردن LoRAها. اگر مدل پایه را کوآنتایز کردهاید (مثل اجرای مدل Flux روی 8 گیگابایت در درس 07)، دلتاهای LoRA را هم میتوانید بهراحتی بهصورت 8 بیتی یا 4 بیتی کوآنتایز کنید. با روشهای شبیه به QLoRA، میتوانید 5 تا 10 مدل LoRA مختلف را بدون پر شدن حافظه، روی یک مدل 4 بیتی Flux بارگذاری کنید.
یک نکتهی کاربردی دربارهی Flux: در نوتبوک اجرای Flux روی کارتهای 8 گیگابایتی (ارائهشده توسط نیلز)، مدل پایه به حالت 4 بیتی کوآنتایز میشود؛ با این حال، بارگذاری LoRA سبک هنری روی این پایهی فشردهشده از طریق pipe.load_lora_weights("user/style-lora") و با مشخص کردن weight_name="pytorch_lora_weights.safetensors" بدون مشکل کار میکند. این همان فرمول موفقی است که اغلب شرکتهای ارائهدهندهی سرویسهای ابری در سال 2026 به کار میبرند.
برای مطالعهی بیشتر
- ژانگ، رائو و آگراوالا (2023). افزودن کنترل شرطی به مدلهای دیفیوژن متن به تصویر — معرفی ControlNet.
- هو و همکاران (2021). روش LoRA: انطباق کمرتبه برای مدلهای زبانی بزرگ — مقالهی اصلی LoRA (که ابتدا برای LLMها ارائه شد و سپس به مدلهای دیفیوژن راه یافت).
- یه و همکاران (2023). آداپتور IP-Adapter: آداپتور پرامپت تصویری سازگار با متن — معرفی IP-Adapter.
- مو و همکاران (2023). روش T2I-Adapter: یادگیری آداپتورها برای استخراج توانمندیهای کنترلی بیشتر — جایگزین سبکتر برای ControlNet.
- روئیز و همکاران (2023). روش DreamBooth: فاینتیون مدلهای دیفیوژن متن به تصویر برای تولید محتوای سوژهمحور — معرفی DreamBooth.
- مستندات Diffusers در HuggingFace — راهنمای ControlNet / LoRA / IP-Adapter — پیادهسازیهای مرجع پایپلاینها.