
در پروژههای واقعی علم داده و یادگیری ماشین، ماتریسها معمولاً مربعی نیستند؛ دادههای جدول کاربران و فیلمها، جدول بسامد کلمات و اسناد، یا پیکسلهای تصویر همگی ماتریسهای مستطیلی با نویز و ابعاد بسیار بالا هستند. در چنین سناریوهایی تجزیهی ویژهمقدار (Eigendecomposition) کارساز نیست و شما به ابزاری نیاز دارید که بدون هیچ پیششرطی ساختار پنهان داده را استخراج کند.
تجزیهی مقادیر منفرد (Singular Value Decomposition یا SVD) دقیقاً همین مشکل را حل میکند. این روش به شما امکان میدهد ابعاد ماتریس را با کمترین میزان اتلاف اطلاعات کاهش دهید، نویزها را جدا کنید و دستگاههای معادلاتی غیرمربعی را با دقت حل نمایید.
در این درس علاوه بر کشف شهود هندسی سه مرحلهای SVD (دوران، مقیاسبندی و دوران)، مفاهیم تقریب کمرتبه، قضیهی اکارت-یانگ، سامانههای توصیهگر و فشردهسازی تصویر را بررسی میکنیم و الگوریتم تکرار توانی (Power Iteration) را با پایتون از صفر میسازیم.
تجزیهی مقادیر منفرد (SVD) چاقوی همهکارهی سوئیسی در جبر خطی است. هر ماتریسی یکی دارد؛ هر دانشمند دادهای به آن نیاز دارد.
اهداف یادگیری
- پیادهسازی SVD از طریق تکرار توانی (power iteration) و تشریح معنای هندسی ، و
- بهکارگیری SVD مقطوع (truncated SVD) برای فشردهسازی تصویر و سنجش نسبت فشردهسازی در برابر خطای بازسازی
- محاسبهی شبهوارون مور-پنروز (Moore-Penrose pseudoinverse) با کمک SVD برای حل دستگاههای فرامعین کمترین مربعات
- اتصال مفاهیم SVD به PCA، سامانههای توصیهگر (عوامل پنهان) و تحلیل معنایی پنهان (LSA) در پردازش زبان طبیعی
صورت مسئله
یک ماتریس 1000 در 2000 پیش روی شماست؛ شاید امتیازهای کاربران به فیلمها باشد، یا جدول بسامد کلمات در اسناد، یا شاید مقادیر پیکسلهای یک تصویر. میخواهید آن را فشرده کنید، نویززدایی کنید، ساختار پنهانش را بیرون بکشید یا یک دستگاه کمترین مربعات را با آن حل کنید. تجزیهی ویژهمقدار (eigendecomposition) فقط روی ماتریسهای مربعی کار میکند؛ تازه در آن حالت هم ماتریس باید مجموعهای کامل از بردارهای ویژهی خطیِ مستقل داشته باشد.
اما SVD روی هر ماتریسی کار میکند؛ با هر ابعاد و هر رتبهای، بدون هیچ قید و شرطی. این روش ماتریس را به سه عامل تجزیه میکند که هندسهی عملکرد ماتریس روی فضا را آشکار میسازند. SVD فراگیرترین و مفیدترین تجزیه در تمام جبر خطی است.
مفاهیم اصلی
معنای هندسی SVD
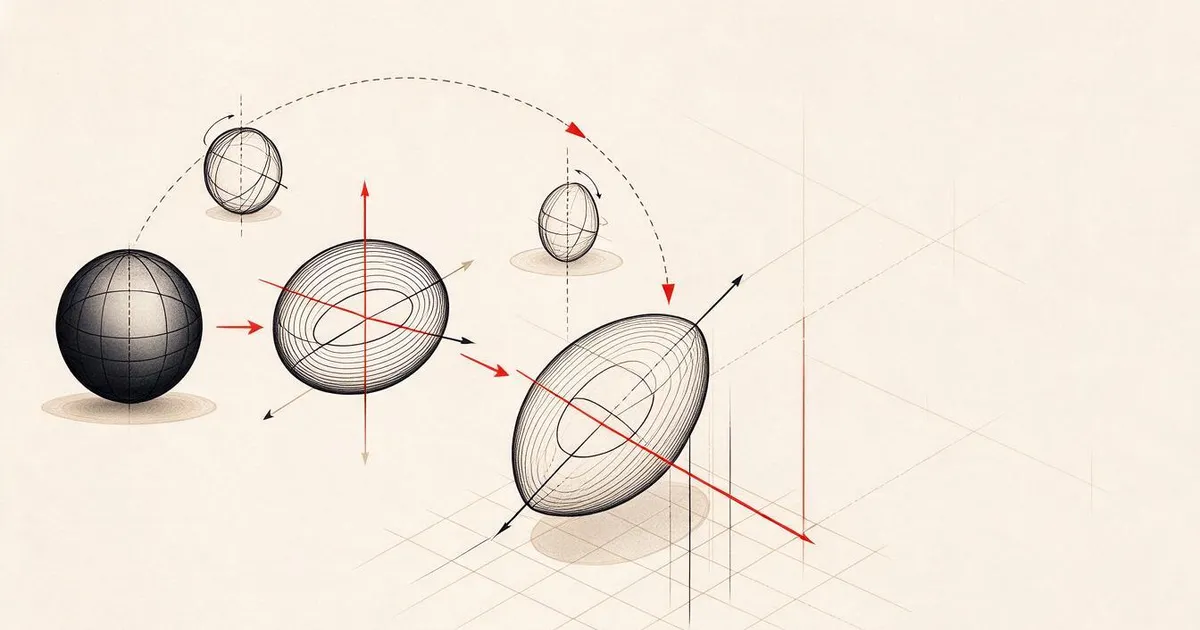
هر ماتریسی، فارغ از ابعادش، سه عملیات را پشت سر هم انجام میدهد: دوران، مقیاسبندی، دوران. تجزیهی SVD این ساختار سهمرحلهای را کاملاً شفاف میکند.
برای هر ماتریس دلخواه ، تجزیهی SVD آن را به این سه بخش تفکیک میکند:
- بردارهای فضای ورودی ( بعدی) را دوران میدهد
- راستای هر محور را مقیاسبندی میکند (میکشد یا فشرده میکند)
- نتیجه را دوران میدهد و به فضای خروجی ( بعدی) میبرد
ماجرا را اینطور ببینید: ماتریسی را به SVD تحویل میدهید و به شما میگوید: «این ماتریس یک کُره از ورودیها را میگیرد، ابتدا آن را با میچرخاند، سپس با آن را میکشد و به یک بیضیگون تبدیل میکند، و در نهایت این بیضیگون را با دوران میدهد.» مقادیر منفرد در واقع همان طول محورهای این بیضیگون هستند.
تجزیهی کامل
برای ماتریسی مانند با ابعاد :
ستونهای بردارهای منفرد چپ (left singular vectors) و ستونهای بردارهای منفرد راست (right singular vectors) نامیده میشوند. درایههای روی قطر نیز مقادیر منفرد (singular values) هستند. این مقادیر همیشه نامنفیاند و طبق قرارداد، بهصورت نزولی مرتب میشوند.
بردارهای منفرد چپ، مقادیر منفرد و بردارهای منفرد راست
هر بخش از تجزیهی SVD معنای هندسی مشخصی دارد:
بردارهای منفرد راست (ستونهای ): یک پایهی متعامد یکه (orthonormal basis) برای فضای ورودی () میسازند. اینها همان راستاهایی در فضای ورودی هستند که ماتریس آنها را روی راستاهای متعامد در فضای خروجی مینگارد؛ در واقع دستگاه مختصات طبیعی دامنهی تبدیل به شمار میروند.
مقادیر منفرد (قطر ): ضرایب مقیاسبندی هستند. مقدار منفرد iام نشان میدهد ماتریس، بردارها را در راستای بردار منفرد راست iام چقدر میکشد. مقدار منفرد صفر یعنی ماتریس آن راستا را کاملاً خرد و مسطح میکند.
بردارهای منفرد چپ (ستونهای ): یک پایهی متعامد یکه برای فضای خروجی () تشکیل میدهند. بردار منفرد چپ iام همان راستایی در فضای خروجی است که بردار منفرد راست iام (پس از مقیاسبندی) روی آن فرود میآید.
ارتباط میان آنها به شکل زیر است:
A * v_i = sigma_i * u_i

The matrix A takes the i-th right singular vector v_i,
scales it by sigma_i, and maps it to the i-th left singular vector u_i.
این رابطه تصویری مختصاتبهمختصات از عملکرد واقعی هر ماتریس ارائه میدهد.
نمایش برحسب ضرب خارجی
تجزیهی SVD را میتوان بهصورت مجموع چند ماتریس با رتبهی 1 نوشت:
A = sigma_1 * u_1 * v_1^T + sigma_2 * u_2 * v_2^T + ... + sigma_r * u_r * v_r^T

Each term sigma_i * u_i * v_i^T is a rank-1 matrix (an outer product).
The full matrix is the sum of r such matrices, where r is the rank.
این فرم، پایهی تقریب کمرتبه (low-rank approximation) است. هر جمله، یک لایهی ساختاری اضافه میکند؛ جملهی نخست مهمترین الگوی دادهها را ثبت میکند، جملهی دوم الگوی مهم بعدی را، و همینطور تا آخر. اگر این مجموع را از نقطهای به بعد قطع کنید، بهترین تقریب ممکن را در هر رتبهی معین به دست میآورید.
ارتباط با تجزیهی ویژهمقدار
تجزیهی SVD و تجزیهی ویژهمقدار پیوندی عمیق دارند. مقادیر و بردارهای منفرد ماتریس مستقیماً از ویژهمقادیر و بردارهای ویژهی و حاصل میشوند.
A^T A = V * Sigma^T * U^T * U * Sigma * V^T
      = V * Sigma^T * Sigma * V^T
      = V * D * V^T

where D = Sigma^T * Sigma is a diagonal matrix with sigma_i^2 on the diagonal.

So:
- The right singular vectors (V) are eigenvectors of A^T A
- The singular values squared (sigma_i^2) are eigenvalues of A^T A

Similarly:
A A^T = U * Sigma * V^T * V * Sigma^T * U^T
      = U * Sigma * Sigma^T * U^T

So:
- The left singular vectors (U) are eigenvectors of A A^T
- The eigenvalues of A A^T are also sigma_i^2
این پیوند سه نکتهی مهم را روشن میکند:
- مقادیر منفرد همیشه حقیقی و نامنفی هستند (چون ریشهی دوم ویژهمقادیر یک ماتریس نیمهمعین مثبت به حساب میآیند).
- هرچند میتوان SVD را از طریق تجزیهی ویژهمقدار حساب کرد، این کار عدد حالت (condition number) را به توان دو میرساند و دقت عددی را از بین میبرد؛ به همین دلیل الگوریتمهای اختصاصی SVD از این روش دوری میکنند.
- اگر ماتریس مربعی، متقارن و نیمهمعین مثبت باشد، تجزیهی SVD و تجزیهی ویژهمقدار دقیقاً یکسان خواهند بود.
تقریب کمرتبه با SVD مقطوع
قضیهی اِکارت-یانگ-میرسکی (Eckart-Young-Mirsky) بیان میکند که بهترین تقریب از ماتریس (چه در نُرم فروبنیوس و چه در نُرم طیفی)، با نگهداشتنِ تنها مقدار منفرد بزرگتر و بردارهای متناظر آنها به دست میآید:
این صرفاً یک تقریب «خوب» نیست؛ بلکه اثباتپذیر است که بهترین تقریب ممکن با رتبهی به شمار میرود. هیچ ماتریس دیگری نزدیکتر از این به نیست.
| مؤلفه | اندازهی نسبی | در تقریب رتبه-3 میماند؟ |
|---|---|---|
| بیشترین | بله | |
| بزرگ | بله | |
| متوسط رو به بالا | بله | |
| متوسط | خیر (خطا) | |
| متوسط رو به پایین | خیر (خطا) | |
| کوچک | خیر (خطا) | |
| بسیار کوچک | خیر (خطا) | |
| ناچیز | خیر (خطا) |
با نگهداشتن 3 مقدار اول: سه مقدار منفرد بزرگ را نگه میدارد و خطا برابر با مقادیر باقیمانده ( تا ) خواهد بود.
اگر مقادیر منفرد با سرعت بالایی افت کنند، با یک کوچک میتوان بخش عمدهی ساختار ماتریس را حفظ کرد؛ اما اگر افت این مقادیر کند باشد، ماتریس ساختار کمرتبه ندارد.
فشردهسازی تصویر با SVD
یک تصویر خاکستری (grayscale) در اصل ماتریسی از شدت روشنایی پیکسلهاست. تصویری با ابعاد 800 در 600 شامل 480000 مقدار عددی است؛ اما SVD اجازه میدهد آن را با اعدادی بسیار کمتر تقریب بزنید.
Original image: 800 x 600 = 480,000 values

SVD with rank k:
  U_k:      800 x k values
  Sigma_k:  k values
  V_k:      600 x k values
  Total:    k * (800 + 600 + 1) = k * 1401 values

  k=10:   14,010 values   (2.9% of original)
  k=50:   70,050 values  (14.6% of original)
  k=100: 140,100 values  (29.2% of original)

  The compression ratio improves as k gets smaller,
but visual quality degrades.نکتهی کلیدی اینجاست: مقادیر منفرد در تصاویر طبیعی بهسرعت کاهش مییابند. چند مقدار منفرد اول، ساختارهای کلی تصویر (فرمها، گرادیانها) را حفظ میکنند و مقادیر بعدی جزئیات ریز و نویز را در بر میگیرند. تقریب زدن در رتبهی 50 معمولاً تصویری میسازد که با چشم غیرمسلح تقریباً فرقی با نسخهی اصلی ندارد، در حالی که حجم ذخیرهسازی تا 85٪ کم شده است.
SVD در سامانههای توصیهگر
مسابقهی نتفلیکس (Netflix Prize) این کاربرد را بر سر زبانها انداخت: ماتریسی از امتیاز کاربران به فیلمها در دست دارید که بیشتر خانههایش خالی است.
             Movie1  Movie2  Movie3  Movie4  Movie5
  User1      [  5      ?       3       ?       1  ]
  User2      [  ?      4       ?       2       ?  ]
  User3      [  3      ?       5       ?       ?  ]
  User4      [  ?      ?       ?       4       3  ]

  ? = unknown rating
ایده این است: این ماتریس امتیازها رتبهی پایینی دارد. سلیقهی کاربران کاملاً مستقل از یکدیگر نیست؛ مشتی عامل پنهان (latent factors) مانند اکشن در برابر درام، فیلمهای کلاسیک در برابر جدید، یا فکری در برابر هیجانی وجود دارند که بخش اعظم ترجیحات را توضیح میدهند.
اعمال SVD روی ماتریس امتیازها (که جاهای خالیاش پر شده) آن را تجزیه میکند به:
- : نمایهی کاربران در فضای عوامل پنهان
- : اهمیت هر عامل پنهان
- : نمایهی فیلمها در فضای عوامل پنهان
امتیاز پیشبینیشدهی یک کاربر برای یک فیلم، حاصلضرب داخلی نمایهی کاربر در نمایهی آن فیلم است (با وزندهی مقادیر منفرد). تقریب کمرتبه این خانههای خالی را پر میکند.
در عمل، از نسخههای متفاوتی مانند SVD تدریجی سایمون فانک (Simon Funk) یا کمترین مربعات متناوب (ALS) استفاده میشود که مستقیماً دادههای ناموجود را مدیریت میکنند؛ اما ایدهی محوری یکسان است: تجزیه به عوامل پنهان با کمک SVD.
SVD در پردازش زبان طبیعی: تحلیل معنایی پنهان
تحلیل معنایی پنهان (Latent Semantic Analysis یا LSA) که نمایهسازی معنایی پنهان (LSI) هم نامیده میشود، SVD را روی ماتریس کلمه-سند (term-document matrix) پیاده میکند.
             Doc1   Doc2   Doc3   Doc4
  "cat"      [  3      0      1      0  ]
  "dog"      [  2      0      0      1  ]
  "fish"     [  0      4      1      0  ]
  "pet"      [  1      1      1      1  ]
  "ocean"    [  0      3      0      0  ]

After SVD with rank k=2:

  Each document becomes a point in 2D "concept space."
  Each term becomes a point in the same 2D space.
  Documents about similar topics cluster together.
  Terms with similar meanings cluster together.

  "cat" and "dog" end up near each other (land pets).
  "fish" and "ocean" end up near each other (water concepts).
  Doc1 and Doc3 cluster if they share similar topics.
روش LSA جزو نخستین شیوههای موفقی بود که شباهت معنایی را مستقیماً از متن خام بیرون میکشید. این ایده جواب میدهد، چون واژههای هممعنی معمولاً در اسناد مشابهی ظاهر میشوند؛ بنابراین SVD آنها را در ابعاد پنهان یکسانی گروهبندی میکند. امبدینگهای امروزی کلمات (مانند Word2Vec و GloVe) را میتوان نوادگان همین ایده دانست.
نویززدایی با SVD
در دادههای نویزدار، سیگنال اصلی در مقادیر منفرد بالایی متمرکز است، در حالی که نویز در تمام مقادیر منفرد پخش میشود. مقطوعسازی، کفِ نویز را حذف میکند.
مقادیر منفرد در سیگنال پاک:
| مؤلفه | اندازه | نوع |
|---|---|---|
| بسیار بزرگ | سیگنال | |
| بزرگ | سیگنال | |
| متوسط | سیگنال | |
| نزدیک به صفر | ناچیز | |
| نزدیک به صفر | ناچیز |
مقادیر منفرد در سیگنال نویزدار (نویز به همهی مؤلفهها اضافه میشود):
| مؤلفه | اندازه | نوع |
|---|---|---|
| بسیار بزرگ | سیگنال | |
| بزرگ | سیگنال | |
| متوسط | سیگنال | |
| کوچک | نویز | |
| کوچک | نویز | |
| کوچک | نویز | |
| کوچک | نویز |
این رویکرد در پردازش سیگنال، اندازهگیریهای علمی و پاکسازی دادهها کاربرد دارد. هر بار ماتریسی آلوده به نویز جمعشونده (additive noise) داشتید، SVD مقطوع روشی اصولی برای تفکیک سیگنال از نویز در اختیارتان میگذارد.
محاسبهی شبهوارون با SVD
شبهوارون مور-پنروز مفهوم وارون ماتریس را به ماتریسهای غیرمربعی و منفرد (تکین) تعمیم میدهد؛ SVD محاسبهی آن را بسیار ساده میکند.
If A = U * Sigma * V^T, then:

A+ = V * Sigma+ * U^T

where Sigma+ is formed by:
  1. Transpose Sigma (swap rows and columns)
  2. Replace each non-zero diagonal entry sigma_i with 1/sigma_i
  3. Leave zeros as zeros

For A (m x n):      A+ is (n x m)
For Sigma (m x n): Sigma+ is (n x m)شبهوارون برای حل مسائل کمترین مربعات به کار میرود. اگر معادلهی پاسخ دقیقی نداشته باشد (دستگاه فرامعین)، بردار جواب کمترین مربعات آن خواهد بود (یعنی را کمینه میکند).
Overdetermined system (more equations than unknowns):

  [1  1]         [3]
  [2  1] x   =   [5]       No exact solution exists.
  [3  1]         [6]

  x_ls = A+ b = V * Sigma+ * U^T * b

  This gives the x that minimizes the sum of squared residuals.
  Same result as the normal equations (A^T A)^(-1) A^T b,
  but numerically more stable.
مزایای پایداری عددی
محاسبهی تجزیهی ویژهمقدار روی ماتریس مقادیر منفرد را به توان دو میرساند (ویژهمقادیر همان هستند). این کار عدد حالت را مربع میکند و خطاهای عددی را بهشدت بالا میبرد.
Example:
  A has singular values [1000, 1, 0.001]
  Condition number of A: 1000 / 0.001 = 10^6

  A^T A has eigenvalues [10^6, 1, 10^{-6}]
  Condition number of A^T A: 10^6 / 10^{-6} = 10^{12}

  Computing SVD directly: works with condition number 10^6
  Computing via A^T A:     works with condition number 10^{12}
(6 extra digits of precision lost)الگوریتمهای مدرن SVD (مانند دوقطریسازی گولوب-کاهان) مستقیماً روی خود کار میکنند و هرگز ماتریس را تشکیل نمیدهند؛ به همین دلیل همیشه باید np.linalg.svd(A) را به np.linalg.eig(A.T @ A) ترجیح دهید.
پیوند با PCA
تحلیل مؤلفههای اصلی (PCA) در اصل همان اجرای SVD روی دادههای مرکزیتیافته است. این صرفاً یک تمثیل یا شباهت نیست؛ بلکه دقیقاً یک محاسبهی واحد است.
Given data matrix X (n_samples x n_features), centered (mean subtracted):

Covariance matrix: C = (1/(n-1)) * X^T X

PCA finds eigenvectors of C. But:

  X = U * Sigma * V^T    (SVD of X)

  X^T X = V * Sigma^2 * V^T

  C = (1/(n-1)) * V * Sigma^2 * V^T

So the principal components are exactly the right singular vectors V.
The explained variance for each component is sigma_i^2 / (n-1).

In sklearn, PCA is implemented using SVD, not eigendecomposition.
It is faster and more numerically stable.
این یعنی تمام مباحثی که در درس 10 دربارهی کاهش ابعاد خواندید، زیر هود از SVD قدرت میگیرند. در واقع PCA رایجترین کاربرد SVD در یادگیری ماشین است.
پیادهسازی از صفر
گام 1: پیادهسازی SVD با روش تکرار توانی
ایده: برای یافتن بزرگترین مقدار منفرد و بردارهای متناظرش، روش تکرار توانی را روی (یا ) اجرا میکنیم. سپس اثر این مؤلفه را از ماتریس حذف (deflate) کرده و کار را برای مقدار بعدی تکرار میکنیم.
import numpy as np

def power_iteration(M, num_iters=100):
    n = M.shape[1]
    v = np.random.randn(n)
    v = v / np.linalg.norm(v)

    for _ in range(num_iters):
        Mv = M @ v
        v = Mv / np.linalg.norm(Mv)

    eigenvalue = v @ M @ v
    return eigenvalue, v

def svd_from_scratch(A, k=None):
    m, n = A.shape
    if k is None:
        k = min(m, n)

    sigmas = []
    us = []
    vs = []

    A_residual = A.copy().astype(float)

    for _ in range(k):
        AtA = A_residual.T @ A_residual
        eigenvalue, v = power_iteration(AtA, num_iters=200)

        if eigenvalue < 1e-10:
            break

        sigma = np.sqrt(eigenvalue)
        u = A_residual @ v / sigma

        sigmas.append(sigma)
        us.append(u)
        vs.append(v)

        A_residual = A_residual - sigma * np.outer(u, v)

    U = np.column_stack(us) if us else np.empty((m, 0))
    S = np.array(sigmas)
    V = np.column_stack(vs) if vs else np.empty((n, 0))

    return U, S, V
گام 2: آزمون و مقایسه با NumPy
np.random.seed(42)
A = np.random.randn(5, 4)

U_ours, S_ours, V_ours = svd_from_scratch(A)
U_np, S_np, Vt_np = np.linalg.svd(A, full_matrices=False)

print("Our singular values:", np.round(S_ours, 4))
print("NumPy singular values:", np.round(S_np, 4))

A_reconstructed = U_ours @ np.diag(S_ours) @ V_ours.T
print(f"Reconstruction error: {np.linalg.norm(A - A_reconstructed):.8f}")
گام 3: دموی فشردهسازی تصویر
def compress_image_svd(image_matrix, k):
    U, S, Vt = np.linalg.svd(image_matrix, full_matrices=False)
    compressed = U[:, :k] @ np.diag(S[:k]) @ Vt[:k, :]
    return compressed

image = np.random.seed(42)
rows, cols = 200, 300
image = np.random.randn(rows, cols)

for k in [1, 5, 10, 20, 50]:
    compressed = compress_image_svd(image, k)
    error = np.linalg.norm(image - compressed) / np.linalg.norm(image)
    original_size = rows * cols
    compressed_size = k * (rows + cols + 1)
    ratio = compressed_size / original_size
    print(f"k={k:>3d}  error={error:.4f}  storage={ratio:.1%}")
گام 4: نویززدایی
np.random.seed(42)
clean = np.outer(np.sin(np.linspace(0, 4*np.pi, 100)),
                 np.cos(np.linspace(0, 2*np.pi, 80)))
noise = 0.3 * np.random.randn(100, 80)
noisy = clean + noise

U, S, Vt = np.linalg.svd(noisy, full_matrices=False)
denoised = U[:, :5] @ np.diag(S[:5]) @ Vt[:5, :]

print(f"Noisy error:    {np.linalg.norm(noisy - clean):.4f}")
print(f"Denoised error: {np.linalg.norm(denoised - clean):.4f}")
print(f"Improvement:    {(1 - np.linalg.norm(denoised - clean) / np.linalg.norm(noisy - clean)):.1%}")
گام 5: شبهوارون
A = np.array([[1, 1], [2, 1], [3, 1]], dtype=float)
b = np.array([3, 5, 6], dtype=float)

U, S, Vt = np.linalg.svd(A, full_matrices=False)
S_inv = np.diag(1.0 / S)
A_pinv = Vt.T @ S_inv @ U.T

x_svd = A_pinv @ b
x_lstsq = np.linalg.lstsq(A, b, rcond=None)[0]
x_pinv = np.linalg.pinv(A) @ b

print(f"SVD pseudoinverse solution:  {x_svd}")
print(f"np.linalg.lstsq solution:   {x_lstsq}")
print(f"np.linalg.pinv solution:    {x_pinv}")
استفاده از ابزارهای واقعی
دموهای کامل و کاربردی در فایل code/svd.py آماده شدهاند. با اجرای آن، کاربرد عملی SVD را در فشردهسازی تصویر، سامانههای توصیهگر، تحلیل معنایی پنهان و نویززدایی مشاهده خواهید کرد.
python svd.pyنسخهی Julia در مسیر code/svd.jl نیز همین مفاهیم را با تابع درونساخت svd() و بستهی LinearAlgebra نشان میدهد.
julia svd.jlخروجی این درس
خروجی این درس شامل فایل زیر است:
outputs/skill-svd.md- مهارتی برای درک زمان و نحوهی بهکارگیری SVD در پروژههای واقعی
تمرینها
-
تجزیهی کامل SVD را از صفر و بدون استفاده از روش تکرار توانی پیاده کنید. به جای آن، تجزیهی ویژهمقدار را برای به دست آوردن و مقادیر منفرد حساب کنید، سپس را به دست آورید. دقت عددی این روش را با نسخهی تکرار توانی خودتان و با NumPy بسنجید.
-
یک تصویر خاکستری واقعی را بخوانید (یا تصویری را به خاکستری تبدیل کنید). آن را در رتبههای 1، 5، 10، 25، 50 و 100 فشرده کنید. برای هر رتبه، نسبت فشردهسازی و خطای نسبی را محاسبه کنید. ببینید از کدام رتبه به بعد، تصویر از نظر بصری کیفیت قابل قبولی پیدا میکند.
-
یک سامانهی توصیهگر کوچک بسازید. یک ماتریس 10 در 8 از امتیاز کاربران به فیلمها درست کنید که بعضی خانههایش مشخص باشند. خانههای خالی را با میانگین همان سطر پر کنید. تجزیهی SVD را اعمال کرده و یک تقریب رتبه-3 از آن بازسازی کنید. از این ماتریس بازسازیشده برای پیشبینی امتیازهای ناموجود بهره بگیرید و معقول بودن مقادیر را بررسی کنید.
-
یک ماتریس کلمه-سند در ابعاد 100 در 50 با 3 موضوع ساختگی بسازید؛ طوری که برای هر موضوع 5 اصطلاح مرتبط در نظر گرفته شود. به ماتریس نویز بیفزایید. پس از اجرای SVD، دقت کنید که آیا 3 مقدار منفرد اول بسیار بزرگتر از بقیه هستند؟ اسناد را به فضای پنهان 3بعدی تصویر کنید و مطمئن شوید اسناد همموضوع کنار هم خوشهبندی میشوند.
-
ماتریسی کمرتبه و تمیز بسازید (رتبهی 3 با ابعاد 50 در 40) و سپس نویز گاوسی با سطوح گوناگون ( مساوی با 0.1، 0.5، 1.0 و 2.0) به آن اضافه کنید. در هر سطح نویز، با جاروب کردنِ از 1 تا 40 و سنجش خطای بازسازی نسبت به ماتریس بدون نویز، بهترین رتبهی برش را بیابید. نمودار تغییرات بهینه با افزایش نویز را رسم کنید.
راهنماییها
تمرین 1. ماتریس را محاسبه کنید، با np.linalg.eigh ویژهمقادیر و بردارهای ویژهی آن را به دست آورید و آنها را بهصورت نزولی مرتب کنید. مقادیر منفرد ریشهی دوم این ویژهمقادیر هستند؛ بررسی کنید که آیا ماتریس را بازسازی میکند یا خیر، و خطای آن را با svd_from_scratch و np.linalg.svd مقایسه کنید.
تمرین 2. برای هر رتبه تابع truncated_svd را فراخوانی کنید، با reconstruct تصویر را دوباره بسازید و با compression_ratio(m, n, k) حجم را بسنجید. خطای نسبی باید با افزایش رتبه افت کند؛ نخستین رتبهای که در آن اثری از بلوکهای واضح تصویر دیده نشود، پاسخ نهایی است.
تمرین 3. خانههای خالی را علامت بگذارید، آنها را با میانگین سطر پر کنید و سپس با truncated_svd و reconstruct تقریب رتبه-3 را بازسازی کنید. در ادامه نتیجه را بسنجید: تعداد پیشبینیهای خارج از محدودهی مجاز امتیازها را بشمارید و بیشترین تغییر در خانههای شناختهشده را چاپ کنید. از آنجا که تقریب رتبه-3 هیچ تضمینی برای برقراری این دو ویژگی ارائه نمیدهد، اگر به امتیازهای معتبر نیاز دارید خروجیها را با محدودسازی (clip) در بازه نگه دارید.
تمرین 4. برای هر موضوع، بلوکی متشکل از 5 واژه با بسامد بالا برای اسناد متناظر در نظر بگیرید و سپس نویز اندکی اضافه کنید. مقادیر منفرد را چاپ کنید: باید 3 مقدار اول اختلاف چشمگیری با مقدار چهارم داشته باشند. سپس با رنگآمیزی مختصات 3بعدی بر اساس موضوع، بررسی کنید که هر موضوع یک گروه مجزا تشکیل دهد.
تمرین 5. ماتریس تمیز را از ضرب دو ماتریس تصادفی 50 در 3 و 3 در 40 بسازید و به ازای هر نویز را اضافه کنید. به ازای هر ، خروجی بازسازی رتبهی را با ماتریس اولیه مقایسه کنید؛ برای نویز کم انتظار داریم بهترین حوالی عدد 3 باشد و برای نویز بالا این مقدار کمتر شود.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | تعریف دقیق |
|---|---|---|
| SVD | «تجزیهی هر نوع ماتریس» | تجزیهی ماتریس به که در آن و متعامد بوده و ماتریسی قطری با درایههای نامنفی است. روی هر ماتریسی با هر ابعادی اعمال میشود. |
| مقدار منفرد (Singular value) | «میزان اهمیت این مؤلفه» | درایهی قطری ام در ماتریس . نشاندهندهی میزان کشیدگی ماتریس در راستای جهت اصلی iام است. همیشه نامنفی بوده و بهصورت نزولی مرتب میشود. |
| بردار منفرد چپ (Left singular vector) | «راستای خروجی» | ستونی از ماتریس . جهتی در فضای خروجی که بردار منفرد راستِ ام (پس از مقیاسبندی با ) روی آن مینشیند. |
| بردار منفرد راست (Right singular vector) | «راستای ورودی» | ستونی از ماتریس . جهتی در فضای ورودی که ماتریس آن را به بردار منفرد چپِ ام (پس از مقیاسبندی با ) مینگارد. |
| SVD مقطوع (Truncated SVD) | «تقریب کمرتبه» | نگهداشتنِ تنها مقدار منفرد ابتدایی و بردارهای متناظرشان. این تکنیک، اثباتشدهترین و بهترین تقریب ممکن از رتبهی را برای ماتریس اولیه میسازد (طبق قضیهی اکارت-یانگ). |
| رتبه (Rank) | «ابعاد واقعی داده» | تعداد مقادیر منفرد غیرصفر؛ نشان میدهد ماتریس در عمل از چند جهت مستقل استفاده میکند. |
| شبهوارون (Pseudoinverse) | «وارون تعمیمیافته» | ماتریس . مقادیر منفرد غیرصفر را وارون میکند و صفرها را دستنخورده باقی میگذارد؛ دستگاههای کمترین مربعات را برای ماتریسهای غیرمربعی یا تکین حل میکند. |
| عدد حالت (Condition number) | «میزان حساسیت به خطا» | نسبت . عدد حالت بزرگ یعنی تغییرات کوچک در ورودی، تغییرات بزرگی در خروجی رقم میزنند. SVD این کمیت را مستقیماً نشان میدهد. |
| عامل پنهان (Latent factor) | «متغیر مخفی» | بُعدی در فضای کمرتبه که توسط SVD کشف میشود. در سامانههای توصیهگر ممکن است نشاندهندهی سلیقه در ژانر باشد و در NLP نمایانگر یک موضوع. |
| نُرم فروبنیوس (Frobenius norm) | «اندازهی کل ماتریس» | ریشهی دوم مجموع مربعات تمام درایهها، که با ریشهی دوم مجموع مربعات مقادیر منفرد نیز برابر است. برای سنجش خطای تقریب استفاده میشود. |
| قضیهی اکارت-یانگ (Eckart-Young theorem) | «SVD بهترین فشردهسازی را میدهد» | برای هر رتبهی هدف مانند ، روش SVD مقطوع خطای تقریب را نسبت به تمام ماتریسهای ممکن با رتبهی به کمترین مقدار میرساند. |
| تکرار توانی (Power iteration) | «یافتن بزرگترین بردار ویژه» | ضرب مکرر یک بردار تصادفی در ماتریس و سپس نرمالسازی آن؛ تا جایی که به بردار متناظر با بزرگترین ویژهمقدار همگرا شود. سنگ بنای بسیاری از الگوریتمهای SVD است. |
برای مطالعهی بیشتر
- کتاب جبر خطی و کاربردهای آن اثر گیلبرت استرنگ، فصل 7 - بررسی کامل و کاربردی مفاهیم SVD
- ویدئوی کانال 3Blue1Brown: اما SVD واقعاً چیست؟ - شهود هندسی برای درک تجزیهی مقادیر منفرد
- مقالهی انجمن ریاضی آمریکا: تجزیهی مقادیر منفرد را توصیه میکنیم - مروری خوشخوان و عمومی از سوی انجمن ریاضی آمریکا
- مسابقهی نتفلیکس و فاکتورگیری ماتریسی - پست وبلاگی اصلی سایمون فانک دربارهی بهکارگیری SVD در سامانههای توصیهگر
- تحلیل معنایی پنهان - کاربرد اولیه و کلاسیک SVD در حوزهی پردازش زبان طبیعی
- جبر خطی عددی تألیف تریفثن و باو - مرجع طلایی و استاندارد برای آشنایی با الگوریتمهای عددی SVD و ویژگیهای محاسباتی آنها