
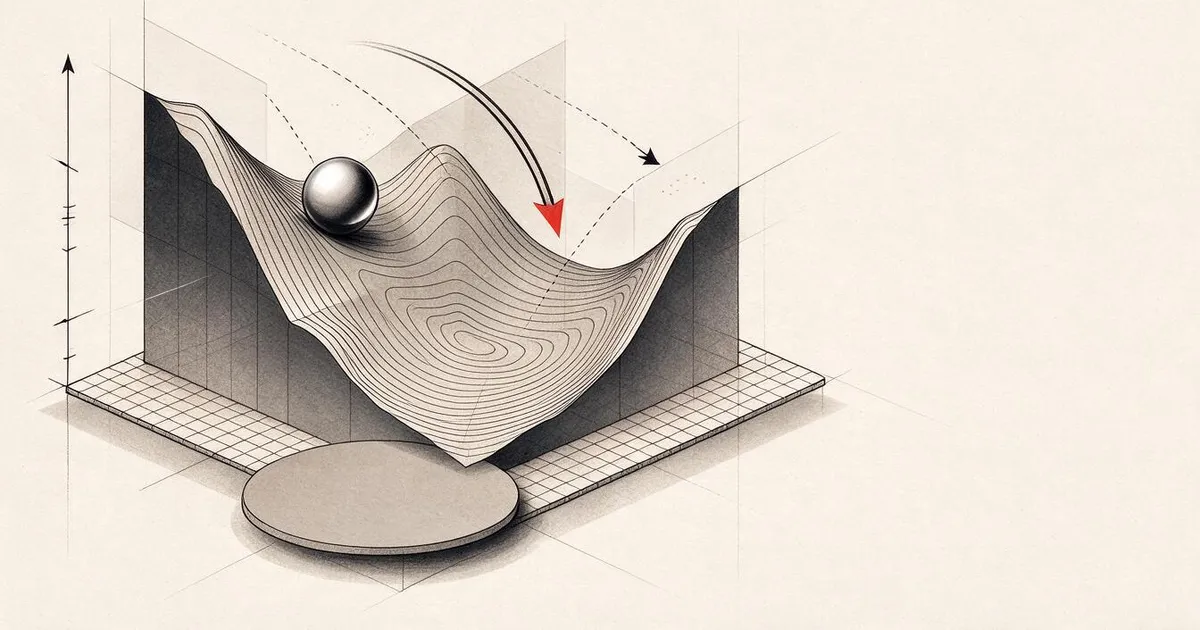
آموزش یک شبکهی عصبی در نهایت به یک مسئلهی مشخص برمیگردد: پیدا کردن کمترین مقدار تابع زیان با تغییر دادن وزنها. اگر رفتار بهینهسازها را عمیق نشناسید، بخش زیادی از زمان آموزش صرف تنظیمات تصادفی و آزمونوخطاهای بینتیجه میشود؛ مدل ممکن است واگرا شود، در نقاط زینی گیر بیفتد یا ساعتها بدون پیشرفت در یک درهی باریک نوسان کند.
در این درس پایهایترین راهبردهای حرکت در چشمانداز زیان را بررسی میکنیم. ابتدا گرادیان کاهشی ساده، سپس SGD با تکانه (Momentum) و در نهایت بهینهساز محبوب Adam را از صفر با پایتون پیادهسازی میکنیم تا سازوکار تنظیم نرخ یادگیری تطبیقی را بهصورت ملموس ببینید.
کدهای این بخش کاملاً بر پایهی محاسبات ریاضی استاندارد روی آرایهها نوشته شدهاند و پیادهسازی آنها به هیچ سختافزار خاص یا پردازندهی گرافیکی وابسته نیست؛ بنابراین میتوانید تمام آزمایشها و مقایسهها را بهسادگی روی پردازندهی سیستم شخصیتان اجرا کنید.
آموزش یک شبکه عصبی در واقع چیزی جز پیدا کردن کف یک دره نیست.
اهداف یادگیری
- پیادهسازی گرادیان کاهشی ساده (vanilla gradient descent)، گرادیان کاهشی تصادفی با تکانه (SGD with momentum) و آدام (Adam) از صفر
- مقایسهی همگرایی بهینهسازها روی تابع روزنبروک (Rosenbrock) و درک اینکه چرا Adam نرخ یادگیری را برای هر وزن جداگانه تنظیم میکند
- تشخیص چشماندازهای زیان کوژ (convex) از غیرکوژ (non-convex) و توضیح نقش نقاط زینی (saddle points) در ابعاد بالا
- پیکربندی برنامههای زمانبندی نرخ یادگیری (کاهش پلهای، بازپخت کسینوسی و گرمکردن اولیه) برای پایداری فرایند آموزش
صورت مسئله
شما یک تابع زیان (loss function) دارید که نشان میدهد مدل چقدر اشتباه میکند. گرادیانها را هم در اختیار دارید که مشخص میکنند حرکت در کدام جهت زیان را بدتر میکند. حالا به راهبردی برای حرکت به سمت پایین دره نیاز دارید.
سادهترین روش این است: خلاف جهت گرادیان حرکت کنید، طول گام را با عددی به نام نرخ یادگیری (learning rate) مقیاس کنید و همین روند را تکرار کنید. این همان گرادیان کاهشی است که کار هم میکند؛ اما این «کار کردن» اما و اگرهایی دارد. اگر نرخ یادگیری بیش از حد بزرگ باشد، کلاً از دره رد میشوید و بین دیوارهها مدام اینطرف و آنطرف پرت میشوید. اگر خیلی کوچک باشد، برای رسیدن به جواب باید هزاران گام غیرضروری و فرسایشی بردارید. اگر هم به یک نقطهی زینی برسید، حرکتتان متوقف میشود؛ بدون آنکه واقعاً به کمینهای (minimum) رسیده باشید.
همهی بهینهسازها در یادگیری عمیق در واقع پاسخی به همین یک پرسشاند: چطور سریعتر و با اطمینان بیشتر به کف دره برسیم؟
مفاهیم پایه
بهینهسازی یعنی چه؟
بهینهسازی یعنی پیدا کردن مقادیری از ورودی که یک تابع را کمینه (یا بیشینه) میکنند. در یادگیری ماشین، آن تابع همان زیان است و ورودیها همان وزنهای مدل هستند. آموزش، همان بهینهسازی است.
minimize L(w) where:
  L = loss function
  w = model weights (could be millions of parameters)
گرادیان کاهشی ساده
این سادهترین بهینهساز ممکن است. گرادیان زیان را نسبت به تکتک وزنها حساب کنید، هر وزن را خلاف جهت گرادیانش حرکت دهید و طول گام را با نرخ یادگیری تنظیم کنید.
کل الگوریتم در همین یک خط خلاصه میشود:
نرخ یادگیری: مهمترین ابرپارامتر
نرخ یادگیری اندازهی گامها را تعیین میکند و تمام رفتار همگرایی به آن وابسته است.
هیچ فرمولی برای پیدا کردن نرخ یادگیری مناسب وجود ندارد؛ باید آن را با آزمایش به دست آورید. مقادیر اولیهی رایج عبارتاند از: 0.001 برای Adam و 0.01 برای SGD با تکانه.
مقایسهی SGD، دستهای (Batch) و دستهی کوچک (Mini-batch)
گرادیان کاهشی ساده قبل از برداشتن حتی یک گام، گرادیان را روی کل مجموعهداده حساب میکند. به این حالت گرادیان کاهشی دستهای (batch gradient descent) میگویند که پایدار ولی کند است.
گرادیان کاهشی تصادفی (Stochastic gradient descent یا SGD) گرادیان را فقط بر اساس یک نمونهی تصادفی حساب میکند و بلافاصله گام برمیدارد. این روش پرنوفه (noisy) ولی سریع است.
گرادیان کاهشی دستهی کوچک (mini-batch gradient descent) راه میانهای انتخاب میکند: گرادیان را روی یک دستهی کوچک (32، 64، 128 یا 256 نمونه) حساب میکند و بعد گام برمیدارد. در عمل همه از همین روش استفاده میکنند.
| روش | اندازهی دسته | کیفیت گرادیان | سرعت در هر گام | نوفه |
|---|---|---|---|---|
| دستهای (Batch GD) | کل مجموعهداده | دقیق | کند | صفر |
| تصادفی (SGD) | 1 نمونه | بسیار پرنوفه | سریع | بالا |
| دستهی کوچک (Mini-batch) | 32 تا 256 | برآورد خوب | متوازن | متوسط |
نوفهی موجود در SGD و دستههای کوچک یک نقص نیست؛ بلکه کمک میکند تا بهینهساز از کمینههای محلی کمعمق و نقاط زینی فرار کند.
تکانه: توپی که از تپه پایین میغلتد
گرادیان کاهشی ساده فقط گرادیان لحظهی فعلی را میبیند. اگر گرادیان مدام زیگزاگ برود (که در درههای باریک اتفاقی رایج است)، پیشرفت بسیار کند خواهد بود. تکانه (momentum) با جمعآوری گرادیانهای گذشته در قالب یک عبارت سرعت (velocity)، این مشکل را حل میکند.
میتوانید آن را مثل توپی فرض کنید که از تپه پایین میغلتد. توپ با هر دستانداز کوچک متوقف نمیشود و دوباره از صفر شروع نمیکند؛ بلکه در جهتهای پایدار شتاب میگیرد و نوسانات را خنثی میکند.
پارامتر beta (معمولاً 0.9) تعیین میکند چه مقدار از تاریخچهی قبلی حفظ شود. بتای بزرگتر یعنی تکانهی بیشتر، مسیرهای نرمتر و در عین حال واکنش کندتر به تغییر جهتها.
بهینهساز Adam: نرخهای یادگیری تطبیقی
وزنهای مختلف به نرخهای یادگیری متفاوتی نیاز دارند. وزنی که بهندرت گرادیانهای بزرگ دریافت میکند، وقتی بالاخره گرادیانی گرفت باید گامهای بلندتری بردارد. در مقابل، وزنی که مدام گرادیانهای بزرگ دریافت میکند باید با گامهای کوتاهتری جلو برود.
بهینهساز Adam (برآورد گشتاور تطبیقی یا Adaptive Moment Estimation) برای هر وزن دو متغیر را دنبال میکند:
- گشتاور اول (): میانگین متحرک گرادیانها (مشابه تکانه)
- گشتاور دوم (): میانگین متحرک مربع گرادیانها (بزرگی گرادیان)
نکتهی کلیدی در تقسیم بر sqrt(v_hat) نهفته است. وزنهایی با گرادیانهای بزرگ بر عددی بزرگ تقسیم میشوند (گام مؤثر کوچک). وزنهایی با گرادیانهای کوچک بر عددی کوچک تقسیم میشوند (گام مؤثر بزرگ). به این ترتیب، هر وزن نرخ یادگیری تطبیقی اختصاصی خودش را دریافت میکند.
ابرپارامترهای پیشفرض: lr=0.001, beta1=0.9, beta2=0.999, epsilon=1e-8. این مقادیر پیشفرض برای بیشتر مسئلهها عالی کار میکنند.
برنامههای زمانبندی نرخ یادگیری
استفاده از یک نرخ یادگیری ثابت نوعی مصالحه است. در اوایل آموزش به گامهای بلند نیاز دارید تا سریع جلو بروید؛ اما در اواخر آموزش گامهای کوتاه لازم دارید تا نزدیک نقطهی کمینه را بهدقت تنظیم کنید.
برنامههای زمانبندی رایج:
| برنامه | فرمول | کاربرد |
|---|---|---|
| کاهش پلهای (Step decay) | در هر دور (epoch) | کنترل دستی و ساده |
| کاهش نمایی (Exponential decay) | کاهش پیوسته و هموار | |
| بازپخت کسینوسی (Cosine annealing) | ترنسفورمرها و آموزش مدلهای امروزی | |
| گرمکردن اولیه + کاهش (Warmup + decay) | افزایش خطی و سپس کاهش | مدلهای بزرگ، جلوگیری از ناپایداری در شروع |
کوژ در برابر غیرکوژ
یک تابع کوژ (convex) هیچ کمینهی محلی بدی ندارد؛ هر کمینهی محلی، همان کمینهی سراسری (global minimum) است. برای یک تابع کوژ و هموار که دارای کمینه باشد، گرادیان کاهشی با نرخ یادگیریِ بهقدر کافی کوچک قطعاً به آن همگرا میشود. یک تابع درجهدو مثل کوژ است و کمینهی یکتایی دارد.
توابع زیان شبکههای عصبی غیرکوژ هستند؛ یعنی پر از کمینههای محلی گوناگون، نقاط زینی و سطوح هموارند.
در عمل، کمینههای محلی در فضاهای پربعد شبکههای عصبی بهندرت دردسرساز میشوند؛ چون مقدار زیان در بیشتر کمینههای محلی بسیار نزدیک به کمینهی سراسری است. مانع اصلی در واقع نقاط زینی هستند (نقاطی که در بعضی جهتها تخت و در بعضی جهتها انحنادارند). تکانه و نوفهی حاصل از دستههای کوچک کمک میکنند تا از این نقاط عبور کنیم.
مصورسازی چشمانداز زیان
زیان، تابعی از تمام وزنهاست. برای مدلی با 1 میلیون وزن، چشمانداز زیان در فضایی 1,000,001 بعدی قرار دارد. ما برای نمایش آن، دو جهت تصادفی را در فضای وزنها انتخاب میکنیم و تغییرات زیان را در طول آن دو جهت رسم میکنیم تا سطحی دوبعدی به دست آید.
کمینههای تیز و باریک تعمیمپذیری ضعیفی دارند، در حالی که کمینههای تخت و گسترده بهخوبی تعمیم مییابند. به همین دلیل است که SGD با تکانه معمولاً در دقت نهایی روی دادههای آزمون از Adam جلو میزند؛ چون نوفهی موجود در آن مانع از گیر افتادن مدل در کمینههای تیز میشود.
پیادهسازی از صفر
گام 1: تعریف تابع آزمون
تابع روزنبروک یک معیار استاندارد و کلاسیک برای ارزیابی بهینهسازی است. کمینهی این تابع در نقطهی (1, 1) و درون درهای باریک و خمیده قرار دارد؛ درهای که پیدا کردنش ساده ولی جلو رفتن در آن بسیار دشوار است.
def rosenbrock(params):
    x, y = params
    return (1 - x) ** 2 + 100 * (y - x ** 2) ** 2

def rosenbrock_gradient(params):
    x, y = params
    df_dx = -2 * (1 - x) + 200 * (y - x ** 2) * (-2 * x)
    df_dy = 200 * (y - x ** 2)
    return [df_dx, df_dy]
گام 2: گرادیان کاهشی ساده
class GradientDescent:
    def __init__(self, lr=0.001):
        self.lr = lr

    def step(self, params, grads):
        return [p - self.lr * g for p, g in zip(params, grads)]
گام 3: SGD با تکانه
class SGDMomentum:
    def __init__(self, lr=0.001, momentum=0.9):
        self.lr = lr
        self.momentum = momentum
        self.velocity = None

    def step(self, params, grads):
        if self.velocity is None:
            self.velocity = [0.0] * len(params)
        self.velocity = [
            self.momentum * v + g
            for v, g in zip(self.velocity, grads)
        ]
        return [p - self.lr * v for p, v in zip(params, self.velocity)]
گام 4: بهینهساز Adam
class Adam:
    def __init__(self, lr=0.001, beta1=0.9, beta2=0.999, epsilon=1e-8):
        self.lr = lr
        self.beta1 = beta1
        self.beta2 = beta2
        self.epsilon = epsilon
        self.m = None
        self.v = None
        self.t = 0

    def step(self, params, grads):
        if self.m is None:
            self.m = [0.0] * len(params)
            self.v = [0.0] * len(params)

        self.t += 1

        self.m = [
            self.beta1 * m + (1 - self.beta1) * g
            for m, g in zip(self.m, grads)
        ]
        self.v = [
            self.beta2 * v + (1 - self.beta2) * g ** 2
            for v, g in zip(self.v, grads)
        ]

        m_hat = [m / (1 - self.beta1 ** self.t) for m in self.m]
        v_hat = [v / (1 - self.beta2 ** self.t) for v in self.v]

        return [
            p - self.lr * mh / (vh ** 0.5 + self.epsilon)
            for p, mh, vh in zip(params, m_hat, v_hat)
        ]
گام 5: اجرا و مقایسه
def optimize(optimizer, func, grad_func, start, steps=5000):
    params = list(start)
    history = [params[:]]
    for _ in range(steps):
        grads = grad_func(params)
        params = optimizer.step(params, grads)
        history.append(params[:])
    return history

start = [-1.0, 1.0]

gd_history = optimize(GradientDescent(lr=0.0005), rosenbrock, rosenbrock_gradient, start)
sgd_history = optimize(SGDMomentum(lr=0.0001, momentum=0.9), rosenbrock, rosenbrock_gradient, start)
adam_history = optimize(Adam(lr=0.01), rosenbrock, rosenbrock_gradient, start)

for name, history in [("GD", gd_history), ("SGD+M", sgd_history), ("Adam", adam_history)]:
    final = history[-1]
    loss = rosenbrock(final)
    print(f"{name:6s} -> x={final[0]:.6f}, y={final[1]:.6f}, loss={loss:.8f}")
خروجی مورد انتظار: بهینهساز Adam از همه سریعتر همگرا میشود. بهینهساز SGD با تکانه مسیر هموارتری را طی میکند و گرادیان کاهشی ساده پیشرفت بسیار کندی در طول درهی باریک دارد.
استفاده از ابزارهای واقعی
در عمل از بهینهسازهای PyTorch یا JAX استفاده کنید. این ابزارها مواردی مثل گروهبندی پارامترها، کاهش وزن (weight decay)، برش گرادیان (gradient clipping) و شتابدهی با GPU را بهطور خودکار مدیریت میکنند.
import torch

model = torch.nn.Linear(784, 10)

sgd = torch.optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
adam = torch.optim.Adam(model.parameters(), lr=0.001)
adamw = torch.optim.AdamW(model.parameters(), lr=0.001, weight_decay=0.01)

scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(adam, T_max=100)
چند قانون سرانگشتی:
- کار را با Adam و نرخ 0.001 شروع کنید؛ برای بیشتر مسئلهها بدون دستکاری جواب میدهد.
- وقتی به بالاترین دقت نهایی نیاز دارید و وقت کافی برای تنظیم پارامترها دارید، سراغ SGD با تکانه بروید (با lr=0.01 و momentum=0.9).
- برای ترنسفورمرها از AdamW (همان Adam به همراه تفکیک کاهش وزن) استفاده کنید.
- برای آموزشهایی که بیش از چند دور طول میکشند، همیشه یک برنامهی زمانبندی نرخ یادگیری تنظیم کنید.
- اگر فرایند آموزش ناپایدار شد، نرخ یادگیری را کم کنید. اگر روند آموزش خیلی کند بود، آن را زیاد کنید.
خروجی این درس
خروجی این درس یک پرامپت آماده برای انتخاب بهینهساز مناسب است. فایل outputs/prompt-optimizer-guide.md را ببینید.
کلاسهای بهینهسازی که اینجا ساختیم، در فاز 3 و هنگام آموزش یک شبکه عصبی از صفر دوباره استفاده خواهند شد.
تمرینها
-
بررسی دامنهی نرخ یادگیری. گرادیان کاهشی ساده را روی تابع روزنبروک با نرخهای یادگیری [0.0001, 0.0005, 0.001, 0.005, 0.01] اجرا کنید. میزان زیان نهایی را بعد از 5000 گام برای هر کدام رسم یا چاپ کنید. بزرگترین نرخ یادگیری را که هنوز همگرا میشود پیدا کنید.
-
مقایسهی تکانه. الگوریتم SGD را با مقادیر تکانهی [0.0, 0.5, 0.9, 0.99] روی تابع روزنبروک اجرا کنید. مقدار زیان را در تکتک گامها ثبت کنید. کدام مقدار تکانه سریعتر همگرا میشود؟ کدام مقدار دچار پرش از روی کمینه (overshoot) میشود؟
-
فرار از نقطهی زینی. تابع را تعریف کنید (که یک نقطهی زینی در مبدأ مختصات دارد). حرکت را از نقطهی (0.01, 0.01) شروع کنید. رفتار سه بهینهساز گرادیان کاهشی ساده، SGD با تکانه و Adam را با هم مقایسه کنید. کدام بهینهساز موفق میشود از نقطهی زینی فرار کند؟
-
پیادهسازی کاهش نرخ یادگیری. یک برنامهی کاهش نمایی به کلاس GradientDescent اضافه کنید:
lr = lr_0 * 0.999^step. وضعیت همگرایی را با و بدون کاهش نرخ یادگیری روی تابع روزنبروک مقایسه کنید.
راهنماییها
تمرین 1. روی نرخهای یادگیری حلقه بزنید، برای هر کدام شیء GradientDescent(lr=...) را بسازید و آن را همراه با rosenbrock و rosenbrock_gradient به تابع optimize بدهید. اجرایی که واگرا شود، مقدار زیانش مدام رشد میکند یا به nan تبدیل میشود؛ کمینهی این تابع در نقطهی با مقدار زیان 0 قرار دارد.
تمرین 2. برای هر مقدار تکانه یک SGDMomentum(momentum=m) بسازید و زیان را بعد از هر گام ثبت کنید. از تابع find_convergence_step برای مقایسهی سرعت همگرایی کمک بگیرید و تغییرات نوسانی زیان را برای پیدا کردن حالت پرش (overshoot) بررسی کنید.
تمرین 3. گرادیان تابع را به صورت بنویسید و هر سه بهینهساز را از نقطهی (0.01, 0.01) اجرا کنید. مقدار را هر 100 گام یکبار چاپ کنید؛ بهینهسازی از نقطهی زینی فرار کرده است که مقدار در آن به عددی بزرگ برسد.
تمرین 4. مقادیر lr_0 و یک شمارندهی گام را درون GradientDescent ذخیره کنید و داخل متد step مقدار نرخ را با رابطهی lr = lr_0 * 0.999 ** step حساب کنید. نرخ یادگیری را در گامهای 0 و 1000 چاپ کنید؛ این مقدار باید از lr_0 شروع شده و تقریباً تا افت کند.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| گرادیان کاهشی (Gradient descent) | «حرکت به سمت پایین» | بهروزرسانی وزنها از طریق تفریق گرادیان مقیاسشده با نرخ یادگیری. پایهایترین بهینهساز. |
| نرخ یادگیری (Learning rate) | «طول گام» | یک عدد اسکالر که میزان جابهجایی وزنها را در هر بهروزرسانی تعیین میکند. مقدار خیلی زیاد باعث واگرایی میشود و مقدار خیلی کم توان محاسباتی را هدر میدهد. |
| تکانه (Momentum) | «حفظ شتاب حرکت» | جمعآوری گرادیانهای گذشته در یک بردار سرعت. نوسانات جانبی را خنثی میکند و به حرکت در جهتهای پایدار شتاب میدهد. |
| گرادیان کاهشی تصادفی (SGD) | «نمونهبرداری تصادفی» | گرادیان کاهشی تصادفی. محاسبهی گرادیان روی زیرمجموعهای تصادفی بهجای کل مجموعهداده. در کاربردهای عملی تقریباً همیشه منظور همان SGD با دستهی کوچک است. |
| دستهی کوچک (Mini-batch) | «بخشی از دادهها» | بخش کوچکی از دادههای آموزشی (32 تا 256 نمونه) که برای برآورد گرادیان استفاده میشود و تعادلی میان سرعت و دقت گرادیان برقرار میکند. |
| بهینهساز Adam | «بهینهساز پیشفرض» | برآورد گشتاور تطبیقی. میانگین متحرک گرادیانها و مربع آنها را برای هر وزن جداگانه ردیابی میکند تا نرخ یادگیری متناسبی به هر کدام اختصاص دهد. |
| تصحیح بایاس (Bias correction) | «جبران شروع سرد» | گشتاورهای اول و دوم در بهینهساز Adam در ابتدا صفر هستند. تصحیح بایاس با تقسیم مقادیر بر این کمبود را در گامهای ابتدایی جبران میکند. |
| برنامهی زمانبندی نرخ یادگیری (Learning rate schedule) | «تغییر نرخ یادگیری در طول زمان» | تابعی که نرخ یادگیری را در طول دورهی آموزش تنظیم میکند؛ گامهای بلند در ابتدا و گامهای کوتاه در انتها. |
| تابع کوژ (Convex function) | «یک دره» | تابعی که در آن هر کمینهی محلی حتماً کمینهی سراسری است. گرادیان کاهشی همیشه آن را پیدا میکند. توابع زیان شبکههای عصبی کوژ نیستند. |
| نقطهی زینی (Saddle point) | «تخت ولی نه کمینه» | نقطهای که گرادیان در آن صفر است، اما در بعضی جهتها کمینه و در بعضی جهتهای دیگر بیشینه محسوب میشود. در فضاهای پربعد بسیار رایج است. |
| چشمانداز زیان (Loss landscape) | «پستی و بلندیها» | نمودار تابع زیان روی فضای وزنها که با ایجاد برشی در امتداد دو جهت تصادفی مصورسازی میشود. |
| همگرایی (Convergence) | «رسیدن به مقصد» | وضعیتی که بهینهساز به نقطهای رسیده که گامهای بعدی دیگر تغییر محسوسی در کاهش زیان ایجاد نمیکنند. |
برای مطالعهی بیشتر
- مروری بر الگوریتمهای بهینهسازی گرادیان کاهشی از سباستین رادر (Sebastian Ruder) - بررسی جامع و کامل تمام بهینهسازهای مهم
- تکانه واقعاً چگونه کار میکند؟ (نشریه Distill) - مصورسازی تعاملی سازوکار و دینامیک تکانه
- مقاله Adam: روشی برای بهینهسازی تصادفی (کینگما و با، 2014) - مقالهی اصلی معرفی Adam؛ متنی روان و کوتاه
- مصورسازی چشمانداز زیان شبکههای عصبی (لی و همکاران، 2018) - مقالهای مهم که تفاوت کمینههای تیز و تخت را نشان داد