
وقتی دو بردار عددی را با هم مقایسه میکنید؛ چه در یک پایگاه دادهی برداری (Vector Database)، چه در خوشهبندی یا سیستم توصیهگر، نخستین تصمیم شما انتخاب تابع فاصله است. متریک فاصلهای که برمیگزینید دقیقاً تعیین میکند که مفهوم «شباهت» چیست. اگر در دادههای متنی یا متغیرهایی با مقیاسهای متفاوت متریک اشتباهی انتخاب کنید، نزدیکترین همسایهها کاملاً اشتباه پیدا میشوند و مدل شما به بیراهه میرود.
در سیستمهای نوین مبتنی بر امبدینگ و بازیابی اطلاعات، تمایز میان شباهت کسینوسی (Cosine Similarity)، فاصلهی اقلیدسی (L2) و سایر متریکها مانند ماهالانوبیس تفاوت میان یک سیستم دقیق و یک خروجی غیرقابل استفاده است. در این درس مفاهیم هندسی و ریاضی تمام معیارهای پرکاربرد فاصله و نرمها را بررسی میکنیم و میبینیم چگونه هر کدام هندسهی متفاوتی برای فضای ویژگیها میسازند.
تابع فاصلهی انتخابی شما، معنای «شباهت» را تعریف میکند. اگر اشتباه انتخاب کنید، همهچیز در ادامهی مسیر خراب میشود.
اهداف یادگیری
- پیادهسازی توابع فاصلهی L1، L2، کسینوسی، ماهالانوبیس (Mahalanobis)، جاکارد (Jaccard) و ویرایشی (edit distance) از صفر
- انتخاب متریک فاصلهی مناسب برای یک تسک یادگیری ماشین معین و توضیح دلیل ناکارآمدی گزینههای دیگر
- ارتباط میان نرمهای L1 و L2 با منظمسازیهای لاسو (LASSO) و ریج (Ridge) و نواحی قید هندسی آنها
- نشان دادن اینکه چگونه یک دیتاست واحد، تحت متریکهای مختلف نزدیکترین همسایههای متفاوتی تولید میکند
صورت مسئله
دو بردار دارید. شاید این بردارها امبدینگهای کلمات باشند، شاید پروفایل کاربران و شاید هم آرایههایی از پیکسلها. میخواهید بدانید: این دو بردار چقدر به هم نزدیکاند؟
پاسخ این پرسش کاملاً به تابع فاصلهای بستگی دارد که انتخاب میکنید. دو نقطهی داده ممکن است تحت یک متریک نزدیکترین همسایه باشند و تحت متریکی دیگر فرسنگها از هم فاصله داشته باشند. طبقهبند KNN، موتور توصیهگر، پایگاه دادهی برداری، الگوریتم خوشهبندی و تابع زیان شما همگی به این انتخاب وابستهاند. اگر اشتباه انتخاب کنید، مدل شما برای هدفی نادرست بهینهسازی میشود.
هیچ «بهترین فاصلهی مطلقی» وجود ندارد. فاصلهی L2 برای دادههای مکانی عالی است. شباهت کسینوسی بر دنیای NLP حکمرانی میکند. جاکارد به کار مجموعهها میآید. فاصلهی ویرایشی برای رشتههای متنی است. ماهالانوبیس همبستگی میان متغیرها را لحاظ میکند. واسرشتاین (Wasserstein) جرم احتمالی را جابهجا میکند. هر یک از این متریکها فرض متفاوتی را دربارهی معنای «شبیه بودن» در دل خود جای دادهاند.
در این درس تمام توابع فاصلهی اصلی را از صفر پیادهسازی میکنیم، نشان میدهیم هر کدام در چه شرایطی ابزار مناسبی هستند و بررسی میکنیم که چگونه دادههای یکسان، بسته به متریک انتخابی شما، نزدیکترین همسایههای کاملاً متفاوتی پیدا میکنند.
مفاهیم پایه
نرمها: اندازهگیری بزرگی بردار
نرم، «بزرگی» یا اندازهی یک بردار را میسنجد. هر تابع فاصلهای میان دو بردار را میتوان بهصورت نرم تفاضل آنها نوشت: . بنابراین درک نرمها مساوی با درک فاصلههاست.
نرم L1 (فاصلهی منهتن)
نرم L1 مجموع قدرمطلق تمام مؤلفهها را محاسبه میکند.
به این دلیل فاصلهی منهتن نامیده میشود که فاصلهی پیادهروی روی یک شبکهی خیابانی شطرنجی را نشان میدهد؛ جایی که فقط میتوانید در امتداد محورها حرکت کنید و از مسیرهای مورب خبری نیست.
Point A = (1, 1)
Point B = (4, 5)

L1 distance = |4-1| + |5-1| = 3 + 4 = 7

On a grid, you walk 3 blocks east and 4 blocks north.
چه زمانی از L1 استفاده کنیم:
- دادههای خلوت (sparse) با ابعاد بالا (ویژگیهای متنی، کدگذاریهای one-hot)
- زمانی که مقاومت در برابر دادههای پرت (outliers) برایتان مهم است (یک اختلاف بسیار بزرگ کل نتیجه را تحتالشعاع قرار نمیدهد)
- مسائل انتخاب ویژگی (منظمسازی L1 باعث خلوت شدن وزنها میشود)
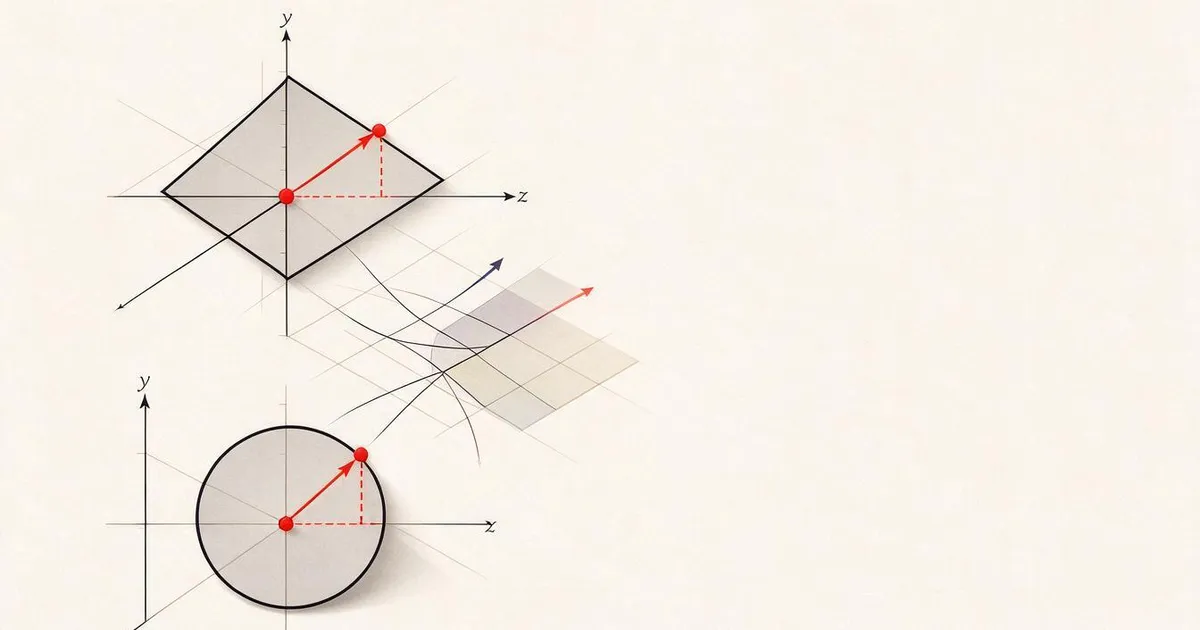
ارتباط با منظمسازی L1 (لاسو): افزودن به تابع زیان، مجموع قدرمطلق مقادیر وزنها را جریمه میکند. این کار وزنهای کوچک را دقیقاً به صفر push میکند و عملاً نوعی انتخاب ویژگی خودکار انجام میدهد. جریمهی L1 نواحی قید لوزیشکل در فضای وزنها ایجاد میکند و گوشههای این لوزیها دقیقاً روی محورها قرار دارند؛ یعنی جایی که برخی از وزنها صفرند.
ارتباط با توابع زیان: میانگین خطای مطلق (MAE) در واقع میانگین فاصلهی L1 میان پیشبینیها و مقادیر هدف است. این تابع تمام خطاها را بهصورت خطی جریمه میکند، بنابراین در مقایسه با MSE مقاومت بسیار بیشتری در برابر دادههای پرت دارد.
نرم L2 (فاصلهی اقلیدسی)
نرم L2 همان فاصلهی خط مستقیم است؛ یعنی جذر مجموع توان دوم مؤلفهها.
این همان فاصلهای است که در کلاس هندسه خواندهاید؛ فیثاغورس در بعد.
Point A = (1, 1)
Point B = (4, 5)

L2 distance = sqrt((4-1)^2 + (5-1)^2) = sqrt(9 + 16) = sqrt(25) = 5.0

The straight line, cutting diagonally through the grid.
چه زمانی از L2 استفاده کنیم:
- دادههای پیوسته با ابعاد کم تا متوسط
- زمانی که مقیاس ویژگیها با هم قابل مقایسهاند
- فاصلههای فیزیکی (دادههای مکانی، مقادیر حسگرها)
- شباهت تصاویر در سطح پیکسل
ارتباط با منظمسازی L2 (ریج): افزودن به تابع زیان، وزنهای بزرگ را جریمه میکند. برعکس L1، وزنها را به صفر push نمیکند، بلکه تمام وزنها را به شکلی متناسب به سمت صفر کوچک میکند. جریمهی L2 نواحی قید دایرهای ایجاد میکند، در نتیجه هیچ گوشهای روی محورها وجود ندارد. وزنها کوچک میشوند اما بهندرت دقیقاً برابر با صفر خواهند شد.
ارتباط با توابع زیان: میانگین مربعات خطا (MSE) همان میانگین مجذور فاصلههای L2 است. به توان دو رساندن باعث میشود خطاهای بزرگ بسیار سنگینتر از خطاهای کوچک جریمه شوند.
نرمهای Lp: خانوادهی تعمیمیافته
نرمهای L1 و L2 حالتهای خاصی از نرم Lp هستند:
مقادیر مختلف ، «گویهای واحد» متفاوتی تولید میکنند (مجموعهی تمام نقاطی که فاصلهشان از مبدأ حداکثر 1 است؛ شکلهای زیر مرز این گویها را نشان میدهند):
p=1:    Diamond shape      (corners on axes)
p=2:    Circle/sphere      (the usual round ball)
p=3:    Superellipse       (rounded square)
p=inf:  Square/hypercube   (flat sides along axes)
نرم L-بینهایت (فاصلهی چبیشف)
وقتی به سمت بینهایت میل میکند، نرم Lp به بزرگترین قدرمطلق مؤلفهها همگرا میشود.
فاصلهی بین دو نقطه را تنها بُعدی تعیین میکند که بیشترین اختلاف را در آن دارند؛ بقیهی ابعاد کاملاً نادیده گرفته میشوند.
چه زمانی از L-بینهایت استفاده کنیم:
- زمانی که بیشترین انحراف در هر تکبُعد تعیینکننده است
- صفحات بازی (شاه در شطرنج با متریک L-بینهایت حرکت میکند: یک گام در هر جهتی هزینهی 1 دارد)
- تلورانسهای تولید (هر بُعد باید بهطور مجزا در محدودهی استاندارد باشد)
شباهت کسینوسی و فاصلهی کسینوسی
شباهت کسینوسی زاویهی بین دو بردار را اندازه میگیرد و بزرگی آنها را نادیده میگیرد.
این مقدار بین 1- (جهتهای کاملاً مخالف) تا 1+ (جهت کاملاً یکسان) متغیر است. بردارهای عمود بر هم شباهت کسینوسی برابر با 0 دارند.
فاصلهی کسینوسی این مقدار را به یک فاصله تبدیل میکند: cosine_distance = 1 - cosine_similarity. بازهی این فاصله از 0 (جهت یکسان) تا 2 (جهت کاملاً مخالف) است.
چرا کسینوسی بر NLP و امبدینگها مسلط است: در متن، طول سند نباید روی شباهت تأثیر بگذارد. سندی دربارهی گربهها که طولش دو برابر سندی دیگر دربارهی گربههاست، همچنان باید «شبیه» تلقی شود. شباهت کسینوسی بزرگی (طول) را نادیده میگیرد و فقط به جهت نگاه میکند. دو سند با توزیع کلمات یکسان اما طولهای متفاوت، به یک جهت اشاره میکنند و شباهت کسینوسی آنها دقیقاً 1.0 خواهد بود.
چه زمانی از شباهت کسینوسی استفاده کنیم:
- شباهت متنی (بردارهای TF-IDF، امبدینگهای کلمات، امبدینگهای جملات)
- هر حوزهای که بزرگی بردار نویز محسوب میشود و سیگنال اصلی در جهت نهفته است
- سیستمهای توصیهگر (بردارهای ترجیحات کاربران)
- جستجوی امبدینگ (پایگاههای دادهی برداری تقریباً همیشه از کسینوسی یا ضرب نقطهای استفاده میکنند)
مقایسهی شباهت ضرب نقطهای و شباهت کسینوسی
ضرب نقطهای (dot product) دو بردار عبارت است از:
شباهت کسینوسی در واقع همان ضرب نقطهای است که بر بزرگی هر دو بردار تقسیم (نرمالسازی) شده است. اگر هر دو بردار از قبل نرمال شده باشند (اندازهی هر کدام برابر با 1 باشد)، ضرب نقطهای و شباهت کسینوسی کاملاً یکسان خواهند بود.
تفاوت در کجاست: ضرب نقطهای اطلاعات بزرگی بردار را در خود دارد. برداری با اندازهی بزرگتر، امتیاز ضرب نقطهای بالاتری میگیرد. این موضوع در برخی سیستمهای بازیابی اهمیت دارد؛ جایی که میخواهید آیتمهای «محبوبتر» رتبهی بالاتری کسب کنند. در این سناریو، بزرگی بردار مثل یک سیگنال ضمنی برای کیفیت یا اهمیت آیتم عمل میکند.
a = (3, 0)    b = (1, 0)    c = (0, 1)

dot(a, b) = 3     dot(a, c) = 0
cos(a, b) = 1.0   cos(a, c) = 0.0

Both agree on direction, but dot product also reflects magnitude.
در عمل:
- اگر صرفاً شباهت جهتی را میخواهید، از شباهت کسینوسی استفاده کنید
- اگر اندازهی بردار اطلاعات معناداری دارد، از ضرب نقطهای استفاده کنید
- بسیاری از پایگاههای دادهی برداری (مانند Pinecone، Weaviate و Qdrant) به شما اجازهی انتخاب بین این دو را میدهند
- اگر امبدینگهای شما با نرم L2 نرمال شده باشند، تفاوتی میان این دو نخواهد بود
فاصلهی ماهالانوبیس
فاصلهی اقلیدسی با تمام ابعاد رفتاری یکسان دارد. اما اگر ویژگیهای شما همبسته باشند یا مقیاسهای متفاوتی داشته باشند، فاصلهی L2 نتایج گمراهکنندهای خواهد داد.
فاصلهی ماهالانوبیس ساختار کوواریانس دادهها را در نظر میگیرد.
که در آن ماتریس کوواریانس دادههاست.
به زبان ساده: فاصلهی ماهالانوبیس ابتدا ناهمبستهسازی و نرمالسازی دادهها (سفیدسازی یا whitening) را انجام میدهد و سپس فاصلهی L2 را در آن فضای تبدیلیافته حساب میکند. اگر ماتریس همانی باشد (ویژگیهای ناهمبسته با واریانس برابر با 1)، فاصلهی ماهالانوبیس به همان فاصلهی اقلیدسی تقلیل مییابد.
Example: height and weight are correlated.
Someone 6'2" and 180 lbs is not unusual.
Someone 5'0" and 180 lbs is unusual.

Euclidean distance might say they are equally far from the mean.
Mahalanobis distance correctly identifies the second as an outlier
because it accounts for the height-weight correlation.
چه زمانی از فاصلهی ماهالانوبیس استفاده کنیم:
- تشخیص دادههای پرت (نقاطی با فاصلهی ماهالانوبیس زیاد از میانگین، دادهی پرت هستند)
- طبقهبندی در شرایطی که ویژگیها مقیاسها و همبستگیهای متفاوتی دارند
- زمانی که دادهی کافی برای برآورد یک ماتریس کوواریانس مطمئن در اختیار دارید
- کنترل کیفیت در فرایندهای تولید (پایش فرایندهای چندمتغیره)
شباهت جاکارد (برای مجموعهها)
شباهت جاکارد همپوشانی میان دو مجموعه را اندازه میگیرد.
این مقدار بین 0 (بدون همپوشانی) تا 1 (مجموعههای کاملاً یکسان) متغیر است. فاصلهی جاکارد نیز برابر است با: Jaccard distance = 1 - Jaccard similarity.
A = {cat, dog, fish}
B = {cat, bird, fish, snake}

Intersection = {cat, fish}         size = 2
Union = {cat, dog, fish, bird, snake}  size = 5

Jaccard similarity = 2/5 = 0.4
Jaccard distance = 0.6
چه زمانی از جاکارد استفاده کنیم:
- مقایسهی مجموعهای از برچسبها (tags)، دستهبندیها یا ویژگیها
- شباهت اسناد بر اساس حضور کلمات (نه بسامد آنها)
- تشخیص موارد تقریباً تکراری (تقریب جاکارد به کمک MinHash)
- مقایسهی بردارهای ویژگی دودویی (دادههای حضور/غیاب)
- ارزیابی مدلهای قطعهبندی (معیار Intersection over Union یا IoU همان جاکارد است)
فاصلهی ویرایشی (فاصلهی لِوِناشتاین)
فاصلهی ویرایشی، کمترین تعداد عملیات تککاراکتری لازم برای تبدیل یک رشته به رشتهی دیگر را میشمارد. این عملیات شامل درج (insert)، حذف (delete) یا جایگزینی (substitute) هستند.
"kitten" -> "sitting"

kitten -> sitten  (substitute k -> s)
sitten -> sittin  (substitute e -> i)
sittin -> sitting (insert g)

Edit distance = 3
این فاصله با استفاده از برنامهنویسی پویا (dynamic programming) محاسبه میشود؛ به این صورت که ماتریسی را پر میکنیم که درایهی آن، فاصلهی ویرایشی میان کاراکتر اول رشتهی A و کاراکتر اول رشتهی B است.
        ""  s  i  t  t  i  n  g
    ""   0  1  2  3  4  5  6  7
    k    1  1  2  3  4  5  6  7
    i    2  2  1  2  3  4  5  6
    t    3  3  2  1  2  3  4  5
    t    4  4  3  2  1  2  3  4
    e    5  5  4  3  2  2  3  4
    n    6  6  5  4  3  3  2  3
چه زمانی از فاصلهی ویرایشی استفاده کنیم:
- غلطیابی و تصحیح املایی
- همترازسازی توالیهای DNA (با وزندهی به عملیات مختلف)
- تطبیق فازی رشتهها (fuzzy string matching)
- حذف موارد تکراری در دادههای متنی شلخته
دیورژانس کولبک-لایبلر (فاصله نیست، اما شبیه فاصله استفاده میشود)
دیورژانس KL (یا Kullback-Leibler divergence) میزان تفاوت یک توزیع احتمال با توزیعی دیگر را میسنجد. این مبحث را در درس 09 بررسی کردیم، اما لازم است در این درس هم بیاید؛ زیرا با وجود اینکه فاصله نیست، مهندسان اغلب مثل یک «فاصله» از آن استفاده میکنند.
یک ویژگی بسیار مهم: دیورژانس KL متقارن نیست.
این یعنی دیورژانس KL شرایط اولیهی یک متریک فاصله را ندارد. در نامساوی مثلث هم صدق نمیکند. بنابراین یک دیورژانس است، نه یک فاصله.
دیورژانس KL مستقیم تمایل به پوشش میانگین دارد (mean-seeking): توزیع تلاش میکند تمام مُدهای توزیع را پوشش دهد. دیورژانس KL معکوس تمایل به تمرکز روی مُد دارد (mode-seeking): توزیع روی یک تکمُد از متمرکز میشود.
کاربردهای دیورژانس KL:
- مدلهای VAE (جملهی KL در ELBO توزیع نهفته را به سمت یک توزیع پیشین push میکند)
- تقطیر دانش یا Knowledge Distillation (مدل دانشآموز تلاش میکند با توزیع مدل معلم مطابقت پیدا کند)
- روش RLHF (جریمهی KL مدل ریزتنظیمشده را نزدیک به مدل پایه نگه میدارد)
- روشهای گرادیان خطمشی یا Policy Gradient (ایجاد قید روی بهروزرسانیهای خطمشی)
فاصلهی واسرشتاین (فاصلهی خاکبردار)
فاصلهی واسرشتاین حداقل «کار» لازم برای تبدیل یک توزیع احتمال به توزیعی دیگر را اندازه میگیرد. اینطور فرض کنید: اگر یک توزیع تلی از خاک و دیگری یک گودال باشد، چه مقدار خاک را تا چه فاصلهای باید جابهجا کنید؟
برای توزیعهای تکبعدی، این فرمول به انتگرال قدرمطلق تفاضل توابع توزیع تجمعی (CDF) ساده میشود:
چرا واسرشتاین مهم است:
- یک متریک واقعی است (متقارن است و در نامساوی مثلث صدق میکند)
- حتی زمانی که توزیعها هیچ همپوشانی ندارند گرادیان تولید میکند (در این حالت دیورژانس KL به سمت بینهایت میرود)
- همین ویژگی باعث شد تا نقش محوری در شبکههای Wasserstein GAN (یا WGAN) ایفا کند و ناپایداری آموزش در GANهای اولیه را رفع کند
Distributions with no overlap:

P: [1, 0, 0, 0, 0]    Q: [0, 0, 0, 0, 1]

KL divergence: infinity (log of zero)
Wasserstein: 4 (move all mass 4 bins)

Wasserstein gives a meaningful gradient. KL does not.
چه زمانی از واسرشتاین استفاده کنیم:
- آموزش شبکههای زاینده (WGAN و WGAN-GP)
- مقایسهی توزیعهایی که ممکن است هیچ همپوشانی نداشته باشند
- مسائل حملونقل بهینه (optimal transport)
- بازیابی تصاویر (مقایسهی هیستوگرامهای رنگی)
چرا تسکهای مختلف به فاصلههای متفاوتی نیاز دارند
| تسک | بهترین فاصله | دلیل |
|---|---|---|
| شباهت متنی | کسینوسی | اندازه نویز است و جهت مفهوم را نشان میدهد |
| مقایسهی پیکسلی تصاویر | L2 | روابط مکانی مهماند، ویژگیها مقیاس مقایسهپذیری دارند |
| ویژگیهای تنک با ابعاد بالا | L1 | مقاوم است و اختلافات بزرگ و نادر را تشدید نمیکند |
| همپوشانی مجموعهها (برچسبها، دستهها) | جاکارد | دادهها ذاتاً مجموعهای هستند، نه برداری |
| تطبیق رشتهها | فاصلهی ویرایشی | عملیات آن با شهود انسان از ویرایش متن همخوانی دارد |
| تشخیص دادههای پرت | ماهالانوبیس | همبستگی و مقیاسهای مختلف ویژگیها را لحاظ میکند |
| مقایسهی توزیعها | دیورژانس KL | میزان اطلاعات هدررفته در صورت استفاده از بهجای را میسنجد |
| آموزش GAN | واسرشتاین | حتی وقتی توزیعها همپوشانی ندارند گرادیان تولید میکند |
| امبدینگها (پایگاه دادهی برداری) | کسینوسی یا ضرب نقطهای | امبدینگها طوری آموزش دیدهاند که معنا را در جهت بردار کدگذاری کنند |
| سیستمهای توصیهگر | ضرب نقطهای | اندازهی بردار میتواند محبوبیت یا اطمینان را کدگذاری کند |
| توالیهای DNA | فاصلهی ویرایشی وزندار | هزینهی جایگزینی جفت نوکلئوتیدها با هم متفاوت است |
| کنترل کیفیت در فرایندهای تولید | L-بینهایت | بیشترین انحراف در هر تکبُعد تعیینکننده است |
ارتباط با توابع زیان
توابع زیان در واقع همان توابع فاصله هستند که روی مقادیر پیشبینیشده در برابر مقادیر هدف اعمال میشوند.
Loss function       Distance it uses       Behavior
MSE                 L2 squared             Penalizes large errors heavily
MAE                 L1                     Penalizes all errors equally
Huber loss          L1 for large errors,   Best of both: robust to outliers,
                    L2 for small errors    smooth gradient near zero
Cross-entropy       KL divergence          Measures distribution mismatch
Hinge loss          max(0, margin - d)     Only penalizes below margin
Triplet loss        L2 (typically)         Pulls positives close, pushes
                                           negatives away
Contrastive loss    L2                     Similar pairs close, dissimilar
                                           pairs beyond margin
ارتباط با منظمسازی
منظمسازی جریمهای از جنس نرم روی وزنها به تابع زیان اضافه میکند.
L1 regularization (Lasso):   loss + lambda * ||w||_1
  -> Sparse weights. Some weights become exactly zero.
  -> Automatic feature selection.
  -> Solution has corners (non-differentiable at zero).

L2 regularization (Ridge):   loss + lambda * ||w||_2^2
  -> Small weights. All weights shrink toward zero.
  -> No feature selection (nothing goes to exactly zero).
  -> Smooth solution everywhere.

Elastic Net:                  loss + lambda_1 * ||w||_1 + lambda_2 * ||w||_2^2
  -> Combines sparsity of L1 with stability of L2.
  -> Groups of correlated features are kept or dropped together.
چرا L1 تنکی ایجاد میکند اما L2 نه: ناحیهی قید را در یک فضای دوبعدی وزن تجسم کنید. قید L1 یک لوزی و قید L2 یک دایره است. منحنیهای تراز بیضیشکل تابع زیان به احتمال زیاد لوزی را در یکی از گوشهها لمس میکنند؛ یعنی جایی که یکی از وزنها صفر است. در مقابل، این بیضیها دایره را در نقطهای هموار لمس میکنند که در آن هر دو وزن غیرصفر هستند.
جستجوی نزدیکترین همسایه
هر تابع فاصلهای به یک مسئلهی جستجوی نزدیکترین همسایه منتهی میشود: به ازای یک نقطهی کوئری مشخص، نزدیکترین نقاط را در یک دیتاست پیدا کن.
جستجوی دقیق نزدیکترین همسایه برای یک کوئری در دیتاستی با نقطه و بُعد دارای پیچیدگی زمانی است. برای دیتاستهای بزرگ، این سرعت بسیار پایین است.
الگوریتمهای تقریبی نزدیکترین همسایه (Approximate Nearest Neighbor یا ANN) مقدار اندکی از دقت را فدای افزایش چشمگیر سرعت میکنند:
Algorithm         Approach                      Used by
KD-trees          Axis-aligned space partition   scikit-learn (low-dim)
Ball trees        Nested hyperspheres            scikit-learn (medium-dim)
LSH               Random hash projections        Near-duplicate detection
HNSW              Hierarchical navigable         FAISS, Qdrant, Weaviate
                  small-world graph
IVF               Inverted file index with       FAISS (billion-scale)
                  cluster-based search
Product quant.    Compress vectors, search       FAISS (memory-constrained)
                  in compressed space
الگوریتم HNSW (گراف دنیای کوچک ناوبر سلسلهمراتبی) الگوریتم غالب در پایگاههای دادهی برداری امروزی است. این روش گرافی چندلایه میسازد که در آن هر گره به نزدیکترین همسایههای تقریبی خود متصل است. جستجو از بالاترین لایه (تنک، با پرشهای بلند) شروع میشود و به پایینترین لایه (متراکم، با پرشهای کوتاه) میرسد.
پیادهسازی از صفر
گام 1: پیادهسازی تمام توابع نرم و فاصله
برای دیدن کد کامل پیادهسازی به code/distances.py مراجعه کنید. هر تابع از پایه و تنها با محاسبات پایهای ریاضی پایتون پیادهسازی شده است.
گام 2: دادههای یکسان، فاصلههای متفاوت، همسایههای گوناگون
دموی موجود در distances.py دیتاستی میسازد، یک نقطهی کوئری تعیین میکند و نشان میدهد که چگونه نزدیکترین همسایه با تغییر متریک فاصله عوض میشود. نقطهای که تحت نرم L1 «نزدیکترین» است، ممکن است تحت L2 یا کسینوسی دیگر نزدیکترین نباشد.
گام 3: جستجوی شباهت با امبدینگها
این کد شامل یک جستجوی شباهت امبدینگ ماک (mock) است که شبیهترین «اسناد» به یک کوئری را با شباهت کسینوسی در برابر فاصلهی L2 پیدا میکند و نشان میدهد رتبهبندی نتایج در این دو حالت متفاوت خواهد بود.
استفاده از ابزارهای واقعی
رایجترین کاربرد عملیاتی این مبحث، یافتن آیتمهای مشابه در پایگاههای دادهی برداری است.
import numpy as np

def cosine_similarity_matrix(X):
    norms = np.linalg.norm(X, axis=1, keepdims=True)
    norms = np.where(norms == 0, 1, norms)
    X_normalized = X / norms
    return X_normalized @ X_normalized.T

embeddings = np.random.randn(1000, 768)

sim_matrix = cosine_similarity_matrix(embeddings)

query_idx = 0
similarities = sim_matrix[query_idx]
top_k = np.argsort(similarities)[::-1][1:6]
print(f"Top 5 most similar to item 0: {top_k}")
print(f"Similarities: {similarities[top_k]}")
وقتی متد model.encode(text) را صدا میزنید و بعد در یک پایگاه دادهی برداری جستجو میکنید، دقیقاً این اتفاق زیر هود رخ میدهد: مدل امبدینگ متن را به بردار تبدیل میکند. سپس پایگاه دادهی برداری شباهت کسینوسی (یا ضرب نقطهای) بین بردار کوئری شما و تکتک بردارهای ذخیرهشده را با استفاده از الگوریتمهای ANN محاسبه میکند تا مجبور به بررسی همهی آنها نباشد.
تمرینها
-
فاصلههای L2 ،L1 و L-بینهایت را بین دو نقطهی (1, 2, 3) و (4, 0, 6) محاسبه کنید. بررسی کنید که رابطهی برای هر جفت نقطه همواره برقرار است. اثبات کنید که چرا این ترتیب همیشه تضمینشده است.
-
دو بردار بسازید که شباهت کسینوسی بالایی دارند (بیشتر از 0.9) اما فاصلهی L2 آنها زیاد است (بیشتر از 10). به شکل هندسی توضیح دهید چه اتفاقی میافتد. سپس دو بردار بسازید که شباهت کسینوسی پایینی دارند (کمتر از 0.3) اما فاصلهی L2 آنها کوچک است (کمتر از 0.5).
-
تابعی پیادهسازی کنید که یک دیتاست و یک نقطهی کوئری را دریافت کند و نزدیکترین همسایه را تحت فاصلههای L2 ،L1، کسینوسی و ماهالانوبیس برگرداند. دیتاستی پیدا کنید که در آن هر چهار متریک بر سر نزدیکترین نقطه با هم اختلافنظر داشته باشند.
-
فاصلهی واسرشتاین را برای دو توزیع [0.5, 0.5, 0, 0] و [0, 0, 0.5, 0.5] بهصورت دستی و با روش CDF محاسبه کنید. سپس این مقدار را برای [0.25, 0.25, 0.25, 0.25] و [0, 0, 0.5, 0.5] حساب کنید. کدام مقدار بزرگتر است و چرا؟
-
الگوریتم MinHash را برای تقریب شباهت جاکارد پیادهسازی کنید. 100 مجموعهی تصادفی بسازید، جاکارد دقیق را برای تمام جفتها حساب کنید و با تقریب MinHash به ازای 50، 100 و 200 تابع هش مقایسه کنید. خطای تقریب را رسم کنید.
راهنماییها
تمرین 1. بردار تفاضل برابر با (-3, 2, -3) است؛ سه نرم این بردار را با توابع l1_norm، l2_norm و linf_norm به دست آورید. برای اثبات، بزرگترین را با مجموع توانهای دوم و مجموع توانهای دوم را با توان دوم مجموع قدرمطلقها مقایسه کنید.
تمرین 2. از آنجا که شباهت کسینوسی طول بردار را نادیده میگیرد، با دو بردار شروع کنید که تقریباً همجهت هستند و طول یکی را بسیار بزرگتر در نظر بگیرید. برای حالت دوم، دو بردار کوتاه نزدیک به مبدأ بسازید که جهتهای متفاوتی دارند و هر دو شرط را با cosine_similarity و l2_distance بررسی کنید.
تمرین 3. تابع find_nearest_neighbor(query, dataset, distance_fn) را به ازای هر یک از توابع l1_distance، l2_distance، cosine_distance و mahalanobis_distance یکبار فراخوانی کنید. تابع demo_different_neighbors دیتاستی را نشان میدهد که این متریکها در آن همنظر نیستند؛ ابتدا آن را بررسی کنید و سپس نقاط را طوری تغییر دهید که پاسخ هر چهار مورد متفاوت شود.
تمرین 4. مجموع تجمعی هر توزیع را بنویسید و سپس قدرمطلق اختلافهای دو مجموع تجمعی را با هم جمع کنید. هر دو نتیجهی محاسبات دستی را با تابع wasserstein_1d(p, q) بررسی کنید و علت بزرگتر بودن مقدار را بر اساس مسافتی که جرم احتمال باید جابهجا شود، توضیح دهید.
تمرین 5. به ازای هر تابع هش، امضای MinHash یک مجموعه برابر با کمترین مقدار هش در بین عناصر آن است. نسبتی از توابع هش که در آنها دو مجموعه به کمینهی یکسانی میرسند، تخمینی از شباهت جاکارد آنها خواهد بود. هر تخمین را با jaccard_similarity مقایسه کنید؛ خطا باید به ازای تابع هش، تقریباً با نرخ کاهش یابد.
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای دقیق فنی |
|---|---|---|
| نرم (Norm) | «بزرگی بردار» | تابعی که یک بردار را به یک اسکالر نامنفی نگاشت میکند و شرایط نامساوی مثلث، تجانس مطلق و شرط صفر بودن فقط برای بردار صفر را برآورده میسازد |
| نرم L1 | «فاصلهی منهتن» | مجموع قدرمطلق مؤلفهها. در بهینهسازی تنکی ایجاد میکند و در برابر دادههای پرت مقاوم است |
| نرم L2 | «فاصلهی اقلیدسی» | جذر مجموع توانهای دوم مؤلفهها. همان فاصلهی خط مستقیم در فضای اقلیدسی |
| نرم Lp | «نرم تعمیمیافته» | ریشهی ام از مجموع توانهای ام قدرمطلق مؤلفهها. L1 و L2 حالتهای خاص آن هستند |
| نرم L-بینهایت | «نرم ماکزیمم» یا «فاصلهی چبیشف» | بزرگترین قدرمطلق بین تمام مؤلفهها. حد نرم Lp زمانی که به سمت بینهایت میل میکند |
| شباهت کسینوسی | «زاویهی بین بردارها» | ضرب نقطهای تقسیم بر بزرگی هر دو بردار. در بازهی 1- تا 1+ قرار دارد و طول بردار را نادیده میگیرد |
| فاصلهی کسینوسی | «1 منهای شباهت کسینوسی» | تبدیل شباهت کسینوسی به یک فاصله. در بازهی 0 تا 2 تغییر میکند |
| ضرب نقطهای | «کسینوسی نرمالنشده» | مجموع حاصلضرب مؤلفهبهمؤلفه. برابر با شباهت کسینوسی ضرب در بزرگی هر دو بردار |
| فاصلهی ماهالانوبیس | «فاصلهی آگاه از همبستگی» | فاصلهی L2 در فضایی که با استفاده از ماتریس کوواریانس دادهها سفیدسازی (سلب همبستگی و نرمالسازی) شده است |
| شباهت جاکارد | «همپوشانی مجموعهها» | اندازهی اشتراک تقسیم بر اندازهی اجتماع. مخصوص مجموعههاست، نه بردارها |
| فاصلهی ویرایشی | «فاصلهی لِوِناشتاین» | حداقل تعداد درج، حذف و جایگزینی برای تبدیل یک رشته به رشتهای دیگر |
| دیورژانس KL | «فاصلهی بین توزیعها» | یک فاصلهی واقعی نیست (نامتقارن است). تعداد بیتهای اضافی ناشی از کدگذاری با استفاده از را میسنجد |
| فاصلهی واسرشتاین | «فاصلهی خاکبردار» | حداقل کار لازم برای انتقال جرم از یک توزیع به توزیع دیگر. یک متریک واقعی است |
| نزدیکترین همسایهی تقریبی | «جستجوی ANN» | الگوریتمهایی (مانند HNSW ،LSH و IVF) که نقاط تقریباً نزدیک را بسیار سریعتر از جستجوی دقیق پیدا میکنند |
| الگوریتم HNSW | «الگوریتم پایگاه دادهی برداری» | گراف دنیای کوچک ناوبر سلسلهمراتبی. گرافی چندلایه برای جستجوی سریع نزدیکترین همسایههای تقریبی |
| منظمسازی L1 | «لاسو» | افزودن نرم L1 وزنها به تابع زیان. وزنها را دقیقاً به سمت صفر push میکند (تنکی) |
| منظمسازی L2 | «ریج» یا «کاهش وزن (weight decay)» | افزودن مجذور نرم L2 وزنها به تابع زیان. وزنها را بدون صفر کردن کامل، به سمت صفر کوچک میکند |
| الاستیک نت (Elastic Net) | «L1 + L2» | ترکیبی از منظمسازیهای L1 و L2. با گروههای ویژگی همبسته بهتر از هر یک بهتنهایی کار میکند |
برای مطالعهی بیشتر
- FAISS: A Library for Efficient Similarity Search - کتابخانهی توسعهدادهشده توسط Meta برای جستجوی ANN در مقیاس میلیارد
- Wasserstein GAN (Arjovsky et al., 2017) - مقالهای که مفهوم فاصلهی خاکبردار را وارد شبکههای GAN کرد
- Locality-Sensitive Hashing (Indyk & Motwani, 1998) - الگوریتم بنیادی برای جستجوی تقریبی نزدیکترین همسایه
- Efficient Estimation of Word Representations (Mikolov et al., 2013) - مقالهی Word2Vec؛ جایی که شباهت کسینوسی به متریک پیشفرض امبدینگها تبدیل شد
- sklearn.neighbors documentation - راهنمای کاربردی متریکهای فاصله و الگوریتمهای همسایگی در scikit-learn