
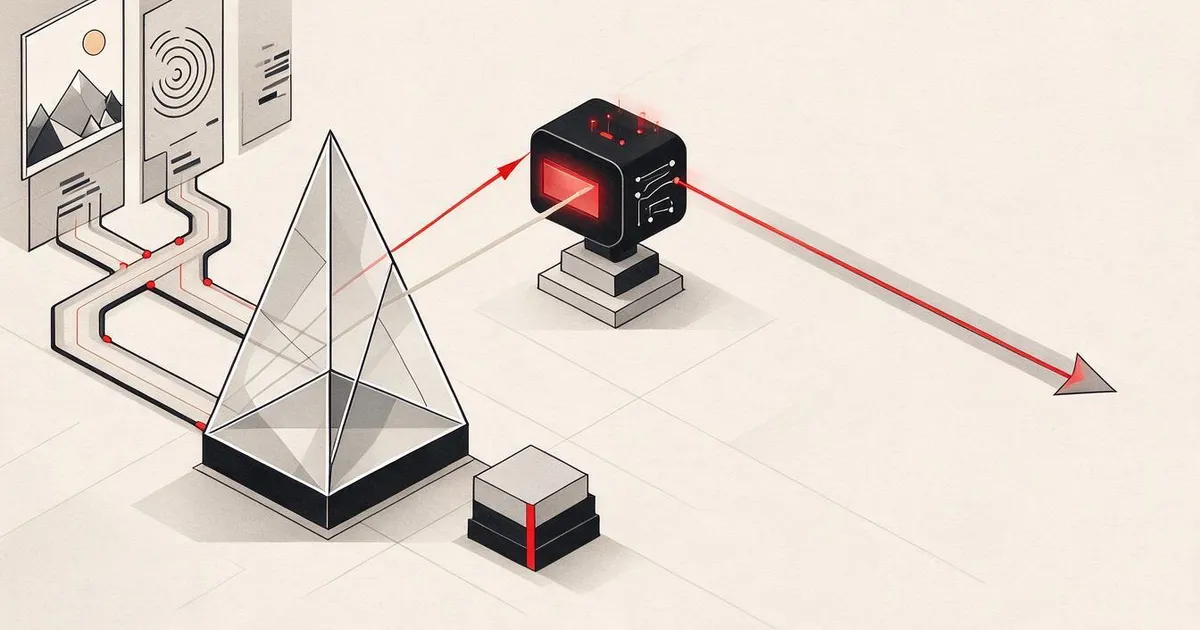
مدلهای هوش مصنوعی چندوجهی همواره با یک ناسازگاری بنیادی دستبهگریبان بودهاند: فهم عمیق معنایی تصویر نیازمند نمایه و امبدینگهای انتزاعی است، در حالی که تولید دقیق تصویر به کدهای متراکم پیکسلی با قابلیت بازسازی تکیه دارد. تلاش برای ادغام این دو ماهیت درون یک انکودر واحد معمولاً به افت کیفیت یکی از دو کارکرد منجر میشود.
معماری Janus-Pro با جدا کردن مسیر انکودرها و متصل نگهداشتن بدنهی ترنسفورمر، این چالش را حل میکند. شناخت این ساختار به مهندسان و پژوهشگران یاد میدهد چگونه بدون تحمیل هزینههای سنگین بازآموزی مدلهای جداگانه، یک سیستم ترکیبی قدرتمند برای همزمان فهمیدن و خلق کردن تصویر پایهریزی کنند.
مدلهای چندوجهی یکپارچه (unified multimodal models) با یک تضاد اجتنابناپذیر روبهرو هستند. درک تصویر به ویژگیهای معنایی نیاز دارد؛ یعنی بردارهای خروجی SigLIP یا DINOv2 که سرشار از اطلاعات سطح بالا و مفهومیاند. در مقابل، تولید تصویر به کدهایی نیاز دارد که بازسازیپذیری بالایی داشته باشند؛ یعنی توکنهای VQ که بتوانند دوباره به پیکسلهایی شفاف و دقیق تبدیل شوند. گنجاندن هر دو هدف در قالب یک انکودر واحد ممکن نیست. مدلهای Janus (شرکت DeepSeek، اکتبر 2024) و Janus-Pro (ژانویه 2025) راهحل را در کنار گذاشتن این تلاش بیهوده میدانند: انکودرها را از هم جدا کنید. بدنهی ترنسفورمر بین وظایف مختلف مشترک بماند، اما مسیر درک تصویر از SigLIP و مسیر تولید تصویر از یک توکنایزر VQ عبور کند. مدل Janus-Pro با 7B پارامتر در بنچمارک GenEval از DALL-E 3 پیشی میگیرد و در MMMU به پای LLaVA میرسد. در این درس بررسی میکنیم چرا استفاده از دو انکودر جداگانه جواب میدهد، در حالی که راهکار تکانکودری شکست میخورد.
اهداف یادگیری
- توضیح اینکه چرا یک انکودر مشترک و واحد، کیفیت درک یا کیفیت تولید تصویر را فدا میکند.
- شرح نحوهی مسیریابی در Janus-Pro: ویژگیهای SigLIP در سمت ورودی برای درک تصویر، و توکنهای VQ هم در ورودی و هم در خروجی برای تولید تصویر.
- بررسی روند مقیاسپذیری ترکیب دادهها (data-mix scaling) که باعث موفقیت Janus-Pro شد، در حالی که نسخهی اولیهی Janus ناکام مانده بود.
- مقایسهی معماریهای تفکیکشده (Decoupled مثل Janus-Pro)، پیوسته و جفتشده (Coupled-continuous مثل Transfusion) و گسسته و جفتشده (Coupled-discrete مثل Show-o).
صورت مسئله
مدلهای یکپارچه از یک بدنهی ترنسفورمر مشترک برای درک و تولید تصویر استفاده میکنند. تلاشهای پیشین (مانند Chameleon، Show-o و Transfusion) همگی برای هر دو مسیر از یک توکنایزر بصری واحد بهره میبردند. چنین توکنایزری ناچار به سازش است:
- بهینهسازی برای بازسازی (تولید تصویر): مدل VQ-VAE جزئیات ریز پیکسلی را ثبت میکند، اما توکنهایی با انسجام معنایی ضعیف تحویل میدهد.
- بهینهسازی برای درک معنایی (فهم تصویر): امبدینگهای SigLIP تصاویر «گربه» را در نزدیکی توکنهای متنی «گربه» دستهبندی میکنند، اما امکان بازسازی باکیفیت تصویر از روی آنها وجود ندارد.
مدلهای Show-o و Transfusion تاوان این سازش را با افت محسوس کیفیت در یکی از این دو جهت میپردازند. پرسش Janus-Pro این است: وقتی دو وظیفه نیازهای متفاوتی دارند، چه اصراری بر استفاده از یک توکنایزر واحد است؟
مفاهیم کلیدی
انکودینگ بصری تفکیکشده
معماری Janus-Pro دو انکودر مجزا را به کار میگیرد:
- مسیر درک تصویر: تصویر ورودی ← SigLIP-SO400m ← پرسپترون دولایهای (2-layer MLP) ← بدنهی ترنسفورمر.
- مسیر تولید تصویر: تصویر ورودی (در صورت شرطیسازی روی یک تصویر موجود) ← توکنایزر VQ ← شناسههای توکن (Token IDs) ← بدنهی ترنسفورمر.
- تولید خروجی: توکنهای تصویر پیشبینیشده توسط ترنسفورمر ← دکودر VQ ← پیکسلها.
بدنهی ترنسفورمر کاملاً مشترک است. تمام بخشهای پیش از ورود به بدنه و پس از خروج از آن، به وظیفهی مربوطه اختصاص دارند.
ابهامزدایی از ورودیها بر اساس فرمت پرامپت انجام میشود: تگ <understand> ورودی را به SigLIP هدایت میکند و تگ <generate> آن را به سمت VQ میفرستد؛ یا اینکه این مسیریابی بهصورت ضمنی از خود وظیفه استنباط میشود.
چرا این رویکرد جواب میدهد؟
تابع زیان (loss) در بخش درک تصویر، ویژگیهای SigLIP را دریافت میکند؛ ویژگیهایی که پیشآموزشهای سبک CLIP آنها را برای شباهت معنایی بهینه کردهاند. به همین دلیل بنچمارکهای ادراکی مدل در مقایسه با Show-o و Transfusion ارتقا مییابند، چون ویژگیهای ورودی برای این وظیفه مناسبترند.
تابع زیان در بخش تولید تصویر، توکنهای VQ را دریافت میکند؛ توکنهایی که یک توکنایزر آنها را اختصاصاً برای بازسازی تصویر تنظیم کرده است. کیفیت تصویر نسبت به Show-o بهتر میشود، چون کدهای VQ تمیز و دقیق به پیکسلها بازسازی میشوند.
بدنهی ترنسفورمر مشترک با دو توزیع ورودی مختلف (SigLIP و VQ) مواجه میشود و کار با هر دو را یاد میگیرد. ادعای اصلی این است: با داده و پارامتر کافی، بدنه توانایی هماهنگ شدن با این جابهجایی را پیدا میکند.
مقیاسپذیری دادهها — Janus در برابر Janus-Pro
نسخهی اولیهی Janus (مقاله arXiv 2410.13848) ایدهی تفکیک را در مقیاسی کوچک (1.3B پارامتر و دادههای محدود) معرفی کرد. در مقابل، Janus-Pro (مقاله arXiv 2501.17811) ابعاد کار را بزرگتر کرد:
- افزایش پارامترها به 7B (در برابر 1.3B).
- افزایش جفتهای تصویر-متن مرحلهی 1 (ترازسازی یا alignment) از 72M به 90M.
- افزایش دادههای مرحلهی 2 (آموزش یکپارچه) از 26M به 72M.
- افزودن 200k نمونهی دستورالعملی تولید تصویر برای مرحلهی 3.
نتیجهی نهایی: مدل Janus-Pro-7B در بنچمارک MMMU به عملکردی همپای LLaVA دست یافت (60.3 در برابر حدود 58) و در GenEval مدل DALL-E 3 را شکست داد (0.80 در برابر 0.67)؛ یک مدل متنباز که در هر دو سمت طیف یکپارچهسازی، کاملاً رقابتی است.
مدل JanusFlow — نسخهی مبتنی بر جریان تصحیحشده
مدل JanusFlow (مقاله arXiv 2411.07975) مسیر تولید VQ را با یک مسیر تولید مبتنی بر جریان تصحیحشده (Rectified Flow بهصورت پیوسته) جایگزین میکند. به این ترتیب، ترکیب به صورت «SigLIP برای درک + جریان تصحیحشده برای تولید» درمیآید. سقف کیفیت حتی از این هم فراتر میرود، اما معماری کلی کماکان مبتنی بر «انکودرهای تفکیکشده و بدنهی مشترک» باقی میماند.
وظیفهی بدنهی مشترک
بدنهی ترنسفورمر یک توالی یکپارچه را پردازش میکند، اما با دو توزیع ورودی متفاوت سر و کار دارد. وظایف این بدنه عبارتند از:
- در درک تصویر: دریافت ویژگیهای SigLIP به همراه توکنهای متنی ← تولید خودبازگشتی توکنهای متنی.
- در تولید تصویر: دریافت توکنهای متنی به همراه (توکنهای اختیاری VQ تصویر) ← تولید خودبازگشتی توکنهای VQ تصویر.
بدنهی مدل در بلوکهای خود هیچ وزن اختصاصی برای هر مدالیته ندارد؛ بلکه همان ترنسفورمر متنی آشنایی است که در Qwen یا Llama میبینید، بهاضافهی دو آداپتور ورودی.
جالب اینجاست که میتوان وزنهای اولیه بدنهی Janus-Pro را از یک مدل زبانی بزرگ پیشآموزشدیده تأمین کرد. Janus-Pro در عمل نیز کار را با وزنهای DeepSeek-MoE-7B آغاز میکند. این تصمیم بسیار کلیدی است: مدل زبانی توان استدلالی بالایی به همراه میآورد که مدلهای یکپارچهی آموزشدیده از صفر بهسختی به آن میرسند.
مقایسه با InternVL-U
مدل InternVL-U (درس 12.10) گام بعدی این مسیر در سال 2026 است که موارد زیر را ترکیب میکند:
- پیشآموزش چندوجهی ذاتی (بر پایهی بکبون InternVL3).
- مسیریابی با انکودرهای تفکیکشده (ورودی SigLIP، خروجی سرهای VQ و دیفیوژن).
- سازوکار یکپارچهی درک، تولید و ویرایش تصویر.
مدل InternVL-U انتخاب معماری Janus-Pro را درون چارچوبی بزرگتر جا داده است. امروزه ایدهی انکودرهای تفکیکشده به انتخاب پیشفرض مدلهای یکپارچه در مقیاس بزرگ تبدیل شده است.
محدودیتها
تفکیک انکودرها پیچیدگی معماری را بالا میبرد: دو توکنایزر برای آموزش، دو مسیر ورودی برای نگهداری، و دو دستهبندی مختلف از الگوهای خطا. برای محصولاتی که به تولید تصویر نیازی ندارند، Janus-Pro مهندسی بیشازحد (over-engineered) به حساب میآید؛ در این موارد یک مدل ادراکی از خانوادهی LLaVA انتخاب کنید.
برای محصولاتی هم که نیازی به درک تصویر ندارند، امکانات Janus-Pro فراتر از نیاز است؛ در این صورت مدلی مانند Stable Diffusion 3 یا Flux را برگزینید.
اما برای محصولاتی که هر دو قابلیت را همزمان میخواهند، Janus-Pro اکنون معماری مرجع متنباز محسوب میشود.
استفاده از ابزارهای واقعی
اسکریپت code/main.py نحوهی مسیریابی در Janus-Pro را شبیهسازی میکند:
- دو انکودر ساختگی: انکودر شبه-SigLIP (تولیدکنندهی بردارهای معنایی 256 بعدی) و انکودر شبه-VQ (تولیدکنندهی کدهای عددی صحیح).
- یک مسیریاب پرامپت که انکودر مناسب را بر اساس تگ وظیفه انتخاب میکند.
- یک بدنهی مشترک (جایگزین نمادین) که توالیهای توکن را بدون در نظر گرفتن اینکه کدام انکودر آنها را ساخته، پردازش میکند.
- جابهجایی برنامهی نمونهگیری وزندار از مرحلهی 1 (ترازسازی) به مرحلهی 3 (تیونینگ دستورالعملی).
مسیرهای انتخابشده را برای 3 سناریو چاپ کنید: پرسش و پاسخ تصویری (image QA)، تبدیل متن به تصویر (T2I) و ویرایش تصویر.
خروجی این درس
حاصل این درس فایل outputs/skill-decoupled-encoder-picker.md است. این راهنما به شما کمک میکند اگر محصولی نیاز به تولید و درک تصویر یکپارچه در سطحی نزدیک به مدلهای مرز فناوری دارد، بر اساس یک توصیهی دقیق برای مقیاس داده، میان Janus-Pro، JanusFlow یا InternVL-U بهترین گزینه را انتخاب کنید.
تمرینها
-
مدل Janus-Pro-7B در بنچمارک GenEval عملکرد بهتری نسبت به DALL-E 3 ثبت میکند. توضیح دهید چرا یک مدل متنباز 7B میتواند در تولید تصویر با مدلهای پیشروی انحصاری رقابت کند، اما در درک و فهم تصویر نه؟
-
یک تابع مسیریاب پیادهسازی کنید: با دریافت متن پرامپت، آن را در یکی از دو دستهی
understandیاgenerateطبقهبندی کند. پرامپتهای مبهم مانند «تصویر را توصیف کن و سپس آن را بکش» را چگونه مدیریت میکنید؟ -
مدل JanusFlow مسیر VQ را با جریان تصحیحشده جایگزین میکند. اکنون خروجی بدنهی ترنسفورمر چیست و چه تغییری در تابع زیان ایجاد میشود؟
-
وظیفهی چهارمی پیشنهاد دهید که معماری Janus-Pro بتواند با افزودن یک انکودر تفکیکشدهی دیگر از پس آن برآید (برای نمونه: بخشبندی تصویر به سبک DINO یا تخمین عمق به سبک MiDaS).
-
بخش 4.2 مقالهی Janus-Pro دربارهی مقیاسپذیری دادهها را بخوانید. کدام مرحله از داده بیشترین سهم را در ارتقای کیفیت T2I نسبت به مدل اولیهی Janus دارد؟
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| انکودینگ تفکیکشده (Decoupled encoding) | «دو انکودر بصری» | توکنایزر یا انکودر مجزا برای هر مسیر: معنایی برای درک تصویر، بازسازیپذیر برای تولید تصویر |
| بدنهی مشترک (Shared body) | «یک ترنسفورمر» | یک ترنسفورمر واحد که خروجی هر دو انکودر را پردازش میکند، بدون وزنهای اختصاصی برای مدالیتهها |
| استفاده از SigLIP برای درک تصویر | «ویژگیهای معنایی» | انکودر تصویر از خانوادهی CLIP که ویژگیهای مفهومی غنی ولی با قابلیت بازسازی پیکسلی ضعیف ارائه میدهد |
| استفاده از VQ برای تولید تصویر | «کدهای بازسازی» | توکنهای کوانتیزهشدهی برداری (Vector-quantized) که بهخوبی و بدون نقص به پیکسلها دیکد میشوند |
| مدل JanusFlow | «نسخهی جریان تصحیحشده» | گونهای از Janus-Pro که به جای VQ از یک سر تولید پیوستهی تطبیق جریان (flow-matching) بهره میبرد |
| تگ مسیریابی (Routing tag) | «تگ وظیفه» | نشانگری در پرامپت (<understand> یا <generate>) که انکودر ورودی مناسب را انتخاب میکند |