
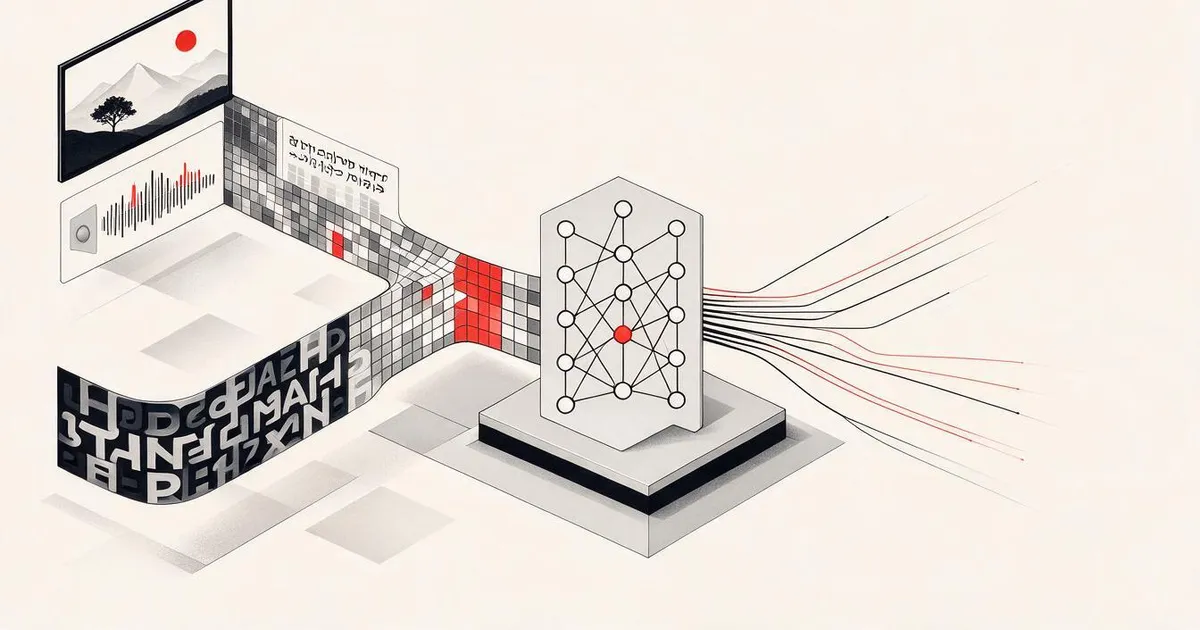
بیشتر مدلهای چندحالتهی رایج مثل LLaVA یا BLIP-2، تصویر و متن را در دو دنیای مجزا نگه میدارند؛ انکودر بینایی ویژگیها را استخراج میکند و پروجکتور آنها را به فضای پنهان مدل زبانی میفرستد. در این ساختار، مدل تنها دریافتکنندهی تصویر است و هرگز نمیتواند مستقیماً خروجی تصویری برگرداند یا ترکیب روان و درهمتنیدهای از تصویر و متن تولید کند.
مدل Chameleon این مرزبندی سنتی را کنار میگذارد. در رویکرد ادغام زودهنگام (Early Fusion)، تصویر به کمک یک VQ-VAE به دنبالهای از توکنهای گسسته در یک دایرهی واژگان مشترک تبدیل میشود؛ بنابراین ترنسفورمر بدون نیاز به سازوکارهای الحاقی، توکنهای تصویر و متن را با یک تابع زیان واحد پیشبینی میکند و امکان تولید آزادانهی محتوای ترکیبی فراهم میشود.
درک این معماری برای مهندسانی که به دنبال ساخت یا مقایسهی سیستمهای نسل بعدی هوش مصنوعی هستند حیاتی است. در این درس، ضمن بررسی دقیق ترفندهای پایداری آموزش نظیر QK-Norm و لایهبندی بهینهی نرمالسازی، یک نمونهی کوچک و قابلردیابی از جریان توکنهای مشترک را پیادهسازی میکنید.
همهی مدلهای بینایی-زبانی (VLM) که تا اینجا دیدهایم، تصویر و متن را از هم جدا نگه میدارند. توکنهای تصویری از یک انکودر بینایی میآیند، وارد پروجکتور (projector) میشوند و سپس درون مدل زبانی بزرگ (LLM) به متن میرسند. دایرهی واژگان بینایی و متن هرگز همپوشانی ندارند. مدل Chameleon (توسعهدادهشده توسط Meta در مه 2024) این پرسش را مطرح کرد: چه میشود اگر این دو واژگان یکی شوند؟ کافی است یک خودکدگذار متغیر با کوانتیزاسیون برداری (VQ-VAE) آموزش دهید که تصویر را به دنبالهای از توکنهای گسسته از یک دایرهی واژگان مشترک تبدیل کند. اکنون هر سند چندحالته به یک دنبالهی واحد تبدیل میشود: توکنهای متنی و تصویری که در هم تنیدهاند، با یک تابع زیان (loss) خودبازگشتی واحد. مزیت جانبی: مدل میتواند خروجیهایی با چندوجهی ترکیبی تولید کند؛ یعنی در یک فراخوانی استنتاج، توکنهای متن و تصویر را یکی در میان ارائه دهد. در این درس، فرضیهی ادغام زودهنگام (early-fusion) را بررسی میکنیم و یک نسخهی ساده از آن را سرتاسر پیاده خواهیم کرد.
اهداف یادگیری
- توضیح دهید چرا دایرهی واژگان مشترک بههمراه تابع زیان واحد، دامنهی توانمندیهای مدل را دگرگون میکند.
- نحوهی توکنایز کردن تصویر توسط VQ-VAE به دنبالهای گسسته و سازگار با هدف پیشبینی توکن بعدی (Next-Token Prediction) در ترنسفورمر را شرح دهید.
- ترفندهای پایداری آموزش در Chameleon را نام ببرید: QK-Norm، جایگذاری دراپاوت (dropout) و ترتیب LayerNorm.
- رویکرد Chameleon را با Q-Former در BLIP-2 مقایسه کنید و بگویید هرکدام چه زمانی انتخاب مناسبی هستند.
صورت مسئله
مدلهای چندحالتهی مبتنی بر آداپتور (مانند LLaVA، BLIP-2 و Qwen-VL) متن و تصویر را دو موجودیت کاملاً متفاوت در نظر میگیرند. یک توکن متنی از embed(text_token) میگذرد؛ درحالیکه تصویر مسیر visual_encoder(image) → projector → ... pseudo_tokens را طی میکند. مدل دو مسیر ورودی دارد که در میانهی راه به هم میپیوندند.
این رویکرد سه پیامد به همراه دارد:
- مدل زبانی فقط میتواند تصاویر را دریافت کند و قادر به تولید آنها نیست؛ خروجی صرفاً متنی است.
- مدیریت اسناد با وجوه چندگانه (پاراگرافها و تصاویر متناوب، مثل یک مقالهی وبلاگی) دشوار و ناخوشایند است؛ یا باید ورودی چندحالته را خارج از مدل پردازش کنید، یا فرایندهای تولید را زنجیروار پشت سر هم بچینید.
- عدم تطابق توزیعی. توکنهای تصویری و متنی در نواحی متفاوتی از فضای پنهان جای میگیرند و همین مسئله باعث ایجاد ناهمترازیهای نامحسوس میشود.
مدل Chameleon این فرضپایه (premise) را رد میکند: تصاویر صرفاً دنبالههایی از توکنهای گسسته از یک واژگان مشترک هستند. مدل را روی اسناد درهمتنیده، با یک تابع زیان و یک دکودر خودبازگشتی واحد آموزش دهید تا بدون هیچ هزینهی اضافی، قابلیت تولید چندحالتهی ترکیبی فعال شود.
مبانی نظری
مدل VQ-VAE در نقش توکنایزر تصویر
توکنایزر در اینجا یک خودکدگذار متغیر با کوانتیزاسیون برداری (Vector-Quantized Variational Autoencoder) است. معماری آن به این صورت است:
- انکودر: ترکیبی از CNN و ViT که تصویر را به یک نقشهی ویژگی (feature map) مکانی تصویر میکند؛ مثلاً 32x32 ویژگی با بُعد 256.
- کتاب کد (Codebook): واژگانی یادگرفتنی از K بردار (Chameleon از 8192 بردار استفاده میکند) که آنها هم بُعد 256 دارند.
- کوانتیزاسیون: برای هر ویژگی مکانی، نزدیکترین بردار کتاب کد بر اساس فاصلهی L2 پیدا میشود. سپس اندیس عددی صحیح آن جایگزین ویژگی پیوسته خواهد شد.
- دکودر: یک CNN که ویژگیهای کوانتیزهشده را دوباره به پیکسل بازمیگرداند.
آموزش: شامل تابع زیان بازسازی VAE بهعلاوهی زیان تعهد (commitment loss) و زیان کتاب کد است. اندیسهای کتاب کد، الفبایی گسسته برای تصاویر میسازند.
در Chameleon، هر تصویر به 1024 = 32 * 32 توکن تبدیل میشود که از واژگانی با 8192 عضو انتخاب شدهاند. شناسههای این تصاویر دقیقاً در همان فضای شناسهی توکنهای متنی BPE قرار میگیرند. توکنایزر واحد Chameleon دارای 65536 مدخل است و این تعداد، کدهای تصویری 8192تایی و توکنهای ویژه (مثل جداکنندههای تصویر) را در بر میگیرد. ترنسفورمر فقط یک دنباله و یک تابع زیان میبیند.
دایرهی واژگان مشترک
واژگان Chameleon توکنهای متنی، تصویری و جداکنندههای وجه داده (modality separators) را ادغام میکند. هر توکن فقط یک شناسه دارد. لایهی امبدینگ (embedding) ورودی، همهی شناسهها را به یک بردار پنهان D-بُعدی میبرد. لایهی تصویر کردنِ خروجی، بردار پنهان را مجدداً به لاجیتها (logits) بازمیگرداند. تابع سافتمکس (softmax) بدون توجه به وجه داده، توکن بعدی را انتخاب میکند.
جداکنندهها اهمیت زیادی دارند: تگهای <image> و </image> دنبالهی توکنهای تصویر را در بر میگیرند. هنگام تولید، اگر مدل <image> را تولید کند، نرمافزار پاییندستی متوجه میشود که 1024 توکن بعدی، اندیسهای VQ هستند و باید برای نمایش پیکسلی به دکودر ارسال شوند.
تولید چندحالتهی ترکیبی
استنتاج همان پیشبینی توکن بعدی در دایرهی واژگان مشترک است. پرامپت (prompt) نمونه: «یک گربه بکش و آن را توصیف کن.» Chameleon چنین خروجی میدهد:
<image> 4821 1029 2891 ... (1024 image tokens) </image>
The cat is orange, sitting on a windowsill...
مدل ترتیب را بهطور خودکار انتخاب میکند؛ ممکن است اول تصویر بعد متن، اول متن بعد تصویر یا بهصورت درهمتنیده باشد. دکودر و تابع زیان در تمام حالات یکسان هستند.
این ساختار را با VLMهای مبتنی بر آداپتور مقایسه کنید که خروجیشان فقط متن است. Chameleon دوباره مسئلهی مدهای خروجی مدل را پیش میکشد.
پایداری آموزش — تکنیکهای QK-Norm، دراپاوت و چینش LayerNorm
آموزش ادغام زودهنگام در مقیاس بزرگ ناپایدار است. مقالهی Chameleon سه ترفند کلیدی را مطرح میکند:
- تکنیک QK-Norm. اعمال لایهی LayerNorm روی بردارهای پرسش (query) و کلید (key) درون اتنشن (attention)، پیش از محاسبهی ضرب داخلی (dot product). این کار جلوی انفجار بزرگیِ لاجیت در لایههای عمیق را میگیرد و در چندین مدل بزرگ پس از 2024 نیز استفاده شده است.
- جایگذاری دراپاوت. اعمال دراپاوت بعد از هر جمعِ پسماند (residual-add)، نه فقط بعد از اتنشن و MLP. وقتی گرادیانهای توکنهای تصویری غلبه میکنند، منظمسازی (regularization) بیشتری لازم است.
- چینش LayerNorm. استفاده از Pre-LN روی شاخهی پسماند (روش استاندارد)، بههمراه یک LN اضافی روی اتصال جهشی (skip connection) آخرین بلوک. این کار جریان گرادیان لایهی آخر را پایدار میکند.
بدون این ترفندها، آموزش مدل 34 میلیارد پارامتری Chameleon در چندین چکپوینت (checkpoint) دچار واگرایی شد؛ اما با اعمال آنها همگرا میشود. دستورالعمل آموزش بهاندازهی خود معماری ارزش دارد.
سقف بازسازی توکنایزر
مدل VQ-VAE اتلافی (lossy) است. با 8192 مدخل کتاب کد و 1024 توکن برای یک تصویر 512x512، معیار PSNR بازسازی در حدود 26 تا 28 دسیبل متوقف میشود. این کیفیت برای ساخت تصاویر قابلتشخیص کافی است، ولی نسبت به مدلهای دیفیوژن در فضای پیوسته (مانند Stable Diffusion 3 با PSNR بالای 32) بهوضوح ضعیفتر عمل میکند.
گلوگاه اصلی همین توکنایزر است. توکنایزرهای بهتر (مثل MAGVIT-v2، IBQ و SBER-MoVQGAN) این سقف را بالاتر میبرند. مدل Emu3 (درس 12.12) صرفاً با تکیه بر یک توکنایزر قویتر، کیفیتی در سطح SDXL ارائه میدهد.
مقایسهی Chameleon با BLIP-2 و LLaVA
مدل Chameleon (ادغام زودهنگام، واژگان مشترک):
- یک تابع زیان، یک دکودر.
- تولید خروجی چندحالتهی ترکیبی.
- سقف کیفیت به توکنایزر وابسته است.
- هزینهبر: نیاز به دکودر VQ-VAE برای هر تصویر تولیدشده در مسیر استنتاج.
مدلهای BLIP-2 و LLaVA (ادغام دیرهنگام، برجهای مجزا):
- دریافت تصویر، خروجی صرفاً متن.
- استفادهی مجدد از مدل زبانی بزرگِ ازپیشآموزشدیده.
- نبود گلوگاه توکنایزر در درک و فهم تصویر.
- ارزان: یک گذر رو به جلو (forward pass) واحد.
انتخاب وابسته به تسک شماست. اگر به تولید تصویر نیاز دارید، به سراغ خانوادهی Chameleon بروید. اگر صرفاً فهم تصویر مدنظر است، مدلهای VLM آداپتوری سادهترند و بخش بیشتری از توان محاسباتی پیشآموزشدیده را استفاده میکنند.
مدلهای Fuyu و AnyGPT
مدل Fuyu (از شرکت Adept، سال 2023) رویکرد مشابهی دارد: انکودر بینایی مجزا را کاملاً حذف میکند، وصلههای خام تصویر را درست مثل توکنها به لایهی پروجکشن ورودی LLM میدهد و توکنایزری ندارد. این روش سادهتر از Chameleon است، اما قابلیت تولید خروجی با واژگان مشترک را از دست میدهد.
مدل AnyGPT (نویسندگان: Zhan و همکاران، 2024) رویکرد Chameleon را به چهار وجه گسترش میدهد: متن، تصویر، گفتار و موسیقی. برای هرکدام از همان ترفند VQ-VAE استفاده میکند و با یک ترنسفورمر مشترک به تولید همهبههمه میرسد؛ جزئیات بیشتر در درس 12.16 بررسی خواهد شد.
استفاده از ابزارهای واقعی
در فایل code/main.py یک مدل اسباببازی ادغام زودهنگام بهصورت سرتاسری پیاده شده است:
- یک کوانتیایزر ساده به سبک VQ-VAE که وصلههای 8x8 را به اندیسهای کتاب کد تبدیل میکند (K=16).
- واژگان مشترک شامل (شناسههای متنی 0 تا 31) + (شناسههای تصویری 32 تا 47) + (جداکنندههای 48 و 49).
- یک دکودر خودبازگشتی ساده (جدول دوتایی یا bigram) که روی کپشنهای ساختگی و دنبالههای توکن تصویر آموزش دیده است.
- حلقهی نمونهبرداری که در پاسخ به پرامپت، توکنهای متن و تصویر را یکی در میان تولید میکند.
ترنسفورمر عمداً در سادهترین حالت (bigram) نگه داشته شده است تا بتوانید جریان سیگنال را از ابتدا تا انتها دنبال کنید.
خروجی این درس
خروجی این درس فایل outputs/skill-tokenizer-vs-adapter-picker.md است. این سند بر اساس مشخصات محصول (صرفاً درک تصویر در برابر درک + تولید، کیفیت تصویر موردنیاز و بودجهی هزینه)، بین رویکرد Chameleon (ادغام زودهنگام) و رویکرد LLaVA (ادغام دیرهنگام) انتخاب میکند و این تصمیم را با قواعد سرانگشتی کمّی توجیه مینماید.
تمرینها
-
مدل Chameleon از K=8192 مدخل کتاب کد و 1024 توکن برای یک تصویر 512x512 استفاده میکند. نسبت فشردهسازی را در مقایسه با یک تصویر 24 بیتی RGB تخمین بزنید. آیا فشردهسازی دارای اتلاف است؟ میزان اتلاف چقدر است؟
-
یک تصویر 4K (رزولوشن 3840x2160) با همان چگالی VQ-VAE چند توکن تصویری تولید میکند؟ آیا مدلی شبیه به Chameleon میتواند یک تصویر 4K را در یک فراخوانی استنتاج تولید کند؟ کدام بخش زودتر دچار مشکل میشود: پنجرهی زمینه (context)، کیفیت توکنایزر، یا کش کلید-مقدار (KV cache)؟
-
قابلیت QK-Norm را در پایتون خالص پیادهسازی کنید. برای بردار پرسش و کلید 64 بُعدی، ضرب داخلی را قبل و بعد از LayerNorm نمایش دهید. چرا کنترل بزرگی در لایههای عمیق اهمیت دارد؟
-
بخش 2.3 مقالهی Chameleon دربارهی پایداری آموزش را بخوانید. حالت شکست دقیقی را که در مدل 34 میلیاردی بدون QK-Norm مشاهده شد، شرح دهید. نشانهی «انفجار نُرم» (norm explosion) چه بود؟
-
دکودر سادهی درس را گسترش دهید تا در پاسخ به پرامپتِ متنی، خروجی چندحالتهی ترکیبی بدهد. اندازهگیری کنید که در یک توزیع دادهی آموزشی شامل 60% اولمتن و 40% اولتصویر، مدل چند درصد مواقع اول تصویر تولید میکند و چند درصد اول متن.
اصطلاحات کلیدی
| اصطلاح | باور عمومی | تعریف فنی دقیق |
|---|---|---|
| ادغام زودهنگام (Early fusion) | «توکنهای یکپارچه» | تبدیل تصاویر به توکنهای گسستهای که از گام نخست در دایرهی واژگان ترنسفورمر مشترک هستند. |
| خودکدگذار VQ-VAE | «توکنایزر تصویر» | ترکیب CNN + ViT + کتاب کد که تصاویر را به اندیسهای صحیح قابل پیشبینی برای ترنسفورمر تبدیل میکند. |
| دایرهی واژگان مشترک (Shared vocabulary) | «یک دیکشنری واحد» | فضای شناسهی توکن واحد که شامل متن، تصویر و جداکنندههای وجه داده است. |
| تکنیک QK-Norm | «پایدارکنندهی اتنشن» | اعمال LayerNorm روی پرسش و کلید قبل از ضرب داخلی آنها برای جلوگیری از انفجار نُرم بردارها. |
| تولید چندحالتهی ترکیبی (Mixed-modality generation) | «خروجی متن + تصویر» | فرایند استنتاجی که بهطور خودکار توکنهای متن و تصویر را در یک گذر و بهصورت درهمتنیده تولید میکند. |
| اندازهی کتاب کد (Codebook size) | «K مدخل» | تعداد بردارهای گسستهای که VQ-VAE میتواند ویژگیها را به آنها کوانتیزه کند؛ مبادلهای بین فشردگی و وفاداری به اصل تصویر. |
| سقف توکنایزر (Tokenizer ceiling) | «محدودیت بازسازی» | بالاترین نسبت سیگنال به نویز (PSNR) با دیکد کردن توکنهای VQ؛ این معیار کیفیت تصویر مدل را محدود میکند. |