
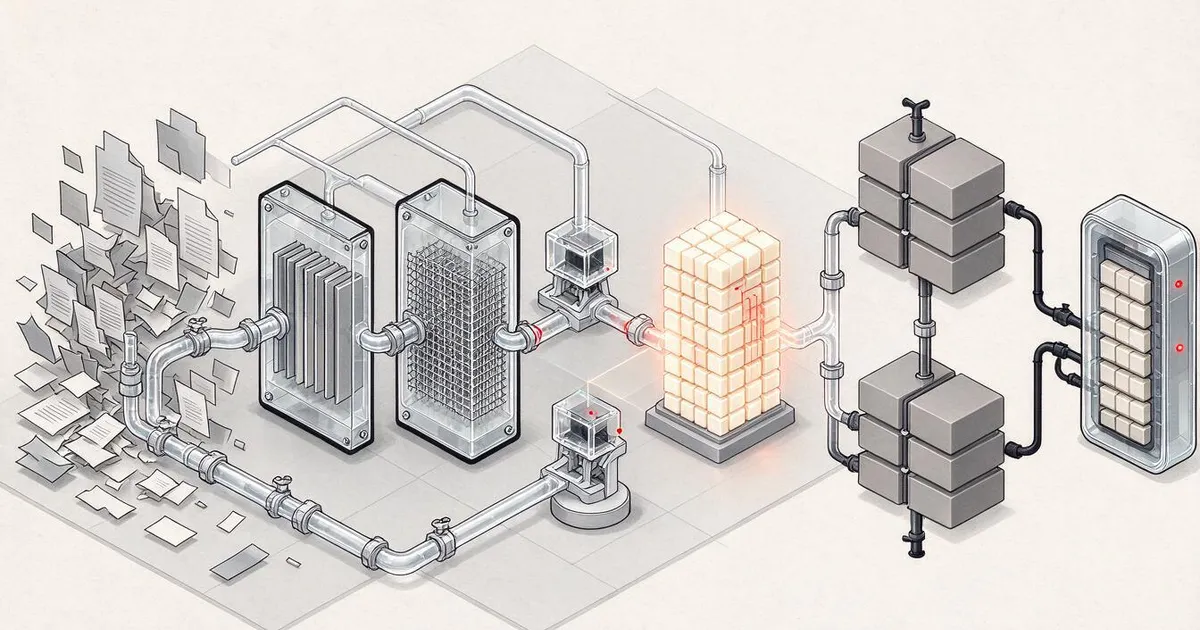
کیفیت یک مدل زبانی بازتاب مستقیم دادههایی است که دریافت میکند. بیشتر مهندسان تصور میکنند پیشرفت مدلهای پیشرو حاصل معماری شبکه است، اما واقعیت این است که تفاوتهای بنیادین مدلهایی چون Llama 3 و GPT-3 از پالایش، کیفیت و نحوهی آمادهسازی تریلیونها توکن متنی سرچشمه میگیرد. بدون یک خط پردازش و پالایش استاندارد، حتی قویترین معماریها نیز خروجیهای بیکیفیت و غیرقابل اعتمادی تولید میکنند.
در این درس یاد میگیرید که چطور حجم عظیمی از دادههای خام وب را پالایش کنید، دادههای مشابه و تکراری را با الگوریتمهای MinHash و LSH کنار بگذارید و با بستهبندی مناسب دنبالهها (Sequence Packing) بازدهی محاسباتی کارتهای گرافیک را به حداکثر برسانید. اجرای روان این مراحل مانع از هدررفت منابع محاسباتی کمیاب در زمان آموزش میشود.
اگر برای آزمایشهای خود بستهها یا ابزارهایی مانند Hugging Face Datasets را دریافت میکنید، در نظر داشته باشید که ارتباط با مخازن خارجی مانند PyPI یا Hugging Face گاهی ناپایدار است و استفاده از میرورهای داخلی میتواند بارگذاری کتابخانهها را تسهیل کند. علاوه بر این، کدهای پایه و پیادهسازی گامبهگام این درس به صورت سبک روی پردازندهی محلی نیز اجراپذیر هستند.
مدل مانند آینه است؛ هر دادهای به خوردش بدهید، همان را بازمیتاباند. زباله تحویلش بدهید، زباله را با فصاحتِ تمام پس میدهد.
اهداف یادگیری
- ساخت یک پایپلاین داده استریمینگ (streaming data pipeline) که بدون بارگذاری کل داده در حافظه، ترابایتها متن را توکنایز، تکهتکه، بُر (shuffle) و دستهبندی (batch) کند.
- پیادهسازی فیلترهای کیفیت داده (حذف تکرار، تشخیص زبان و فیلتر محتوا) که در پایپلاینهای واقعی پیشآموزش (pre-training) به کار میروند.
- ایجاد دنبالههای آموزشی با طول ثابت، همراه با ماسک اتنشن (attention mask) استاندارد و مدیریت صحیح مرز بین اسناد.
- پروفایل گرفتن از نرخ پردازش (throughput) پایپلاین برای اطمینان از اینکه دیتالودر (dataloader) پابهپای سرعت آموزش GPU پیش میرود.
صورت مسئله
توکنایزر آماده است؛ حالا داده میخواهید.
نه یک دیتاست معمولی و نه یک فایل CSV؛ بلکه ترابایتها متن: پاکسازیشده، بدون تکرار، پالایششده از نظر کیفی، تبدیلشده به دنبالههایی با طول ثابت، و در نهایت دستههای تصادفیشدهای که آنقدر سریع تحویل داده شوند که کلاستر 8 کارت گرافیک شما هرگز معطل بچ بعدی نماند.
بیشتر افراد فکر میکنند آموزش مدلهای زبانی بزرگ (LLM) صرفاً به معماری مدل وابسته است. ابداً اینطور نیست. مدل Llama 3 با 15.6 تریلیون توکن آموزش دید؛ GPT-3 با 300 میلیارد توکن و DeepSeek-V2 با 8.1 تریلیون توکن. معماری هر سه تقریباً یکسان است: بلوکهای پشتهای ترنسفورمر به همراه لایههای اتنشن و پیشخور (feedforward). تفاوت چشمگیر کیفیت خروجی، بیش از هر چیز حاصل تفاوت در دادههاست.
مقالهی چینچیلا (Chinchilla) از DeepMind این موضوع را دقیق فرمولهبندی کرد: برای یک بودجهی محاسباتی معین، نسبت بهینهای میان تعداد پارامترهای مدل و توکنهای آموزشی وجود دارد. چینچیلا نشان داد بیشتر مدلهای سال 2022 بهشدت کمتر از حد بهینه آموزش دیده بودند (undertrained)؛ یعنی نسبت به دادهای که دیدهاند، پارامترهای بسیار زیادی داشتند. یک مدل 70 میلیارد پارامتری که با 1.4 تریلیون توکن آموزش دید (بهینه از نظر چینچیلا)، مدلی 280 میلیارد پارامتری را که تنها با 300 میلیارد توکن آموزش دیده بود (Gopher)، پشت سر گذاشت.
این پایپلاین دادهی شماست که تعیین میکند مدل «زبان» یاد بگیرد یا صرفاً «نوفه» و آشغال جذب کند.
مفاهیم پایه
منشأ دادهها کجاست؟
هر مدل زبانی بزرگ روی ترکیبی از منابع مختلف آموزش میبیند. ترکیب دقیق این منابع برای بیشتر آزمایشگاهها رازی سربهمهر است، اما شناخت دستهبندیهای کلی امکانپذیر است.
| منبع | حجم | کیفیت | استفادهشده توسط |
|---|---|---|---|
| Common Crawl | حدود 250 ترابایت خام | پایین (نیازمند فیلتر سنگین) | GPT-3، Llama و بیشتر مدلهای متنباز |
| Wikipedia | حدود 20 گیگابایت | بالا | تمام مدلهای زبانی بزرگ شاخص |
| کدهای GitHub | حدود 1+ ترابایت | متوسط (پر از کد تکراری و بلااستفاده) | StarCoder، CodeLlama، DeepSeek-Coder |
| کتابها (BookCorpus، Pile) | حدود 100 گیگابایت | بالا | GPT-2، GPT-3 و مدلهای اولیه |
| مقالات دانشگاهی (arXiv، S2ORC) | حدود 100 گیگابایت | بالا برای STEM | Llama، Galactica |
| StackOverflow و Reddit | حدود 100 گیگابایت | متوسط | Llama، Falcon |
| وب پالایششده (C4، RefinedWeb) | حدود 5 ترابایت | متوسط رو به بالا (پیشفیلتر شده) | T5، Falcon |
تیم Llama 3 ترکیب دادههای خود را اعلام کرد: تقریباً 50% دادههای وب، 25% کد، 13% کتاب و مقالات دانشگاهی، 8% دادههای ریاضی و 4% متون وب چندزبانه. در مجموع 15.6 تریلیون توکن از منابعی به دست آمد که حجم متون خام آنها بیش از 5 ترابایت بود.
نسبت ترکیب این منابع به اندازهی حجم کل آنها اهمیت دارد. وبِ بیش از حد، مدل را به طوطیِ رددیت تبدیل میکند. کدِ ناکافی، توانایی برنامهنویسی را از آن میگیرد. ریاضیِ اندک، پای استدلالش را لنگ میکند. تنظیم درست این معجون از سختترین مراحل آموزش یک LLM است؛ هیچ فرمول ثابتی ندارد و محتاج آزمون و ارزیابی مداوم است.
پاکسازی دادهها
دادهی خام وب بسیار آلوده است. یک دامپ معمولی از Common Crawl پر است از:
- تگهای HTML و کدهای JavaScript
- متنهای تکراری قالب (boilerplate) در هدرها، فوترها و منوهای ناوبری
- صفحات تکراری (کاملاً یکسان یا تقریباً یکسان)
- اسپمهای تولیدشده توسط ماشین
- اطلاعات هویتی و محرمانه اشخاص (PII)
- متون بیکیفیت (فهرست کلمات کلیدی، اسپمهای سئو)
- محتوای غیرمتنی که به شکل متن انکود شده است
تمیز کردن این موارد اختیاری نیست؛ مرز میان مدلی است که پاراگرافهای منسجم تولید میکند و مدلی که تگهای HTML را قاتی فهرست محصولات پس میدهد.
هر مرحله دستهای از نوفهها را حذف میکند:
حذف کدهای HTML: همهی نشانهگذاریها را پاک کنید و فقط متن قابل مشاهده را نگه دارید. کتابخانههایی مانند trafilatura یا readability محتوای اصلی مقاله را استخراج کرده و بخشهای ناوبری، تبلیغات و حاشیهها را دور میاندازند.
تشخیص زبان: از مدل تشخیص زبان fastText (فایل lid.176.bin) برای ردهبندی هر سند استفاده کنید. متون را روی زبانهای هدف فیلتر کنید. سندی که با ضریب اطمینان کمتر از 0.8 به عنوان انگلیسی شناخته شود، احتمالاً انگلیسی تمیزی نیست.
فیلتر کیفی: اینجا ماجرا جذاب میشود. دیتاست RefinedWeb (پشتوانهی مدل Falcon) از فیلتری بر پایهی پرپلکسیتی (perplexity) بهره میبرد: ابتدا یک مدل زبانی کوچک روی ویکیپدیا آموزش میبیند و سپس به هر سند امتیازی اختصاص داده میشود. پرپلکسیتیِ بالا یعنی متن شباهتی به نوشتههای ویکیپدیا ندارد؛ احتمالاً اسپم، ردیف کلمات کلیدی یا متنی است که ماشین سرهم کرده است. اسنادی که پرپلکسیتی آنها بالاتر از آستانه باشد، حذف میشوند.
حذف تکرار (Deduplication): مؤثرترین گام در پاکسازی داده. Common Crawl تعداد بیشماری صفحات تکراری دارد؛ مثل سلب مسئولیتهای حقوقی، هشدارهای کوکی و شرایط استفاده. آموزش روی دادههای تکراری توان پردازشی را هدر میدهد و باعث میشود مدل جملات خاصی را عیناً حفظ کند و طوطیوار پس بدهد.
حذف اطلاعات هویتی اشخاص (PII): نامها، آدرسهای ایمیل، شمارههای تلفن و شمارههای تامین اجتماعی. برای دادههای ساختاریافته از رجکس (Regex) و برای تشخیص نامها در بستر متن از مدلهای NER استفاده میشود.
حذف تکرار با MinHash
حذف موارد کاملاً یکسان ساده است: از هر سند هش میگیرید و تکراریها را پاک میکنید. اما چالش اصلی، اسناد «تقریباً یکسان» (near-duplicates) هستند؛ مثلاً دو نسخه از یک خبر که تنها بنرهای تبلیغاتی متفاوتی در حاشیهی آنها قرار دارد. 95% محتوا یکی است، اما بایتبهبایت با هم فرق دارند.
ترکیب الگوریتمهای MinHash و هشینگ حساس به مکان (Locality-Sensitive Hashing یا LSH) این گره را بهصرفه باز میکند.
ایده به این شکل است:
-
قطعهبندی (Shingling): تبدیل هر سند به مجموعهای از انگرامها (مثلاً 5-گرامهایی از کلمات یا نویسهها). برای نمونه، عبارت «the quick brown fox» با قطعات 3 کلمهای به {"the quick brown", "quick brown fox"} تبدیل میشود.
-
الگوریتم MinHash: برای مجموعهی قطعات هر سند، تعداد k مقدار هش محاسبه میشود. هر مقدار، کمینهی هش در میان تمام قطعات تحت یک تابع هش متفاوت است. این کار یک «امضا» با اندازهی ثابت میسازد که شباهت ژاکارد (Jaccard similarity) بین هر دو سند را تخمین میزند.
-
الگوریتم LSH: دستهبندی اسناد در باکتها (bucket) بر اساس بخشهایی از امضای MinHash آنها. اسنادی که در یک باکت قرار میگیرند، نامزدِ تشابه بالا به حساب میآیند. با این ترفند دیگر نیازی به مقایسهی دوبهدوی تمام اسناد نیست و فقط جفتهای نامزد مقایسه میشوند.
-
اعتبارسنجی: برای هر جفت نامزد، شباهت دقیق ژاکارد را محاسبه کنید. اگر این شباهت از یک آستانه (معمولاً 0.8) فراتر رفت، یکی از آنها را حذف کنید.
تیم Llama گزارش داد که تقریباً 38% از دادههای وبِ خود را با فرآیند حذف تکرار دور ریخته است. عدد ناچیزی نیست؛ بیش از یکسوم دادههای Common Crawl محتوای تکراری یا تقریباً تکراری هستند.
بستهبندی دنبالهها (Sequence Packing)
مدل منتظر دنبالههای ورودی با طول ثابت است؛ درحالیکه اسناد طولهای متغیری دارند. برخی 50 توکن هستند و برخی 50,000 توکن.
روش ابتدایی: پدینگ (حاشیهگذاری) همهی اسناد تا سقف حداکثر طول دنباله. این کار بخش زیادی از توان محاسباتی را صرف توکنهای پدینگی میکند که هیچ نقشی در یادگیری ندارند.
روش بهتر: بستهبندی و جا دادن چندین سند در قالب یک دنبالهی واحد، به طوری که با توکنهای پایان سند (EOS) از یکدیگر جدا شوند. یک دنبالهی 2048 توکنی ممکن است سه سند کوتاه را به همراه توکنهای [EOS] بین آنها در بر بگیرد.
ماسک اتنشن در این حالت باید دقیق تنظیم شود. توکنهای سند A نباید در داخل یک دنبالهی فشرده، به توکنهای سند B اتنشن داشته باشند. رسیدن به این مقصود به یک ماسک اتنشن قطری-بلوکی (block-diagonal) نیاز دارد.
اسناد طولانی معمولاً کوتاه (truncate) میشوند یا در مرز دنبالهها به چند بخش میشکنند. محل این برش حائز اهمیت است؛ بریدن سند در وسط یک جمله، مدل را با افکار نیمهکاره مواجه میکند. برخی پایپلاینها تا جای ممکن شکستن متن را با مرز پاراگرافها یا جملات همتراز میکنند.
قانون مقیاسپذیری چینچیلا (Chinchilla Scaling Law)
برای یک بودجهی محاسباتی ثابت (بر حسب FLOPs)، اندازهی بهینهی مدل و حجم دیتای آموزشی از این فرمول پیروی میکنند:
در عمل این یعنی باید اندازه مدل و تعداد توکنهای آموزشی را تقریباً با نسبت برابری مقیاس دهید. مدلی که 10 برابر پارامتر بیشتری دارد، به تقریباً 10 برابر توکن آموزشی بیشتر نیاز دارد تا به همان میزان تابع زیان (loss) برسد.
| مدل | تعداد پارامترها | توکنهای آموزش | بهینه از نظر چینچیلا؟ |
|---|---|---|---|
| GPT-3 | 175B | 300B | خیر (3 تا 4 برابر کمتر از حد بهینه) |
| Chinchilla | 70B | 1.4T | بله (طبق طراحی) |
| Llama 2 | 70B | 2T | آموزش بیش از حد بهینه (عامدانه) |
| Llama 3 | 70B | 15T | بهشدت فراتر از حد بهینه |
مدل Llama 3 آگاهانه از قانون چینچیلا تخطی کرد. متا متوجه شد که آموزش بیش از حد (overtraining) مدل روی دادههای بیشتر—بسیار فراتر از نسبت بهینه از نظر توان پردازشی—مدلهای کارآمدتری را در مرحلهی استنتاج (inference) خلق میکند. هزینهی پردازش سنگین مرحله آموزش فقط یک بار پرداخت میشود، اما ارائهی یک مدل کوچکتر در مرحلهی استنتاج تا ابد کمهزینهتر خواهد بود. این رویکرد را گاهی مقیاسپذیریِ «بهینه از نظر استنتاج» مینامند که از سال 2024 به استاندارد اصلی این صنعت بدل شده است.
پیادهسازی از صفر
گام 1: پاکسازی متن
حذف کدهای HTML، یکدستسازی فاصلهها و حذف محتوای غیرمتنی. ما از متون مالکیت عمومی (Project Gutenberg) به عنوان مجموعهمتن (corpus) کوچک خود استفاده میکنیم.
import re

def clean_text(text):
    text = re.sub(r"<[^>]+>", "", text)
    text = re.sub(r"http\S+", "", text)
    text = re.sub(r"[^\x20-\x7E\n]", "", text)
    text = re.sub(r"\n{3,}", "\n\n", text)
    text = re.sub(r" {2,}", " ", text)
    return text.strip()

def quality_filter(text, min_words=50, max_ratio_caps=0.3, max_ratio_special=0.1):
    words = text.split()
    if len(words) < min_words:
        return False
    caps_ratio = sum(1 for w in words if w.isupper()) / len(words)
    if caps_ratio > max_ratio_caps:
        return False
    special_chars = sum(1 for c in text if not c.isalnum() and not c.isspace())
    if special_chars / max(len(text), 1) > max_ratio_special:
        return False
    return True
فیلتر کیفی، اسپمهای سئو (متنهایی که یکسره با حروف بزرگ نوشته شدهاند)، نوفههای ماشینی (نسبت بالای کاراکترهای خاص) و صفحات ناقص (متون بسیار کوتاه) را به دام میاندازد. همین سه بررسی ساده، بارِ زبالهی وب را به شکل چشمگیری کاهش میدهند.
گام 2: حذف تکرار با MinHash
پیادهسازی MinHash از صفر، بدون نیاز به هیچ کتابخانهی جانبی و صرفاً با hashlib.
import hashlib
from collections import defaultdict

def get_shingles(text, k=5):
    words = text.lower().split()
    if len(words) < k:
        return set()
    return {" ".join(words[i:i+k]) for i in range(len(words) - k + 1)}

def minhash_signature(shingles, num_hashes=128):
    signature = []
    for i in range(num_hashes):
        min_hash = float("inf")
        for shingle in shingles:
            h = int(hashlib.sha256(f"{i}:{shingle}".encode()).hexdigest(), 16)
            min_hash = min(min_hash, h)
        signature.append(min_hash)
    return signature

def lsh_buckets(signature, bands=16):
    rows_per_band = len(signature) // bands
    buckets = []
    for b in range(bands):
        start = b * rows_per_band
        band_data = tuple(signature[start:start + rows_per_band])
        bucket_hash = hashlib.md5(str(band_data).encode()).hexdigest()
        buckets.append((b, bucket_hash))
    return buckets

def deduplicate(documents, threshold=0.8, num_hashes=128, bands=16):
    signatures = []
    shingle_sets = []
    for doc in documents:
        shingles = get_shingles(doc)
        shingle_sets.append(shingles)
        signatures.append(minhash_signature(shingles, num_hashes))

    bucket_map = defaultdict(list)
    for doc_idx, sig in enumerate(signatures):
        for band_id, bucket_hash in lsh_buckets(sig, bands):
            bucket_map[(band_id, bucket_hash)].append(doc_idx)

    duplicate_pairs = set()
    for bucket_docs in bucket_map.values():
        if len(bucket_docs) < 2:
            continue
        for i in range(len(bucket_docs)):
            for j in range(i + 1, len(bucket_docs)):
                duplicate_pairs.add((bucket_docs[i], bucket_docs[j]))

    removed = set()
    for i, j in duplicate_pairs:
        if i in removed or j in removed:
            continue
        s1, s2 = shingle_sets[i], shingle_sets[j]
        if not s1 or not s2:
            continue
        jaccard = len(s1 & s2) / len(s1 | s2)
        if jaccard >= threshold:
            removed.add(j)

    return [doc for idx, doc in enumerate(documents) if idx not in removed], len(removed)
پارامترهای num_hashes=128 و bands=16 توازن دقت و پوشش (precision-recall tradeoff) را کنترل میکنند. تعداد بیشترِ هشها، تخمین دقیقتری از شباهت به دست میدهد. باندهای (bands) بیشتر باعث افزایش بازخوانی (صید موارد تکراری بیشتر) به قیمت خطاهای مثبت کاذبِ افزونتر میشود. این مقادیر برای متون معمول وب عملکرد مناسبی دارند.
گام 3: توکنایز و بستهبندی دنبالهها
متنهای پاکشده و بدون تکرار را بردارید، آنها را توکنایز کنید و برای فرآیند آموزش در قالب دنبالههایی با طول ثابت بستهبندی نمایید.
def tokenize_corpus(documents, tokenizer):
    all_tokens = []
    for doc in documents:
        tokens = tokenizer.encode(doc)
        all_tokens.extend(tokens)
        all_tokens.append(tokenizer.eos_id)
    return all_tokens

def pack_sequences(token_ids, seq_length, pad_id=0):
    sequences = []
    attention_masks = []
    for i in range(0, len(token_ids), seq_length):
        seq = token_ids[i:i + seq_length]
        mask = [1] * len(seq)
        if len(seq) < seq_length:
            pad_count = seq_length - len(seq)
            seq = seq + [pad_id] * pad_count
            mask = mask + [0] * pad_count
        sequences.append(seq)
        attention_masks.append(mask)
    return sequences, attention_masks
گام 4: دیتالودر برای آموزش
ارائهی دستههای تصادفی از دنبالههای بستهبندیشده؛ خوراک اصلیِ حلقهی آموزش.
import random

class PreTrainingDataLoader:
    def __init__(self, sequences, attention_masks, batch_size, shuffle=True):
        self.sequences = sequences
        self.attention_masks = attention_masks
        self.batch_size = batch_size
        self.shuffle = shuffle

    def __len__(self):
        return (len(self.sequences) + self.batch_size - 1) // self.batch_size

    def __iter__(self):
        indices = list(range(len(self.sequences)))
        if self.shuffle:
            random.shuffle(indices)
        for start in range(0, len(indices), self.batch_size):
            batch_idx = indices[start:start + self.batch_size]
            batch_seqs = [self.sequences[i] for i in batch_idx]
            batch_masks = [self.attention_masks[i] for i in batch_idx]
            yield batch_seqs, batch_masks
گام 5: آمارهای دیتاست
محاسبهی شاخصهای کلیدی: مجموع توکنها، توکنهای یکتا، نسبت فشردهسازی و توزیع طول اسناد.
from collections import Counter

def compute_statistics(documents, token_ids, sequences, tokenizer_vocab_size):
    total_chars = sum(len(d) for d in documents)
    total_tokens = len(token_ids)
    unique_tokens = len(set(token_ids))
    compression_ratio = total_chars / total_tokens

    doc_lengths = [len(d.split()) for d in documents]
    avg_doc_length = sum(doc_lengths) / max(len(doc_lengths), 1)
    max_doc_length = max(doc_lengths) if doc_lengths else 0
    min_doc_length = min(doc_lengths) if doc_lengths else 0

    token_counts = Counter(token_ids)
    top_tokens = token_counts.most_common(10)

    non_pad_tokens = sum(sum(1 for t in seq if t != 0) for seq in sequences)
    total_positions = sum(len(seq) for seq in sequences)
    utilization = non_pad_tokens / max(total_positions, 1)

    stats = {
        "total_documents": len(documents),
        "total_characters": total_chars,
        "total_tokens": total_tokens,
        "unique_tokens": unique_tokens,
        "vocab_utilization": unique_tokens / tokenizer_vocab_size,
        "compression_ratio": compression_ratio,
        "avg_doc_length_words": avg_doc_length,
        "max_doc_length_words": max_doc_length,
        "min_doc_length_words": min_doc_length,
        "num_sequences": len(sequences),
        "sequence_utilization": utilization,
        "top_10_tokens": top_tokens,
    }
    return stats
نسبت فشردهسازی بازدهی توکنایزر را روی این مجموعهمتن نشان میدهد. متون انگلیسی بهطور معمول به حدود 3 تا 4 کاراکتر به ازای هر توکن فشرده میشوند. اگر به نسبت 1.5 کاراکتر به ازای هر توکن برخوردید، یعنی توکنایزر با افراط متن را خرد میکند. نسبتهای بالاتر از 8 هم نشاندهندهی یادگیری mergeهای بسیار وابسته به یک حوزهی خاص است.
بهرهوری دنباله (Sequence utilization) به شما میگوید چه میزان از دنبالههای بستهبندیشده را دادههای واقعی تشکیل میدهند و چه مقدار از آن سهم پدینگ است. مقادیر زیر 90% نشان از ناکارآمدی فرآیند بستهبندی دارد و گویای هدررفت توان پردازشی روی توکنهای پدینگ است.
استفاده از ابزارهای واقعی
مقایسه با کتابخانهی HuggingFace Datasets
همان مجموعهمتن را به کمک کتابخانهی datasets در HuggingFace بارگذاری کرده و سرعت پایپلاینها را بسنجید.
from datasets import load_dataset
from transformers import AutoTokenizer

ds = load_dataset("wikitext", "wikitext-2-raw-v1", split="train")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B")

import time

start = time.time()
tokenized = ds.map(
    lambda x: tokenizer(x["text"], truncation=True, max_length=2048),
    batched=True,
    num_proc=4,
)
hf_time = time.time() - start
total_tokens = sum(len(t) for t in tokenized["input_ids"])
print(f"HuggingFace: {total_tokens:,} tokens in {hf_time:.2f}s ({total_tokens/hf_time:,.0f} tokens/sec)")پایپلاین HuggingFace در لایههای زیرین از توکنایزرهای توسعهیافته با Rust و پردازش موازی روی 4 هسته بهره میبرد. پایپلاین خالص پایتونی شما 10 تا 50 برابر کندتر عمل خواهد کرد. همین شکاف عمیق است که تیمهای عملیاتی را به استفاده از توکنایزرهای کامپایلشده سوق میدهد. الگوریتم تغییر نکرده؛ تفاوت در زبان پیادهسازی است.
انتشار خروجی
حاصل این درس پرامپتی جهت اعتبارسنجی و اشکالزدایی کیفیت دادهها در پایپلاینهای آموزش مدلهای زبانی بزرگ است. به فایل outputs/prompt-data-quality-checker.md مراجعه کنید.
تمرینها
- ساده: قابلیت تشخیص زبان را با کمک یک روش سرانگشتی ساده (تحلیل مجموعهکاراکترها) به پایپلاین پاکسازی اضافه کنید. فیلتری بگذارید که فقط اسناد انگلیسی باقی بمانند و بررسی کنید چند سند از این طریق دور ریخته میشوند.
- متوسط: حذف تکرار دقیق را با استفاده از هشهای SHA-256 در کنار الگوریتم شبهتکرار MinHash پیاده کنید. تعداد موارد تکراری شناساییشده توسط هر دو روش را روی یک مجموعهمتنِ استخراجشده از وب مقایسه کنید.
- سخت: یک فیلتر کیفی مبتنی بر پرپلکسیتی بسازید. یک مدل زبانی بایگرام (bigram) ساده روی متنهای ویکیپدیا آموزش دهید، به هر سند بر اساس پرپلکسیتی نمره دهید و 20% ضعیفترین را حذف کنید. کیفیت خروجی مدلی را که روی دادههای فیلترشده آموزش دیده با مدلی که روی دادههای خام و فیلترنشده آموزش دیده، مقایسه نمایید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| Common Crawl | «کل اینترنت» | بنیادی غیرانتفاعی که ماهانه وب را میکاود؛ منبعی حدوداً 250 ترابایتی و نقطهی آغازی برای آموزش اغلب مدلهای زبانی |
| MinHash | «یکجور حُقهی هشینگ» | روشی برای تخمین شباهت ژاکارد میان مجموعهها با تکیه بر امضاهایی با طول ثابت؛ ابزاری برای کشف اسناد تقریباً یکسان در مقیاس بزرگ |
| LSH | «هشینگ حساس به مکان» | شیوهای برای گردآوری اقلام مشابه در یک باکت مشترک؛ که مقایسهی دوبهدو را از مرتبهی به حالت تقریباً خطی میرساند |
| Sequence packing | «چسباندن اسناد به هم» | جا دادن چندین سند در دنبالههایی با طول مشخص به همراه ماسک اتنشن صحیح، برای پرهیز از اتلاف منابع پردازشی ناشی از پدینگ |
| Chinchilla scaling | «آموزش روی دادهی بیشتر» | اصلی که میگوید برای یک بودجهی محاسباتی ثابت، رسیدن به عملکرد بهینه مستلزم بزرگکردن همزمان و تقریباً برابرِ مدل و توکنهای آموزشی است |
| Fertility | «توکن بر کلمه» | میانگین تعداد توکنها به ازای هر کلمه؛ حدود 1.3 برای زبان انگلیسی در GPT-4 و ارقامی بالاتر برای خطهای غیرلاتین |
| Data mixing | «دستچینکردن دادهی آموزشی» | نسبت دادههای کد به متن، ریاضی و منابع چندزبانه؛ فرمول ثابتی ندارد و نیازمند آزمون و خطاست |
| Perplexity filter | «امتیازدهی کیفی» | استفاده از یک مدل زبانی کوچک جهت نمرهدهی به اسناد؛ پرپلکسیتیِ بالا یعنی متن فرسنگها با متون پاک و مرجع فاصله دارد |
| Deduplication | «پاک کردن نسخههای تکراری» | حذف اسناد یکسان یا تقریباً یکسان؛ این مرحله معمولاً 30 تا 40 درصد از دادههای خام وب را دور میریزد |
| Attention mask | «به کدام توکنها توجه کنیم» | یک ماسک باینری که از توجه بین توکنهای مربوط به اسناد متفاوت در یک دنبالهی مشترک ممانعت به عمل میآورد |
برای مطالعهی بیشتر
- Hoffmann et al., 2022 -- Training Compute-Optimal Large Language Models (Chinchilla) -- مقالهای که دیدگاه ما را به مقیاس دادهها متحول کرد.
- Penedo et al., 2023 -- The RefinedWeb Dataset for Falcon LLM -- راهنمای پالایش و فیلتر کردن Common Crawl برای دستیابی به کیفیت عالی.
- Touvron et al., 2023 -- Llama 2: Open Foundation and Fine-Tuned Chat Models -- جزئیات پایپلاین داده برای آموزش Llama 2.
- Lee et al., 2022 -- Deduplicating Training Data Makes Language Models Better -- چرایی اهمیت بنیادینِ حذف تکرار، بسیار فراتر از آنچه میپندارید.
- Broder, 1997 -- On the Resemblance and Containment of Documents -- مقالهی اصلی معرفی MinHash.
- Meta, 2024 -- Llama 3 Technical Report -- 15.6 تریلیون توکن، نسبتهای ترکیب داده و پایپلاین فیلترسازی.