
توکنسازهای ساده و آموزشی معمولاً با متنهای انگلیسی بهخوبی کار میکنند، اما به محض مواجهه با نویسههای فارسی، عربی، خطوط آسیای شرقی یا حتی ایموجیها از کار میافتند یا توکن ناشناخته تولید میکنند. در مدلهای زبانی امروزی، ورودی مدل مستقیماً به کیفیت همین لایهی پایه بستگی دارد؛ اگر توکنساز نتواند بایتها را درست مدیریت کند، طول دنبالهها بیهوده افزایش پیدا میکند و کارایی مدل به شدت افت خواهد کرد.
در این درس یاد میگیرید که چطور پایپلاین کامل یک توکنساز عملیاتی را بسازید. این معماری شامل نرمالسازی یونیکد، پیشتوکنسازی با الگوهای رجکس برای حفظ مرز کلمات، مدیریت دقیق توکنهای ویژه (Special Tokens) و سازوکار BPE در سطح بایت (Byte-Level BPE) است تا بتواند هر ورودی متنی یا کد را بدون خطا پردازش کند.
کدهای این درس به صورت مستقل در پایتون اجرا میشوند و نیازی به کارت گرافیک یا پرداخت ارزی ندارند. با این حال، اگر قصد آزمایش با بستههایی نظیر tiktoken یا tokenizers را در محیط محلی داشته باشید، با توجه به ناپایداریهای احتمالی دانلود از PyPI، میتوانید از میرورهای داخلی پایتون برای نصب سریعتر بستهها کمک بگیرید.
در درس 01 با یک اسباببازی سرگرم شدید؛ این درس به شما سلاح جنگی میدهد.
اهداف یادگیری
- ساخت یک توکنساز BPE در سطح محیط عملیاتی (production-grade) با قابلیت مدیریت یونیکد، نرمالسازی فاصلهها و توکنهای ویژه
- پیادهسازی سازوکار بازگشت در سطح بایت (byte-level fallback) تا توکنساز بتواند هر ورودی دلخواهی (از جمله ایموجی، نویسههای CJK و کد) را بدون تولید توکن ناشناخته کدگذاری کند
- افزودن الگوهای رجکس پیشتوکنسازی (pre-tokenization) برای شکستن متن در مرز کلمات، پیش از اعمال ادغامهای BPE
- آموزش یک توکنساز سفارشی روی یک مجموعهمتن و ارزیابی ضریب فشردگی آن در مقایسه با tiktoken روی متون چندزبانه
صورت مسئله
توکنساز BPE شما از درس 01 روی متن انگلیسی خوب کار میکند. حالا یک متن ژاپنی، چند ایموجی، یا کدهای پایتونی را که تبها و فاصلهها در آنها ترکیب شدهاند به آن بدهید.
از کار میافتد.
دلیلش غلط بودن الگوریتم BPE نیست؛ علت، ناقص بودن پیادهسازی است. یک توکنساز آمادهی تولید، بایتهای خام را با هر انکودینگی پردازش میکند، یونیکد را پیش از شکستن متن نرمالسازی مینماید، توکنهای ویژهای را که هرگز نباید ادغام شوند مدیریت میکند، پیشتوکنسازی را به تفکیک زیرکلمهها (subword splitting) پیوند میزند، و تمام این کارها را چنان سریع انجام میدهد که در یک پایپلاین آموزشی برای پردازش 15 تریلیون توکن گلوگاه ایجاد نکند.
توکنساز GPT-2 دقیقاً 50,257 توکن دارد. مدل Llama 3 دارای 128,256 توکن است و GPT-4 حدود 100,000 توکن دارد. این اعداد حاصل کارهای پیشپاافتاده نیستند. جدولهای ادغام پشتیبان این واژگان روی صدها گیگابایت متن آموزش دیدهاند، و سازوکارهای پیرامونی آنها — یعنی نرمالسازی، پیشتوکنسازی، تزریق توکنهای ویژه و قالببندی الگوی چت — همان مرزی است که یک توکنساز سادهی «hello world» را از سیستمی جدا میکند که کل اینترنت را پردازش میکند.
شما قرار است همین سازوکار را بسازید.
مفاهیم پایه
پایپلاین کامل
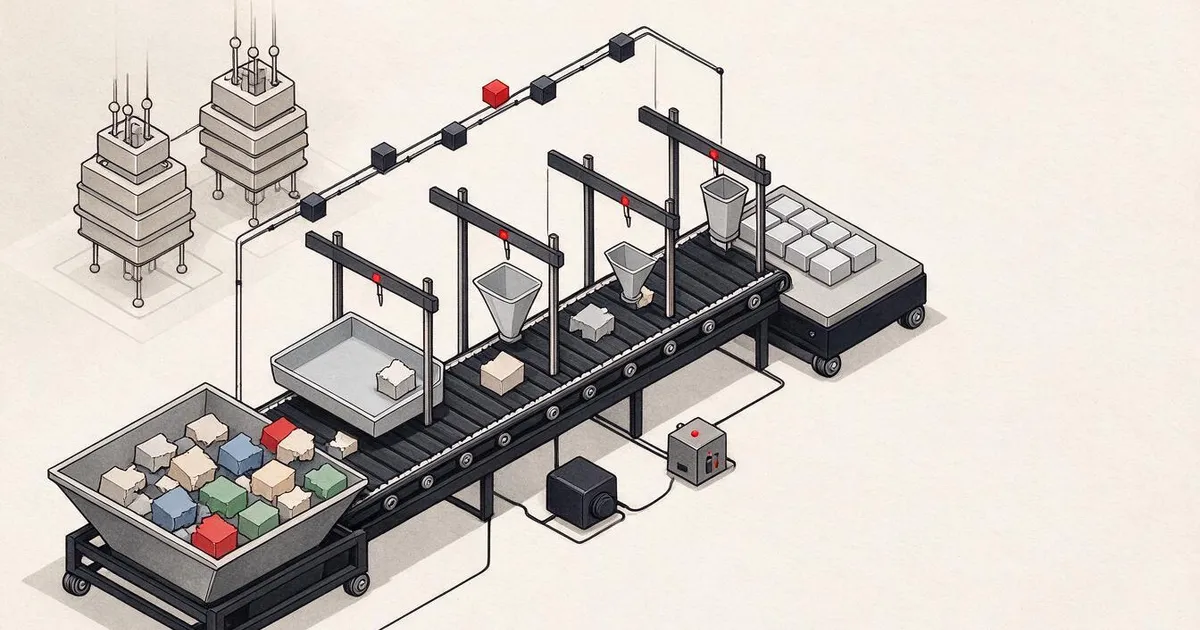
یک توکنساز عملیاتی تنها یک الگوریتم منفرد نیست؛ پایپلاینی پنجمرحلهای است که هر مرحلهی آن مسئلهای متفاوت را حل میکند.
هر مرحله وظیفهی مشخصی دارد:
| مرحله | کارکرد | اهمیت |
|---|---|---|
| نرمالسازی (Normalize) | اعمال فرم NFKC یونیکد، کوچکسازی حروف اختیاری، حذف اعراب اختیاری | اتصال دو نویسهای «fi» (کد U+FB01) به دو نویسهی مجزای «fi» تبدیل میشود. بدون این کار، یک کلمهی یکسان توکنهای متفاوتی دریافت میکند. |
| پیشتوکنسازی (Pre-Tokenize) | تقسیم متن به قطعات مجزا پیش از اعمال BPE | مانع از ادغام در مرز کلمات توسط BPE میشود؛ عبارت «the cat» هرگز نباید توکنی مانند «e c» تولید کند. |
| ادغام BPE (BPE Merge) | اعمال قواعد ادغامِ یادگرفتهشده روی دنبالههای بایتی | هستهی اصلی فشردگی؛ بایتهای خام را به توکنهای زیرکلمه تبدیل میکند. |
| توکنهای ویژه (Special Tokens) | تزریق نشانگرهای [BOS]، [EOS]، [PAD] و قالبهای چت | این توکنها شناسههای ثابتی دارند، هرگز در ادغامهای BPE شرکت نمیکنند، و مدل برای درک ساختار به آنها نیاز دارد. |
| نگاشت شناسه (ID Mapping) | تبدیل رشتههای توکن به شناسههای عددی صحیح | مدل اعداد صحیح را میبیند، نه رشتههای متنی را. |
الگوریتم BPE در سطح بایت (Byte-Level BPE)
توکنساز درس 01 روی بایتهای UTF-8 کار میکرد. این رویکرد درست بود، اما یک نکتهی مهم را جا انداختیم: اگر این بایتها UTF-8 معتبر نباشند چه اتفاقی میافتد؟
الگوریتم BPE در سطح بایت این مسئله را با معتبر دانستن تمام مقادیر ممکن بایت (0 تا 255) به عنوان یک توکن معتبر حل میکند. دایرهی واژگان پایهی شما دقیقاً 256 مدخل خواهد داشت. هر فایلی — متن، باینری یا حتی دادهی آسیبدیده — بدون ایجاد حتی یک توکن ناشناخته توکنسازی میشود.
سازندگان GPT-2 ترفندی اضافه کردند: نگاشت هر بایت به یک نویسهی یونیکد قابل چاپ، تا واژگان برای انسان خوانا باقی بماند. برای نمونه بایت 0x20 (فاصله) در نگاشت آنها به نویسهی «Ġ» تبدیل میشود. این تغییر صرفاً ظاهری است و الگوریتم اهمیتی به آن نمیدهد.
قدرت واقعی اینجاست: BPE در سطح بایت از تمام زبانهای دنیا پشتیبانی میکند. نویسههای چینی هر کدام 3 بایت UTF-8 هستند. ژاپنی میتواند 3 تا 4 بایت باشد. عربی، دیواناگری، ایموجی — همگی صرفاً دنبالهای از بایتها هستند. الگوریتم BPE الگوهای موجود در این دنبالههای بایتی را دقیقاً به همان روشی پیدا میکند که الگوهای بایتهای اسکی (ASCII) انگلیسی را پیدا میکند.
پیشتوکنسازی (Pre-Tokenization)
پیش از آنکه BPE دستبهکارِ متن شود، باید آن را به بخشهای مجزا بشکنید. این کار مانع از آن میشود که الگوریتم ادغام، توکنهایی بسازد که از مرز کلمات عبور میکنند.
مدل GPT-2 از یک الگوی رجکس (regex) برای تکهتکه کردن متن استفاده میکند:
'(?:[sdmt]|ll|ve|re)| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+این الگو متن را بر اساس حالتهای مخفف (برای نمونه «don't» به «don» و «'t» تبدیل میشود)، کلمات همراه با فاصلهی ابتدایی اختیاری، اعداد، علائم نگارشی و فاصلههای خالی میشکند. فاصلهی ابتدایی به کلمه چسبیده باقی میماند — در نتیجه «the cat» به [" the", " cat"] تبدیل میشود، نه به ["the", " ", "cat"].
مدل Llama از SentencePiece استفاده میکند که رجکس را کاملاً کنار میگذارد. این ابزار جریان بایت خام را یک دنبالهی طولانیِ پیوسته در نظر میگیرد و پیدا کردن مرزها را به الگوریتم BPE میسپارد. این روش سادهتر است، اما دست BPE را برای ساخت توکنهای بینکلمهای بازتر میگذارد.
این تفاوت اهمیت زیادی دارد. رجکس GPT-2 مانع از آن میشود که توکنساز یاد بگیرد «the» انتهای یک کلمه را با «the» ابتدای کلمهی بعدی ادغام کند. SentencePiece این اجازه را میدهد، که گاهی فشردگی بهتری ایجاد میکند اما تفسیرپذیری توکنها را کاهش میدهد.
توکنهای ویژه (Special Tokens)
تمام توکنسازهای آمادهی تولید، شناسههای توکن مشخصی را برای نشانگرهای ساختاری رزرو میکنند:
| توکن | هدف | استفاده در |
|---|---|---|
[BOS] / <s> |
آغاز دنباله (Beginning of sequence) | Llama 3، GPT |
[EOS] / </s> |
پایان دنباله (End of sequence) | تمام مدلها |
[PAD] |
پدینگ برای همترازی دستهای (batch alignment) | BERT، T5 |
[UNK] |
توکن ناشناخته (BPE در سطح بایت این را حذف میکند) | BERT، WordPiece |
<|im_start|> |
شروع مرز پیام چت | ChatGPT، Qwen |
<|im_end|> |
پایان مرز پیام چت | ChatGPT، Qwen |
<|user|> |
نشانگر نوبت گفتوگوی کاربر | Llama 3 |
<|assistant|> |
نشانگر نوبت گفتوگوی دستیار | Llama 3 |
توکنهای ویژه هرگز با BPE شکسته نمیشوند. این توکنها پیش از اجرای الگوریتم ادغام، بهطور دقیق مطابقت داده میشوند، با شناسهی ثابت خود جایگزین میشوند، و متن اطراف آنها به صورت معمول توکنسازی میشود.
الگوهای چت (Chat Templates)
بیشتر افراد دقیقاً در همین بخش گیج میشوند و بیشتر پیادهسازیها همینجا به خطا میخورند.
وقتی پیامی به یک مدل چت ارسال میکنید، API لیستی از پیامها را میگیرد:
[
  {"role": "system", "content": "You are helpful."},
  {"role": "user", "content": "Hello"},
  {"role": "assistant", "content": "Hi there!"}
]
مدل ساختار JSON را نمیبیند، بلکه یک دنبالهی تخت از توکنها را میبیند. الگوی چت این پیامها را با استفاده از توکنهای ویژه به یک دنبالهی مسطح تبدیل میکند. هر مدلی این کار را به شیوهی خودش انجام میدهد:
Llama 3:
<|begin_of_text|><|start_header_id|>system<|end_header_id|>

You are helpful.<|eot_id|><|start_header_id|>user<|end_header_id|>

Hello<|eot_id|><|start_header_id|>assistant<|end_header_id|>

Hi there!<|eot_id|>

ChatGPT:
<|im_start|>system
You are helpful.<|im_end|>
<|im_start|>user
Hello<|im_end|>
<|im_start|>assistant
Hi there!<|im_end|>
اگر الگو را اشتباه پیاده کنید، خروجی مدل بیمعنی خواهد بود. مدل دقیقاً روی یک فرمت مشخص آموزش دیده است. هرگونه انحراف — یک خط جدیدِ جاافتاده، یک توکن جابهجا شده یا یک فاصلهی اضافی — ورودی را از توزیع دادههای آموزشی خارج میکند.
سرعت اجرا
پایتون برای توکنسازی در مقیاس عملیاتی بیش از حد کند است.
کتابخانهی tiktoken (توسعهیافته توسط OpenAI) با زبان Rust نوشته شده و اتصالات پایتونی (bindings) دارد. کتابخانهی tokenizers متعلق به HuggingFace نیز با Rust پیاده شده است. ابزار SentencePiece هم با ++C توسعه یافته است. این ابزارها به سرعتی بین 10 تا 100 برابر پایتون خالص میرسند.
برای درک بهتر: توکنسازی 15 تریلیون توکن برای پیشآموزش Llama 3 با سرعت 1 میلیون توکن بر ثانیه (پایتون بهینهسازیشده و سریع) حدود 174 روز طول میکشد. با سرعت 100 میلیون توکن بر ثانیه (در زبان Rust)، این زمان به 1.7 روز کاهش مییابد.
ما این بخش را در پایتون پیاده میکنیم تا الگوریتم را عمیقاً درک کنید. در محیط عملیاتی، باید از پیادهسازیهای کامپایلشده استفاده کنید و فقط با واسط پایتونی آن کار کنید.
پیادهسازی قدمبهقدم
مرحلهی 1: کدگذاری در سطح بایت
پایهی کار: تبدیل هر رشته به دنبالهای از بایتها، نگاشت هر بایت به نویسهای قابل چاپ برای نمایش، و برعکس کردن این فرآیند.
def bytes_to_tokens(text):
    return list(text.encode("utf-8"))

def tokens_to_text(token_bytes):
    return bytes(token_bytes).decode("utf-8", errors="replace")
بررسی کارکرد روی متن چندزبانه برای مشاهدهی تعداد بایتها:
texts = [
    ("English", "hello"),
    ("Chinese", "你好"),
    ("Emoji", "🔥"),
    ("Mixed", "hello你好🔥"),
]

for label, text in texts:
    b = bytes_to_tokens(text)
print(f"{label}: {len(text)} chars -> {len(b)} bytes -> {b}")کلمهی «hello» برابر 5 بایت است. «你好» برابر 6 بایت (3 بایت برای هر نویسه) است. ایموجی آتش 4 بایت فضا میگیرد. برای توکنساز سطح بایت اصلاً فرقی ندارد زبان ورودی چیست؛ بایت، بایت است.
مرحلهی 2: پیشتوکنساز با رجکس
شکستن متن به قطعات مجزا با استفاده از الگوی رجکس GPT-2. هر قطعه بهطور مستقل توسط BPE توکنسازی میشود.
import re

try:
    import regex
    GPT2_PATTERN = regex.compile(
        r"""'(?:[sdmt]|ll|ve|re)| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+"""
    )
except ImportError:
    GPT2_PATTERN = re.compile(
        r"""'(?:[sdmt]|ll|ve|re)| ?[a-zA-Z]+| ?[0-9]+| ?[^\s\w]+|\s+(?!\S)|\s+"""
    )

def pre_tokenize(text):
    return [match.group() for match in GPT2_PATTERN.finditer(text)]
ماژول regex از نویسههای گریز ویژگیهای یونیکد پشتیبانی میکند (\p{L} برای حروف و \p{N} برای اعداد). ماژول استاندارد re چنین قابلیتی ندارد، به همین دلیل به دستههای کاراکتری ASCII برمیگردیم. برای توکنسازهای چندزبانهی عملیاتی، حتماً بستهی regex را نصب کنید.
آزمایش عملکرد:
print(pre_tokenize("Hello, world! Don't stop."))
# [' Hello', ',', ' world', '!', " Don", "'t", ' stop', '.']فاصلهی ابتدایی به کلمه چسبیده باقی میماند. کلمات مخفف در محل آپوستروف تفکیک میشوند. علائم نگارشی هم به قطعهای مجزا تبدیل میشوند. BPE هرگز توکنها را فراتر از این مرزها ادغام نخواهد کرد.
مرحلهی 3: اعمال BPE روی دنبالههای بایتی
همان الگوریتم اصلی درس 01، اما این بار بهطور مستقل روی قطعات پیشتوکنشده اجرا میشود.
from collections import Counter

def get_byte_pairs(chunks):
    pairs = Counter()
    for chunk in chunks:
        byte_seq = list(chunk.encode("utf-8"))
        for i in range(len(byte_seq) - 1):
            pairs[(byte_seq[i], byte_seq[i + 1])] += 1
    return pairs

def apply_merge(byte_seq, pair, new_id):
    merged = []
    i = 0
    while i < len(byte_seq):
        if i < len(byte_seq) - 1 and byte_seq[i] == pair[0] and byte_seq[i + 1] == pair[1]:
            merged.append(new_id)
            i += 2
        else:
            merged.append(byte_seq[i])
            i += 1
return mergedمرحلهی 4: مدیریت توکنهای ویژه
توکنهای ویژه به تطابق دقیق و شناسههای ثابت نیاز دارند و الگوریتم BPE را کاملاً دور میزنند.
class SpecialTokenHandler:
    def __init__(self):
        self.special_tokens = {}
        self.pattern = None

    def add_token(self, token_str, token_id):
        self.special_tokens[token_str] = token_id
        escaped = [re.escape(t) for t in sorted(self.special_tokens.keys(), key=len, reverse=True)]
        self.pattern = re.compile("|".join(escaped))

    def split_with_specials(self, text):
        if not self.pattern:
            return [(text, False)]
        parts = []
        last_end = 0
        for match in self.pattern.finditer(text):
            if match.start() > last_end:
                parts.append((text[last_end:match.start()], False))
            parts.append((match.group(), True))
            last_end = match.end()
        if last_end < len(text):
            parts.append((text[last_end:], False))
return partsمرحلهی 5: کلاس کامل توکنساز
پیوند دادن تمام مراحل به یکدیگر: نرمالسازی، برش بر اساس توکنهای ویژه، پیشتوکنسازی، ادغامهای BPE و در نهایت نگاشت به شناسهها.
import unicodedata

class ProductionTokenizer:
    def __init__(self):
        self.merges = {}
        self.vocab = {i: bytes([i]) for i in range(256)}
        self.special_handler = SpecialTokenHandler()
        self.next_id = 256

    def normalize(self, text):
        return unicodedata.normalize("NFKC", text)

    def train(self, text, num_merges):
        text = self.normalize(text)
        chunks = pre_tokenize(text)
        chunk_bytes = [list(chunk.encode("utf-8")) for chunk in chunks]

        for i in range(num_merges):
            pairs = Counter()
            for seq in chunk_bytes:
                for j in range(len(seq) - 1):
                    pairs[(seq[j], seq[j + 1])] += 1
            if not pairs:
                break
            best = max(pairs, key=pairs.get)
            new_id = self.next_id
            self.next_id += 1
            self.merges[best] = new_id
            self.vocab[new_id] = self.vocab[best[0]] + self.vocab[best[1]]
            chunk_bytes = [apply_merge(seq, best, new_id) for seq in chunk_bytes]

    def add_special_token(self, token_str):
        token_id = self.next_id
        self.next_id += 1
        self.special_handler.add_token(token_str, token_id)
        self.vocab[token_id] = token_str.encode("utf-8")
        return token_id

    def encode(self, text):
        text = self.normalize(text)
        parts = self.special_handler.split_with_specials(text)
        all_ids = []
        for part_text, is_special in parts:
            if is_special:
                all_ids.append(self.special_handler.special_tokens[part_text])
            else:
                for chunk in pre_tokenize(part_text):
                    byte_seq = list(chunk.encode("utf-8"))
                    for pair, new_id in self.merges.items():
                        byte_seq = apply_merge(byte_seq, pair, new_id)
                    all_ids.extend(byte_seq)
        return all_ids

    def decode(self, ids):
        byte_parts = []
        for token_id in ids:
            if token_id in self.vocab:
                byte_parts.append(self.vocab[token_id])
        return b"".join(byte_parts).decode("utf-8", errors="replace")

    def vocab_size(self):
return len(self.vocab)مرحلهی 6: آزمون چندزبانه
آزمون واقعی: متن انگلیسی، چینی، ایموجی و کدهای برنامهنویسی را به آن میدهیم.
corpus = (
    "The quick brown fox jumps over the lazy dog. "
    "The quick brown fox runs through the forest. "
    "Machine learning models process natural language. "
    "Deep learning transforms how we build software. "
    "def train(model, data): return model.fit(data) "
    "def predict(model, x): return model(x) "
)

tok = ProductionTokenizer()
tok.train(corpus, num_merges=50)

bos = tok.add_special_token("<|begin|>")
eos = tok.add_special_token("<|end|>")

test_texts = [
    "The quick brown fox.",
    "你好世界",
    "Hello 🌍 World",
    "def foo(x): return x + 1",
    f"<|begin|>Hello<|end|>",
]

for text in test_texts:
    ids = tok.encode(text)
    decoded = tok.decode(ids)
    print(f"Input:   {text}")
    print(f"Tokens:  {len(ids)} ids")
    print(f"Decoded: {decoded}")
print()نویسههای چینی هر کدام 3 بایت تولید میکنند. ایموجی 4 بایت میسازد. هیچکدام توکنساز را با خطا متوقف نمیکنند و هیچ توکن ناشناختهای هم تولید نمیشود. قدرت واقعی BPE در سطح بایت در همین نکته است.
استفاده از ابزارهای واقعی
مقایسهی توکنسازهای واقعی
توکنسازهای واقعی Llama 3، GPT-4 و Mistral را لود میکنیم تا ببینیم هر کدام یک پاراگراف چندزبانهی یکسان را چگونه پردازش میکنند.
import tiktoken

gpt4_enc = tiktoken.get_encoding("cl100k_base")

test_paragraph = "Machine learning is powerful. 机器学习很强大。 L'apprentissage automatique est puissant. 🤖💪"

tokens = gpt4_enc.encode(test_paragraph)
pieces = [gpt4_enc.decode([t]) for t in tokens]
print(f"GPT-4 ({len(tokens)} tokens): {pieces}")
from transformers import AutoTokenizer
llama_tok = AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B")
mistral_tok = AutoTokenizer.from_pretrained("mistralai/Mistral-7B-v0.1")
for name, tok in [("Llama 3", llama_tok), ("Mistral", mistral_tok)]:
tokens = tok.encode(test_paragraph)
pieces = tok.convert_ids_to_tokens(tokens)
print(f"{name} ({len(tokens)} tokens): {pieces[:20]}...")تعداد توکنهای متفاوتی را برای متنی یکسان خواهید دید. توکنساز Llama 3 با دایرهی واژگان 128 هزارتایی، الگوهای رایج را با جسارت بیشتری ادغام میکند. مدل GPT-4 با 100 هزار واژه در میانه قرار میگیرد. مدل Mistral با 32 هزار واژه توکنهای بیشتری میسازد اما لایهی امبدینگ (embedding layer) کوچکتری دارد.
این موازنه همیشه برقرار است: واژگان بزرگتر یعنی دنبالههای کوتاهتر، اما در ازای پارامترهای بیشتر برای مدل.
تحویل نهایی
این درس یک پرامپت اختصاصی برای ساخت و اشکالزدایی توکنسازهای آمادهی تولید در اختیارتان میگذارد. به فایل outputs/prompt-tokenizer-builder.md مراجعه کنید.
تمرینها
- ساده: متدی با نام
get_token_bytes(id)اضافه کنید که بایتهای خام مربوط به هر شناسهی توکن را نمایش دهد. از آن برای بررسی این نکته استفاده کنید که رایجترین توکنهای ادغامشدهی شما در عمل حامل چه دادهای هستند. - متوسط: یک پیشتوکنساز به سبک Llama پیادهسازی کنید که متن را روی فاصلهها و ارقام برش بزند اما فاصلههای ابتدایی را حفظ کند. واژگان حاصل از آن را با روش رجکس GPT-2 روی همان مجموعهمتن مقایسه کنید.
- سخت: متدی برای الگوی چت بسازید که فهرستی از پیامهای شامل
{"role": ..., "content": ...}را بگیرد و دنبالهی توکن صحیح را برای قالب چت Llama 3 تولید کند. خروجی آن را در مقایسه با پیادهسازی رسمی HuggingFace ارزیابی و اعتبارسنجی کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| BPE در سطح بایت (Byte-level BPE) | «توکنسازی که روی بایت کار میکند» | الگوریتم BPE با واژگان پایهی 256 مقداری از بایتها؛ هر ورودی دلخواهی را بدون تولید توکن ناشناخته پردازش میکند |
| پیشتوکنسازی (Pre-tokenization) | «تکهتکه کردن قبل از BPE» | تفکیک متن با رجکس یا قوانین مشخص که مانع از ادغام در مرز کلمات توسط BPE میشود |
| نرمالسازی NFKC | «پاکسازی یونیکد» | تجزیهی متعارف و سپس ترکیب بر اساس سازگاری؛ برای مثال لیگچر «fi» به دو نویسهی «fi» و نویسهی تمامپهنای «A» به «A» معمولی تبدیل میشود |
| الگوی چت (Chat template) | «نحوهی تبدیل پیامها به توکن» | فرمت دقیق برای تبدیل فهرستی از پیامهای نقش/محتوا به یک دنبالهی مسطح از توکنها؛ مختص هر مدل است و باید موبهمو با فرمت پیشآموزش همخوانی داشته باشد |
| توکنهای ویژه (Special tokens) | «توکنهای کنترلی» | شناسههای توکن رزروشده که BPE را دور میزنند (مانند [BOS]، [EOS]، [PAD] و نشانگرهای چت) و پیش از ادغام بهطور دقیق تطبیق داده میشوند |
| نرخ باروری (Fertility) | «تعداد توکن در هر کلمه» | نسبت توکنهای خروجی به کلمات ورودی؛ حدود 1.3 برای انگلیسی در GPT-4، بین 2 تا 3 برای کرهای؛ مقدار بالاتر به معنای هدررفت طول بافت (context) است |
| tiktoken | «توکنساز OpenAI» | پیادهسازی BPE با زبان Rust به همراه اتصالات پایتونی؛ 10 تا 100 برابر سریعتر از پایتون خالص |
| جدول ادغام (Merge table) | «دایرهی واژگان» | فهرست مرتبی از ادغامهای جفتبایت که در طول آموزش استخراج شدهاند؛ این جدول تمام دانش یادگرفتهشدهی توکنساز است |
برای مطالعهی بیشتر
- سورسکد tiktoken اوپنایآی -- پیادهسازی BPE در زبان Rust که در GPT-3.5 و GPT-4 استفاده میشود
- کتابخانهی tokenizers در HuggingFace -- کتابخانهی توکنسازی مبتنی بر Rust با پشتیبانی از BPE، WordPiece و Unigram
- مقالهی Llama 3 (متا، 2024) -- جزئیات واژگان 128 هزارتایی و نحوهی آموزش توکنساز
- ابزار SentencePiece (کودو و ریچاردسون، 2018) -- توکنسازی مستقل از زبان
- سورسکد توکنساز GPT-2 -- نگاشت اولیهی بایت به یونیکد