
مدلهای تصویرمحور سنتی مانند CLIP برای سنجش شباهت تصویر و متن عالی هستند، اما توانایی استدلال زبانی یا پاسخ به پرسشهای جزئی دربارهی یک تصویر را ندارند. مدلهای زبانی-دیداری (Vision-Language Models یا VLMها) با اتصال یک انکودر بینایی به یک مدل زبانی بزرگ، امکان درک محتوا و تولید پاسخ متنی را فراهم کردهاند و نقشی محوری در توسعهی دستیارهای هوشمند ایفا میکنند.
در این درس معماری استاندارد ViT-MLP-LLM را بررسی میکنیم؛ ساختاری که در تمام مدلهای مطرح مانند Qwen3-VL و LLaVA به کار رفته است. با شناخت این الگو یاد میگیرید که چگونه پروجکتور توکنهای تصویر را به فضای زبانی میبرد، چه مراحلی در آموزش این مدلها طی میشود و چگونه با سنجههایی مثل CMER جلوی توهم بینوجهی مدل را در محیط واقعی بگیرید.
برای اجرای عملی و تست مدلهای متنباز این حوزه، مدلهای کمپارامتر را میتوان بهصورت محلی روی سیستم شخصی اجرا کرد. با این حال، استفاده از APIهای ابری ارائهدهندگان خارجی با کارتهای بانکی ایرانی میسر نیست و تهیه یا اجارهی کارتهای گرافیک قدرتمند خارجی برای فاینتیونینگ نیز هزینهی ارزی قابلتوجهی دارد؛ از این رو تکیه بر مدلهای سبک یا روشهای LoRA و اجرای محلی رویکردی منطقیتر به شمار میآید.
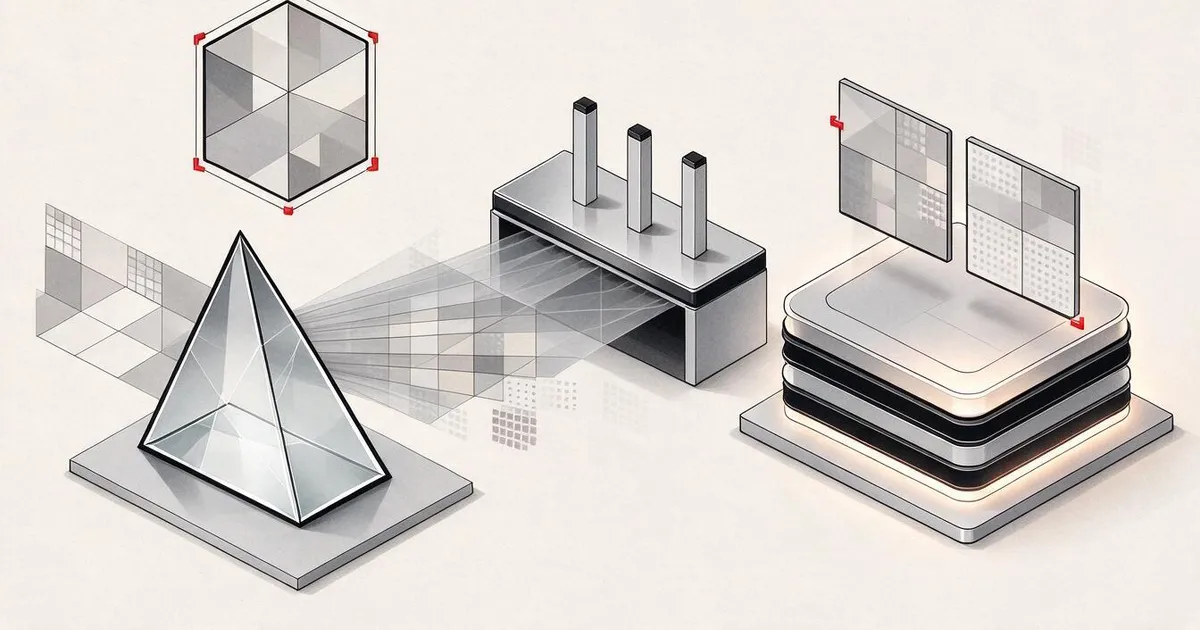
یک انکودر بینایی، تصویر را به توکن تبدیل میکند. یک پروجکتور MLP این توکنها را به فضای امبدینگ مدل زبانی تصویر میکند (Projection). بقیهی کارها را مدل زبانی انجام میدهد. این الگو — یعنی ViT-MLP-LLM — ساختار پایهی تمام VLMهای پروداکشن در سال 2026 است.
اهداف یادگیری
- ساختار معماری ViT-MLP-LLM را بیان کنید و نقش هر یک از سه مؤلفهی آن را توضیح دهید.
- مدلهای Qwen3-VL، InternVL3.5، LLaVA-Next و GLM-4.6V را از نظر تعداد پارامتر، طول کانتکست و عملکرد در بنچمارکها با هم مقایسه کنید.
- مفهوم DeepStack را توضیح دهید: چرا استفاده از ویژگیهای چندسطحی ViT، همترازی بین تصویر و زبان را بهتر از اتکا به ویژگی تکلایهی آخر تقویت میکند.
- توهم (Hallucination) مدلهای VLM را در محیط پروداکشن با نرخ خطای بینوجهی (Cross-Modal Error Rate یا CMER) اندازه بگیرید و بر اساس این سیگنال اقدام کنید.
صورت مسئله
مدل CLIP (فاز 4، درس 18) یک فضای امبدینگ مشترک برای تصاویر و متن فراهم میکند؛ این فضا برای دستهبندی زیروشات (Zero-shot) و بازیابی اطلاعات کافی است. اما CLIP نمیتواند به پرسش «چند ماشین قرمز در این تصویر است؟» پاسخ دهد؛ چون متن تولید نمیکند و فقط شباهتها را میسنجد.
مدلهای زبانی-دیداری (Vision-Language Models یا VLMها) — مانند Qwen3-VL، InternVL3.5، LLaVA-Next و GLM-4.6V — یک انکودر تصویر از خانوادهی CLIP را به یک مدل زبانی کامل متصل میکنند. مدل، تصویر و پرسش را میبیند و پاسخ را تولید میکند. در سال 2026، VLMهای متنباز در بنچمارکهای چندوجهی (مانند MMMU، MMBench، DocVQA، ChartQA، MathVista و OSWorld) با رقبایی مثل GPT-5 و Gemini-2.5-Pro رقابت میکنند یا حتی آنها را شکست میدهند.
ترکیب این سه بخش (ViT، پروجکتور، LLM) یک استاندارد است. تفاوت مدلها صرفاً به نوع ViT، نوع پروجکتور، مدل زبانی پایه، دادههای آموزشی و دستورالعمل همترازی بازمیگردد. وقتی این الگو را درک کنید، تعویض هر مؤلفه با دیگری صرفاً کاری مکانیکی خواهد بود.
مفاهیم کلیدی
معماری ViT-MLP-LLM
- انکودر بینایی (Vision encoder): یک ViT از پیش آموزشدیده (مثل CLIP-L/14، SigLIP، DINOv3 یا یک نسخهی فاینتیونشده) که توکنهای وصلهای (Patch tokens) تولید میکند.
- پروجکتور (Projector): ماژول کوچکی (یک MLP با 2 تا 4 لایه، یا یک Q-former) که توکنهای تصویر را به بعد امبدینگ LLM تصویر میکند. بخش اعظم فاینتیونینگ روی همین بخش انجام میگیرد.
- مدل زبانی (LLM): یک مدل زبانی فقط-دیکودر (مانند Qwen3، Llama، Mistral، GLM یا InternLM) که توکنهای تصویر و متن را به صورت متوالی میخواند و متن تولید میکند.
روی کاغذ هر سه قطعه قابل آموزش هستند. اما در عمل، انکودر تصویر و مدل زبانی را عمدتاً دستنخورده (فریز) نگه میدارند و تنها پروجکتور را آموزش میدهند؛ ترفندی که با هزینهای ناچیز، سیگنالی در مقیاس چند میلیارد پارامتر فراهم میکند.
سازوکار DeepStack
در پروجکشن معمولی، فقط از آخرین لایهی ViT استفاده میشود. اما DeepStack (که در Qwen3-VL به کار رفته) از چندین عمق مختلف ViT ویژگیها را نمونهبرداری کرده و روی هم قرار میدهد (Stack). لایههای عمیقتر حامل معنای سطح بالا (Semantics) هستند؛ لایههای سطحیتر جزئیات دقیق مکانی و بافتها را منتقل میکنند. ارسال هر دو دسته به LLM، فاصلهی بین «تصویر حاوی چیست» (معنا) و «دقیقاً کجاست» (مکانیابی فضایی) را پر میکند.
سه مرحلهی آموزش
مدلهای مدرن VLM در سه مرحله آموزش میبینند:
- همترازی (Alignment): مدلهای ViT و LLM فریز میشوند و فقط پروجکتور روی جفتهای تصویر-کپشن آموزش میبیند. این کار به پروجکتور یاد میدهد که فضای بصری را به فضای زبان تصویر کند.
- پیشآموزش (Pre-training): قفل همهی وزنها باز میشود. کل سیستم روی دیتاستهای عظیم حاوی متن و تصویر درهمتنیده (بیش از 500M جفت داده) آموزش میبیند تا دانش بصری مدل ساخته شود.
- تنظیم دستورالعملها (Instruction tuning): مدل روی سهگانههای گزینششدهی (تصویر، پرسش، پاسخ) فاینتیون میشود. این مرحله رفتار گفتگو و قالب تسکها را آموزش میدهد و همان چیزی است که یک «مدل زبانِ آگاه به تصویر» را به یک دستیار کاربردی تبدیل میکند.
بیشتر فاینتیونهای مبتنی بر LoRA با یک دیتاست برچسبخوردهی جمعوجور، مستقیماً مرحلهی 3 را هدف میگیرند.
مقایسهی خانوادهی مدلها (اوایل سال 2026)
| مدل | پارامترها | انکودر بینایی | LLM | کانتکست | نقاط قوت |
|---|---|---|---|---|---|
| Qwen3-VL-235B-A22B (MoE) | 235B (22B فعال) | ViT اختصاصی + DeepStack | Qwen3 | 256K | پیشتاز کلی (SOTA)، ایجنت رابط کاربری (GUI) |
| Qwen3-VL-30B-A3B (MoE) | 30B (3B فعال) | ViT اختصاصی + DeepStack | Qwen3 | 256K | گزینهی سبکترِ MoE |
| Qwen3-VL-8B (متراکم) | 8B | ViT اختصاصی | Qwen3 | 128K | انتخاب پیشفرض متراکم برای پروداکشن |
| InternVL3.5-38B | 38B | InternViT-6B | Qwen3 + GPT-OSS | 128K | عملکرد قوی در MMBench و MMVet |
| InternVL3.5-241B-A28B | 241B (28B فعال) | InternViT-6B | Qwen3 | 128K | رقابتی با GPT-4o |
| LLaVA-Next 72B | 72B | SigLIP | Llama-3 | 32K | باز، فاینتیونینگ آسان |
| GLM-4.6V | حدود 70B | اختصاصی | GLM | 64K | متنباز، فوقالعاده در OCR |
| MiniCPM-V-2.6 | 8B | SigLIP | MiniCPM | 32K | سازگار با محیطهای لبه (Edge) |
ایجنتهای دیداری
مدل Qwen3-VL-235B در OSWorld — بنچمارکی برای ایجنتهای دیداری که با رابطهای گرافیکی (دسکتاپ، موبایل و وب) کار میکنند — به برترین عملکرد جهانی رسیده است. این مدل اسکرینشات را میبیند، رابط کاربری را درک میکند و اکشنها را صادر میکند (کلیک، تایپ، اسکرول). این قابلیت در ترکیب با ابزارها، چرخهی انجام کارهای متداول دسکتاپ را میبندد. اکثر دموهای «کامپیوترهای مجهز به هوش مصنوعی» در سال 2026 در لایهی زیرین دقیقاً با همین سازوکار اجرا میشوند.
قابلیتهای ایجنتی و نسخههای مختلف RoPE
مدلهای VLM برای کار با ویدیو باید بدانند یک فریم دقیقاً چه زمانی رخ داده است. مدل Qwen3-VL از روش T-RoPE (امبدینگ دورانی موقعیت زمانی) فراتر رفته و به همترازی زمانی متنی (Text-based time alignment) رسیده است؛ یعنی توکنهای متنی صریح برچسب زمان بهطور مستقیم لابهلای فریمهای ویدیو قرار میگیرند. مدل ساختاری مانند «<timestamp 00:32> فریم، پرامپت» را مشاهده میکند و میتواند روابط زمانی را تحلیل کند.
مسئلهی همترازی
حدود 12% از جفتهای تصویر-متن در یک دیتاست جمعآوریشده از وب، حاوی توضیحاتی هستند که اصلاً در تصویر وجود ندارند. مدلی که با این دادهها آموزش ببیند، ناخواسته یاد میگیرد توهم بزند — اشیاء خیالی بسازد، اعداد را اشتباه بخواند و روابط ناموجود خلق کند. در محیط پروداکشن، این اصلیترین حالت شکست است.
تیم Skywork.ai برای پایش این مسئله، سنجهی نرخ خطای بینوجهی (Cross-Modal Error Rate یا CMER) را معرفی کرد:
CMER = fraction of outputs where the text confidence is high but the image-text similarity (via a CLIP-family checker) is lowاگر CMER بالا باشد، یعنی مدل با قطعیت زیاد دربارهی چیزهایی حرف میزند که هیچ پایهای در تصویر ندارند. رصد CMER و در نظر گرفتن آن بهعنوان یکی از KPIهای پروداکشن، نرخ توهم را در استقرار آنها حدود 35% کاهش داد. ترفند اصلی «اصلاح مدل» نیست، بلکه «هدایت خروجیهای با CMER بالا به صف بازبینی انسانی» است.
فاینتیونینگ با LoRA و QLoRA
فاینتیونینگ کامل یک مدل 70B برای اکثر تیمها شدنی نیست. با اعمال LoRA (رتبهی 16 تا 64) روی لایههای اتنشن و پروجکتور، یا استفاده از QLoRA با وزنهای پایهی 4 بیتی، کل فرایند روی یک کارت A100 یا H100 جا میشود. هزینهی کار: بین 5,000 تا 50,000 نمونه، 100 تا 5,000 دلار هزینهی محاسباتی، و 2 تا 10 ساعت زمان آموزش.
استدلال فضایی هنوز ضعیف است
مدلهای فعلی VLM در بنچمارکهای استدلال فضایی (بالا-پایین، چپ-راست، شمارش، فاصله) امتیاز 50 تا 60 درصد میگیرند. اگر سناریوی شما به این بستگی دارد که «کدام شیء روی دیگری قرار گرفته»، باید بهشدت آن را اعتبارسنجی کنید؛ عملکرد مدلهای جنریک VLM در این بخش پایینتر از انسان است. جایگزینهای بهتر از VLM برای تسکهای صرفاً فضایی: یک مدل تخصصی تخمین اسکلت/نقاط کلیدی (Pose/Keypoint estimator)، یک مدل تخمین عمق، یا یک مدل تشخیص شیء (Detection) که هندسهی کادرهای مرزی (Bounding boxes) آن پسپردازش شود.
ساخت گامبهگام
مرحلهی 1: ساخت پروجکتور
بخشی که بیشتر از همه آن را آموزش خواهید داد. یک MLP با 2 تا 4 لایه و تابع فعالساز GELU:
import torch
import torch.nn as nn


class Projector(nn.Module):
    def __init__(self, vit_dim=768, llm_dim=4096, hidden=4096):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(vit_dim, hidden),
            nn.GELU(),
            nn.Linear(hidden, llm_dim),
        )

    def forward(self, x):
        return self.net(x)
ورودی یک تنسور توکن با ابعاد (N_patches, d_vit) و خروجی (N_patches, d_llm) است. مدل زبانی با هر ردیف خروجی دقیقاً مثل یک توکن معمولی رفتار میکند.
مرحلهی 2: سرهمبندی سراسری ViT-MLP-LLM
اسکلت گذر رو به جلو (Forward pass) برای یک VLM حداقلی. کدهای واقعی از transformers استفاده میکنند؛ این صرفاً ساختار مفهومی کار است:
class MinimalVLM(nn.Module):
def __init__(self, vit, projector, llm, image_token_id):
super().__init__()
self.vit = vit
self.projector = projector
self.llm = llm
self.image_token_id = image_token_id # placeholder token in text prompt
def forward(self, image, input_ids, attention_mask):
# 1. ویژگیهای بصری
vision_tokens = self.vit(image) # (B, N_patches, d_vit)
vision_embeds = self.projector(vision_tokens) # (B, N_patches, d_llm)
# 2. امبدینگهای متن
text_embeds = self.llm.get_input_embeddings()(input_ids) # (B, M, d_llm)
# 3. جایگزینی توکنهای نگهدارندهی تصویر با امبدینگهای بصری
merged = self._merge(text_embeds, vision_embeds, input_ids)
# 4. اجرای LLM
return self.llm(inputs_embeds=merged, attention_mask=attention_mask)
def _merge(self, text_embeds, vision_embeds, input_ids):
out = text_embeds.clone()
expected = vision_embeds.size(1)
for b in range(input_ids.size(0)):
positions = (input_ids[b] == self.image_token_id).nonzero(as_tuple=True)[0]
if len(positions) != expected:
raise ValueError(
f"batch item {b} has {len(positions)} image tokens but vision_embeds has {expected} patches."
" Every sample in the batch must be pre-padded to the same number of image placeholder tokens.")
out[b, positions] = vision_embeds[b]
return outتوکن نگهدارندهی <image> در متن، با امبدینگهای واقعی تصویر جایگزین میشود؛ همان الگویی که در LLaVA، Qwen-VL و InternVL به کار رفته است.
مرحلهی 3: محاسبهی CMER
یک بررسی سبک در زمان اجرا (Runtime):
import torch.nn.functional as F


def cross_modal_error_rate(image_emb, text_emb, text_confidence, sim_threshold=0.25, conf_threshold=0.8):
    """
    image_emb, text_emb: embeddings of image and generated text (normalised internally)
    text_confidence:     mean per-token probability in [0, 1]
    Returns:             fraction of high-confidence outputs with low image-text alignment
    """
    image_emb = F.normalize(image_emb, dim=-1)
    text_emb = F.normalize(text_emb, dim=-1)
    sim = (image_emb * text_emb).sum(dim=-1)        # cosine similarity
    high_conf_low_sim = (text_confidence > conf_threshold) & (sim < sim_threshold)
    return high_conf_low_sim.float().mean().item()
به CMER به چشم یک KPI پروداکشن نگاه کنید. آن را به تفکیک اندپوینت، نوع پرامپت و مشتری مانیتور کنید. بالا رفتن CMER نشان میدهد که مدل روی توزیع خاصی از ورودیها در حال توهم زدن است.
مرحلهی 4: کلاسیفایر تجربی VLM (قابل اجرا)
این بخش نشان میدهد پروجکتور چگونه آموزش میبیند. «ویژگیهای ساختگی ViT» وارد سیستم میشوند؛ و یک توکن کوچکِ شبیه به LLM کلاس را پیشبینی میکند:
class ToyVLM(nn.Module):
    def __init__(self, vit_dim=32, llm_dim=64, num_classes=5):
        super().__init__()
        self.projector = Projector(vit_dim, llm_dim, hidden=64)
        self.head = nn.Linear(llm_dim, num_classes)

    def forward(self, vision_tokens):
        projected = self.projector(vision_tokens)
        pooled = projected.mean(dim=1)
return self.head(pooled)میتوانید این شبکه را روی جفتهای ساختگی (ویژگی، کلاس) در کمتر از 200 گام فیت کنید؛ این تمرین برای اثبات کارکرد الگوی پروجکتور کافی است.
کاربرد در محیط واقعی
در سال 2026، تیمهای پروداکشن به سه روش از VLMها استفاده میکنند:
- استفاده از APIهای ابری: مثل OpenAI Vision، Anthropic Claude Vision و Google Gemini Vision. زیرساخت صفر، اما همراه با ریسک وابستگی به سرویسدهنده.
- میزبانی متنباز (Self-host): اجرای Qwen3-VL یا InternVL3.5 از طریق
transformersوvllm. کنترل کامل، اما با زحمت اولیهی بیشتر. - فاینتیونینگ روی دامنهی اختصاصی: لود کردن Qwen2.5-VL-7B یا LLaVA-1.6-7B، اعمال LoRA روی 5k تا 50k نمونهی سفارشی، و سرو مدل با
vllmیاTGI.
from transformers import AutoProcessor, AutoModelForVision2Seq
import torch
from PIL import Image

model_id = "Qwen/Qwen3-VL-8B-Instruct"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForVision2Seq.from_pretrained(model_id, torch_dtype=torch.bfloat16, device_map="auto")

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "image": Image.open("plot.png")},
        {"type": "text", "text": "What does this chart show?"},
    ],
}]
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to("cuda")
generated = model.generate(**inputs, max_new_tokens=256)
answer = processor.decode(generated[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
تابع apply_chat_template فرایند توکنایز کردن نگهدارندهی <image> را مدیریت میکند و merge آن در داخل خود مدل انجام میشود.
آمادهسازی برای استقرار
خروجیهای این درس:
outputs/prompt-vlm-selector.md— مدلی برای انتخاب بین Qwen3-VL / InternVL3.5 / LLaVA-Next یا API بر اساس دقت، تاخیر، طول کانتکست و بودجه.outputs/skill-cmer-monitor.md— تولید کد لازم برای تجهیز اندپوینت پروداکشن VLM به سنجهی نرخ خطای بینوجهی، داشبوردهای اختصاصی هر اندپوینت و آستانههای هشدار.
تمرینها
- (ساده) سه پرامپت («این چیست؟»، «اشیاء را بشمار» و «صحنه را توصیف کن») را با یک VLM متنباز روی پنج تصویر اجرا کنید. هر پاسخ را دستی با برچسبهای درست / تا حدی درست / همراه با توهم نمرهدهی کنید. یک نرخ اولیه شبیه به CMER برای آن محاسبه کنید.
- (متوسط) مدل Qwen2.5-VL-3B یا LLaVA-1.6-7B را با LoRA (رتبهی 16) روی 500 تصویر حوزهی هدف همراه با کپشنها فاینتیون کنید. دقت آن را در حالت زیروشات با مدل فاینتیونشده در بنچمارکی شبیه MMBench مقایسه کنید.
- (پیشرفته) انکودر تصویر مدل را بردارید و DINOv3 را به جای گزینهی پیشفرض SigLIP/CLIP بگذارید. فقط پروجکتور را دوباره آموزش دهید (در حالی که LLM و DINOv3 فریز هستند). بسنجید که آیا تسکهای پیشبینی متراکم (شمارش، استدلال فضایی) بهتر شدهاند یا خیر.
اصطلاحات کلیدی
| اصطلاح | اصطلاح رایج | معنای فنی دقیق |
|---|---|---|
| ViT-MLP-LLM | «الگوی VLM» | انکودر بینایی + پروجکتور + مدل زبانی؛ معماری تمام VLMهای سال 2026 |
| پروجکتور (Projector) | «پل ارتباطی» | یک MLP با 2 تا 4 لایه (یا Q-former) که توکنهای بینایی را به فضای امبدینگ LLM تصویر میکند |
| DeepStack | «ترفند لایهای Qwen3-VL» | انباشتن ویژگیهای سطوح مختلف ViT روی هم، به جای استفاده از تکلایهی آخر |
| توکن تصویر (Image token) | «نگهدارندهی <image>» | توکن ویژهای در جریان متن که با امبدینگهای تصویرشدهی بینایی جایگزین میشود |
| CMER | «شاخص توهم» | نرخ خطای بینوجهی؛ زمانی بالا میرود که اطمینان متن بالاست اما شباهت تصویر و متن پایین است |
| ایجنت دیداری (Visual agent) | «VLM کلیککننده» | VLMای که رابطهای کاربری (OSWorld، موبایل، وب) را از طریق فراخوانی ابزارها مدیریت میکند |
| کیو-فورمر (Q-former) | «پل توکن با تعداد ثابت» | پروجکتوری با ساختار BLIP-2 که تعداد ثابتی توکن پرسوجوی دیداری تولید میکند |
| همترازی / پیشآموزش / تنظیم دستورالعملها | «مراحل سهگانه» | پایپلاین استاندارد آموزش VLM |