
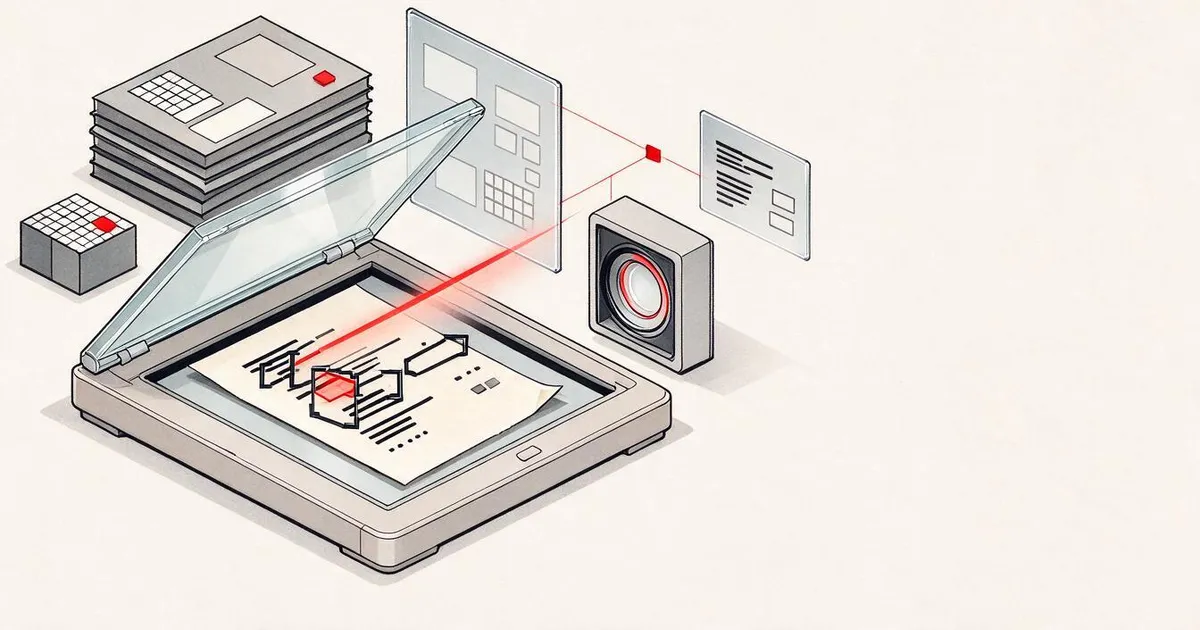
استخراج اطلاعات از تصاویر اسناد، فاکتورها، رسیدها و مدارک شناسایی یکی از پرتقاضاترین وظایف مهندسی هوش مصنوعی است. تفاوت بزرگی میان استخراج سادهی نویسهها از روی تصویر و درک ساختار مفهومی آن — مانند خواندن مبلغ نهایی یک فاکتور — وجود دارد که اغلب تیمهای فنی در شروع کار آن را نادیده میگیرند.
در این درس پایپلاین سنتی OCR (شامل تشخیص، بازشناسی و بازسازی چیدمان) را در کنار مدلهای نوین سرتاسری بررسی میکنیم. همچنین با پیادهسازی عملی معماری پایدار CRNN و تابع زیان CTC، مکانیسم تبدیل ویژگیهای تصویری به توالی کاراکترها بدون نیاز به برچسبگذاری جزئی را یاد میگیرید.
اگر برای دانلود مدلهای حجیم بینایی-زبانی یا نصب پکیجهایی مانند PaddleOCR با اختلال در مخازن روبهرو شدید، بهرهگیری از میرورهای محلی PyPI و اجرای اولیهی مدل روی CPU یا پردازندههای سازگار میتواند فرآیند تست را بسیار سریعتر کند.
نویسهخوان نوری یا OCR یک پایپلاین سهمرحلهای است: تشخیص کادرهای متنی، بازشناسی نویسهها و سپس چیدمان آنها. تمام سیستمهای مدرن OCR این مراحل را بازآرایی میکنند یا در یکدیگر ادغام (merge) مینمایند.
اهداف یادگیری
- بررسی پایپلاین کلاسیک OCR (تشخیص -> بازشناسی -> چیدمان) و جایگزینهای سرتاسری و مدرن (Donut و Qwen-VL-OCR)
- پیادهسازی تابع زیان (loss) مدل CTC (دستهبندی زمانی پیوندگرا یا Connectionist Temporal Classification) برای آموزش توالیبهتوالی OCR
- استفاده از PaddleOCR یا EasyOCR برای پارس اسناد در محیط پروداکشن بدون نیاز به آموزش
- تفکیک OCR، تحلیل چیدمان و درک سند؛ و انتخاب ابزار مناسب برای هر کار
صورت مسئله
تصاویر پر از متن همهجا هستند: رسیدها، فاکتورها، کارتهای شناسایی، کتابهای اسکنشده، فرمها، وایتبردها، تابلوها و اسکرینشاتها. استخراج دادههای ساختیافته از آنها — نه فقط خواندن نویسهها، بلکه فهمیدن اینکه «این مقدار، مبلغ کل است» — یکی از باارزشترین مسائل کاربردی در بینایی ماشین به شمار میرود.
این حوزه به سه لایهی مهارتی تقسیم میشود:
- خودِ OCR: تبدیل پیکسلها به متن.
- تحلیل چیدمان (Layout parsing): گروهبندی خروجی OCR در قالب بخشهای مختلف (عنوان، بدنه، جدول، سربرگ).
- درک سند (Document understanding): استخراج فیلدهای ساختیافته (مثل «
invoice_total = $42.50») از دل چیدمان متن.
هر لایه رویکردهای کلاسیک و مدرن خودش را دارد؛ فاصلهی میان «میخواهم متن را از تصویر استخراج کنم» تا «به مبلغ کل این رسید نیاز دارم» بسیار بیشتر از آن چیزی است که بیشتر تیمها تصور میکنند.
مفاهیم پایه
پایپلاین کلاسیک
- تشخیص متن (Text detection) چهارضلعیهای مربوط به هر خط یا کلمه را استخراج میکند.
- بازشناسی (Recognition) هر بخش را به ارتفاعی ثابت برش میزند و با اجرای CNN + BiLSTM + CTC، توالی نویسهها را میسازد.
- چیدمان (Layout) ترتیب خوانش متن را بازسازی میکند (از بالا به پایین و چپ به راست برای خط لاتین؛ و متفاوت برای خطوطی مثل عربی یا ژاپنی).
CTC در یک پاراگراف
بخش بازشناسی OCR، از یک نقشهی ویژگی با طول ثابت، توالی متغیری از نویسهها تولید میکند. روش CTC (گریوز و همکاران، 2006) به شما امکان میدهد این مدل را بدون نیاز به ترازسازی (alignment) در سطح نویسه آموزش دهید. مدل در هر گام زمانی، توزیع احتمالی روی (واژگان + نویسهی خالی یا blank) ارائه میدهد؛ سپس تابع زیان (loss) مدل CTC تمام ترازهایی را که پس از ادغام نویسههای تکراری و حذف جاهای خالی به متن هدف تبدیل میشوند، تجمیع آماری (marginalise) میکند.
raw output: "h h h _ _ e e l l _ l l o _ _"
after merge repeats and remove blanks: "hello"
همین CTC دلیل موفقیت معماری CRNN در سال 2015 بود و هنوز هم در سال 2026 پایهی آموزش بیشتر مدلهای پروداکشن OCR به شمار میرود.
مدلهای سرتاسری مدرن
- Donut (کیم و همکاران، 2022) — ترکیبی از یک انکودر ViT و یک دکودر متنی؛ تصویر را میخواند و مستقیماً JSON برمیگرداند. نیازی به ماژول جداگانهی تشخیص متن یا چیدمان ندارد.
- TrOCR — ترکیب ViT با دکودر ترنسفورمر برای OCR در سطح خطوط متن.
- Qwen-VL-OCR / InternVL — مدلهای زبانیدیداری کامل (VLM) که برای کارهای OCR فاینتیون شدهاند؛ بالاترین دقت سال 2026 را روی اسناد پیچیده دارند.
- PaddleOCR — پایپلاین کلاسیک DB + CRNN در قالب بستهای پایدار و آمادهی پروداکشن؛ همچنان ابزار اصلی و پرکاربرد دنیای متنباز.
مدلهای سرتاسری به داده و توان پردازشی بیشتری نیاز دارند، اما در عوض گرفتار تجمع خطاهای پایپلاینهای چندمرحلهای نمیشوند.
تحلیل چیدمان
برای اسناد ساختیافته، یک مدل چیدمان (مثل LayoutLMv3 یا آشکارسازی که روی مجموعهدادهی DocLayNet آموزش دیده) اجرا میکنید تا به هر بخش برچسب بزند: عنوان، پاراگراف، تصویر، جدول یا پانویس. ترتیب خوانش سند هم در ادامه به سادگی تبدیل میشود به «پیمایش بخشها به ترتیب چیدمان و الحاق متن آنها».
برای فرمها، سراغ مدلهای استخراج کلید-مقدار (Key-Value extraction) بروید (Donut برای اسناد غنی از تصویر، و LayoutLMv3 برای اسکنهای متنی ساده). این مدلها تصویر، متن شناساییشده و موقعیت کلمات را میگیرند و جفتهای کلید-مقدار ساختیافته را تحویل میدهند.
معیارهای ارزیابی
- نرخ خطای نویسه (CER) — فاصلهی لوناشتاین تقسیم بر طول متن مرجع. هرچه کمتر باشد بهتر است. هدف پروداکشن: کمتر از 2% روی اسکنهای تمیز.
- نرخ خطای کلمه (WER) — همان مفهوم در سطح کلمات.
- امتیاز F1 روی فیلدهای ساختیافته — برای وظایف استخراج کلید-مقدار؛ بررسی میکند که آیا مثلاً
{invoice_total: 42.50}درست استخراج شده است یا خیر. - فاصلهی ویرایشی روی JSON — برای پارس سرتاسری اسناد؛ مقالهی Donut مفهوم فاصلهی ویرایشی درختیِ نرمالشده را برای این کار معرفی کرد.
پیادهسازی عملی
گام 1: تابع زیان CTC بههمراه دکودر حریصانه
import torch
import torch.nn as nn
import torch.nn.functional as F


def ctc_loss(log_probs, targets, input_lengths, target_lengths, blank=0):
    """
    log_probs:      (T, N, C) log-softmax over vocab including blank at index 0
    targets:        (N, S) int targets (no blanks)
    input_lengths:  (N,) per-sample time steps used
    target_lengths: (N,) per-sample target length
    """
    return F.ctc_loss(log_probs, targets, input_lengths, target_lengths,
                      blank=blank, reduction="mean", zero_infinity=True)


def greedy_ctc_decode(log_probs, blank=0):
    """
    log_probs: (T, N, C) log-softmax
    returns: list of index sequences (blanks removed, repeats merged)
    """
    preds = log_probs.argmax(dim=-1).transpose(0, 1).cpu().tolist()
    out = []
    for seq in preds:
        decoded = []
        prev = None
        for idx in seq:
            if idx != prev and idx != blank:
                decoded.append(idx)
            prev = idx
        out.append(decoded)
    return out
تابع F.ctc_loss در صورت در دسترس بودن، از پیادهسازی بهینهی CuDNN استفاده میکند. دکودر حریصانه بسیار سادهتر از جستجوی پرتو (beam search) است و معمولاً اختلاف CER آن با جستجوی پرتو کمتر از 1% است.
گام 2: بازشناس کوچک CRNN
یک ترکیب مینیمال از CNN + BiLSTM برای OCR در سطح خطوط متن.
class TinyCRNN(nn.Module):
    def __init__(self, vocab_size=40, hidden=128, feat=32):
        super().__init__()
        self.cnn = nn.Sequential(
            nn.Conv2d(1, feat, 3, 1, 1), nn.BatchNorm2d(feat), nn.ReLU(inplace=True),
            nn.MaxPool2d(2),
            nn.Conv2d(feat, feat * 2, 3, 1, 1), nn.BatchNorm2d(feat * 2), nn.ReLU(inplace=True),
            nn.MaxPool2d(2),
            nn.Conv2d(feat * 2, feat * 4, 3, 1, 1), nn.BatchNorm2d(feat * 4), nn.ReLU(inplace=True),
            nn.MaxPool2d((2, 1)),
            nn.Conv2d(feat * 4, feat * 4, 3, 1, 1), nn.BatchNorm2d(feat * 4), nn.ReLU(inplace=True),
            nn.MaxPool2d((2, 1)),
        )
        self.rnn = nn.LSTM(feat * 4, hidden, bidirectional=True, batch_first=True)
        self.head = nn.Linear(hidden * 2, vocab_size)

    def forward(self, x):
        # x: (N, 1, H, W)
        f = self.cnn(x)                # (N, C, H', W')
        f = f.mean(dim=2).transpose(1, 2)  # (N, W', C)
        h, _ = self.rnn(f)
        return F.log_softmax(self.head(h).transpose(0, 1), dim=-1)  # (W', N, vocab)
ورودی ارتفاع ثابتی دارد (لایه CNN با max-pooling ارتفاع را به 1 میرساند). عرض تصویر همان بعد زمان برای الگوریتم CTC است.
گام 3: ساخت دادههای مصنوعی برای OCR
رشتههایی با متن مشکی روی پسزمینهی سفید میسازیم تا یک تست صحتسنجی (smoke test) سرتاسری اجرا کنیم. هر نویسه به ستونی از شش نوار تبدیل میشود که ایندکس واژگانی آن را به صورت باینری نمایش میدهد. تصویر باید هویت نویسه را به دوش بکشد؛ اگر همهی نویسهها شبیه یک کادر خالی بودند، مدل نمیتوانست a را از x تشخیص دهد و کاهش تابع زیان (loss) متوقف میشد.
import numpy as np

GLYPHS = "0123456789abcdefghijklmnopqrstuvwxyz"

def synthetic_line(text, height=32, char_width=16):
    W = char_width * len(text)
    img = np.ones((height, W), dtype=np.float32)
    for i, c in enumerate(text):
        x = i * char_width
        code = GLYPHS.find(c) + 1
        for bit in range(6):
            if code >> bit & 1:
                y = 4 + 4 * bit
                img[y:y + 3, x + 2:x + char_width - 2] = 0.0
    return img


def build_batch(strings, vocab):
    H = 32
    W = 16 * max(len(s) for s in strings)
    imgs = np.ones((len(strings), 1, H, W), dtype=np.float32)
    target_lengths = []
    targets = []
    for i, s in enumerate(strings):
        imgs[i, 0, :, :16 * len(s)] = synthetic_line(s)
        ids = [vocab.index(c) for c in s]
        targets.extend(ids)
        target_lengths.append(len(ids))
    return torch.from_numpy(imgs), torch.tensor(targets), torch.tensor(target_lengths)


vocab = ["_"] + list("0123456789abcdefghijklmnopqrstuvwxyz")
imgs, targets, lengths = build_batch(["hello", "world"], vocab)
print(f"images: {imgs.shape}   targets: {targets.shape}   lengths: {lengths.tolist()}")
یک مجموعهدادهی واقعی OCR تنوع فونت، نویز، چرخش، تاری و رنگ را اضافه میکند، ولی ساختار پایپلاین دقیقاً به همین شکل باقی میماند.
گام 4: طرح کلی آموزش
model = TinyCRNN(vocab_size=len(vocab))
opt = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(400):
    strings = ["abc" + str(step % 10)] * 4 + ["xyz" + str((step + 1) % 10)] * 4
    imgs, targets, target_lens = build_batch(strings, vocab)
    log_probs = model(imgs)  # (W', 8, vocab)
    input_lens = torch.full((8,), log_probs.size(0), dtype=torch.long)
    loss = ctc_loss(log_probs, targets, input_lens, target_lens, blank=0)
    opt.zero_grad(); loss.backward(); opt.step()
روی این دادههای سادهی ساختگی، مقدار تابع زیان (loss) باید طی 400 گام از اعداد دو رقمی به حدود 0.3 برسد. فایل code/main.py همین حلقه را روی مجموعهی رشتههای خود اجرا میکند و در پایان سه رشتهی آزمایشی را دکود مینماید.
استفاده از ابزارهای آماده
سه راهکار پروداکشن پیش رو دارید:
- PaddleOCR — بالغ، سریع و چندزبانه. استفاده در یک خط کد:
paddleocr.PaddleOCR(lang="en").ocr(image_path). - EasyOCR — ابزاری مبتنی بر پایتون و PyTorch، با پشتیبانی از زبانهای گوناگون.
- Tesseract — ابزاری کلاسیک؛ همچنان برای اسناد اسکنشدهی قدیمی که مدلهای امروزی رویشان به مشکل میخورند، نجاتبخش است.
برای پارس سرتاسری اسناد، از Donut یا یک VLM استفاده کنید:
from transformers import DonutProcessor, VisionEncoderDecoderModel

processor = DonutProcessor.from_pretrained("naver-clova-ix/donut-base-finetuned-cord-v2")
model = VisionEncoderDecoderModel.from_pretrained("naver-clova-ix/donut-base-finetuned-cord-v2")
برای رسیدها، فاکتورها و فرمهایی با ساختار تکرارشونده، Donut را فاینتیون کنید. برای اسناد متفرقه یا مواردی از OCR که نیاز به تحلیل و استدلال دارند، یک VLM مانند Qwen-VL-OCR گزینهی پیشفرض امروزی است.
خروجی این درس
از این درس خروجیهای زیر به دست میآید:
outputs/prompt-ocr-stack-picker.md— پرامپتی که بر اساس نوع سند، زبان و ساختار آن، ابزار مناسب را از بین Tesseract ،PaddleOCR ،Donut یا VLM-OCR انتخاب میکند.outputs/skill-ctc-decoder.md— مهارتی برای پیادهسازی دکودرهای CTC حریصانه و beam search از صفر، همراه با نرمالسازی طول.
تمرینها
- (ساده) مدل TinyCRNN را روی رشتههای عددی تصادفی 5 رقمی به مدت 500 گام آموزش دهید. نرخ خطای نویسه (CER) را روی دادههای آزمون مجزا گزارش کنید.
- (متوسط) دکودر حریصانه را با جستجوی پرتو (با beam_width=5) جایگزین کنید. میزان تغییر CER را گزارش دهید. جستجوی پرتو روی چه نوع ورودیهایی نتیجهی بهتری میدهد؟
- (سخت) با استفاده از PaddleOCR روی مجموعهای از 20 رسید، اقلام فاکتور را استخراج کنید و امتیاز F1 را برای جفتهای {item_name, price} در مقایسه با دادههای مرجع برچسبگذاریشدهی دستی به دست آورید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| OCR | «استخراج متن از پیکسلها» | تبدیل بخشهایی از تصویر به توالی نویسهها |
| CTC | «تابع زیانِ بدون نیاز به ترازسازی» | تابع زیانی (loss) که مدل توالی را بدون برچسبگذاری در هر گام زمانی آموزش میدهد؛ محاسبات را روی تمام ترازهای ممکن جمعبندی حاشیهای میکند |
| CRNN | «مدل کلاسیک OCR» | استخراجکنندهی ویژگی کانولوشنی + BiLSTM + لایهی CTC؛ معماری پایهی سال 2015 که هنوز در پروداکشن کاربرد دارد |
| Donut | «OCR سرتاسری» | انکودر ViT + دکودر متنی؛ ساختار JSON را مستقیماً از روی تصویر استخراج میکند |
| تحلیل چیدمان | «یافتن بخشها» | تشخیص و برچسبگذاری بخشهای عنوان، جدول، تصویر و پاراگراف در سند |
| ترتیب خوانش | «توالی متن» | مرتبسازی بخشهای شناساییشده در قالب جملات پیوسته؛ در خط لاتین ساده است اما در چیدمانهای ترکیبی چالش دارد |
| CER / WER | «نرخهای خطا» | فاصلهی لوناشتاین تقسیم بر طول مرجع، در سطح نویسه یا کلمه |
| VLM-OCR | «مدل زبانی تصویرخوان» | مدل دیداریزبانی که برای وظایف OCR آموزش دیده یا پرامپت شده است؛ بهترین راهکار فعلی روی اسناد پیچیده |
برای مطالعهی بیشتر
- مقالهی CRNN (شی و همکاران، 2015) — معماری اولیهی CNN+RNN+CTC
- مقالهی CTC (گریوز و همکاران، 2006) — مقالهی اصلی CTC؛ سرشار از ایدههای الگوریتمی عمیق
- مقالهی Donut (کیم و همکاران، 2022) — ترنسفورمر درک سند بدون نیاز به OCR
- PaddleOCR — پایپلاین متنباز و آمادهی پروداکشن OCR