
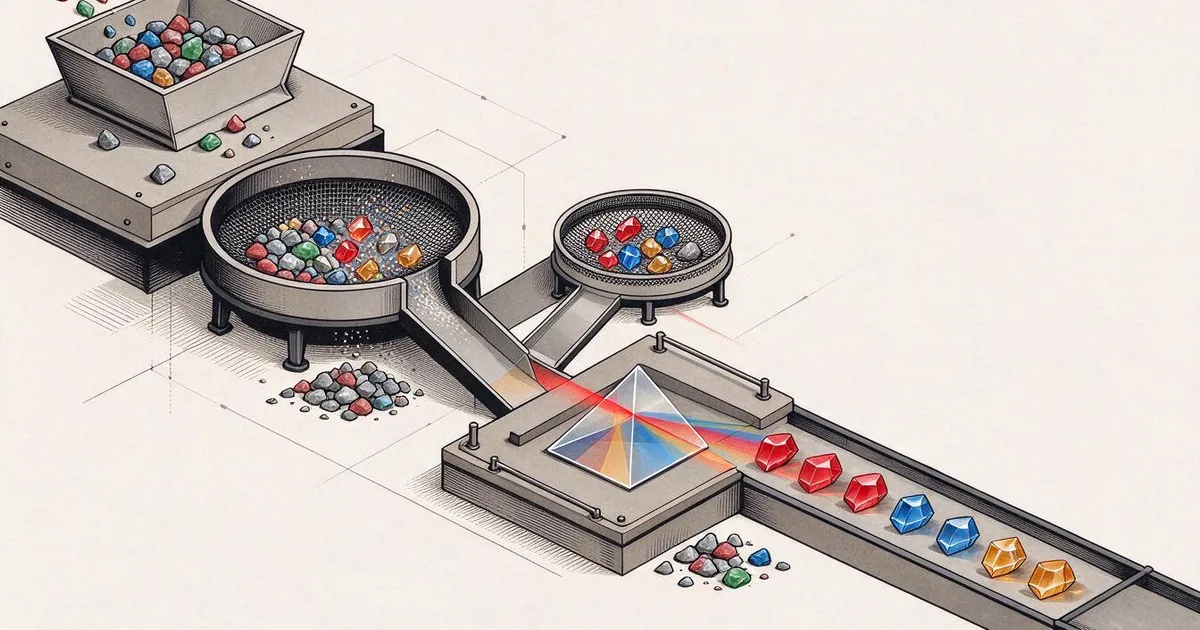
خیلی اوقات پس از ساخت یک مدل یادگیری ماشین، نتیجه مطلوب نیست و ساعتها زمان صرف تغییر الگوریتم یا دستکاری هایپرپارامترها میشود؛ اما دقت مدل بهسختی چند دهم درصد تغییر میکند. واقعیت این است که در یادگیری ماشین کلاسیک، شکل و کیفیت ورودی دادهها بسیار تعیینکنندهتر از پیچیدگی الگوریتم است.
مهندسی ویژگی (Feature Engineering) به شما کمک میکند دادههای خام را به قالبهای ریاضی معناداری تبدیل کنید که الگوریتم بتواند الگوهای پنهان آنها را بخواند. در طرف مقابل، با انتخاب ویژگی (Feature Selection) ستونهای اضافی و نویزدار حذف میشوند تا مدل بدون افتادن در دام بیشبرازش، سریعتر و دقیقتر آموزش ببیند.
تمام کدهای این درس کاملاً روی سیستم شخصی، CPU و ابزارهای استانداردی مثل Python و scikit-learn اجرا میشوند و نیازی به GPU یا ابزارهای ابری پردازشی نخواهید داشت.
یک ویژگی خوب، ارزش هزار نقطهداده را دارد.
اهداف یادگیری
- پیادهسازی تبدیلهای عددی (استانداردسازی، مقیاسبندی کمینه-بیشینه، تبدیل لگاریتمی، دستهبندی بازهای) و توضیح زمان مناسب برای هرکدام
- ساخت کدگذاری وانهات، برچسبی و هدفی برای ویژگیهای دستهای و شناسایی خطر نشت داده (Data Leakage) در کدگذاری هدفی
- ساخت یک بردارساز TF-IDF از صفر و بیان دلیل برتری آن نسبت به شمارش خام کلمات در دستهبندی متن
- بهکارگیری روشهای پالایشی انتخاب ویژگی (آستانهی واریانس، همبستگی، اطلاعات متقابل) برای کاهش ابعاد
صورت مسئله
مجموعهدادهای دارید. الگوریتمی انتخاب میکنید. مدل را آموزش میدهید، اما نتایج معمولی از آب درمیآیند. سراغ الگوریتم پیچیدهتری میروید؛ باز هم چنگی به دل نمیزند. یک هفته وقت صرف تنظیم هایپرپارامترها میکنید، اما پیشرفت ناچیز است.
سپس کسی دادههای خام را به ویژگیهای بهتری تبدیل میکند و ناگهان یک رگرسیون لجستیک ساده، مدل گروهی تقویت گرادیان (gradient-boosted ensemble) تنظیمشدهی شما را شکست میدهد.
این اتفاق مدام میافتد. در یادگیری ماشین کلاسیک، نحوهی نمایش دادهها بسیار مهمتر از انتخاب الگوریتم است. مدل قیمت مسکنی با متغیرهای «متراژ» و «تعداد اتاق خواب»، بر مدلی با «آدرس بهصورت رشتهی متنی خام» پیروز میشود؛ فرقی هم نمیکند الگوریتم یادگیری چقدر پیشرفته باشد. الگوریتم فقط میتواند با همان چیزی کار کند که تحویلش میدهید.
مهندسی ویژگی (Feature Engineering) فرآیند تبدیل دادههای خام به قالبهایی است که یافتن الگوها را برای مدلها سادهتر میکنند. انتخاب ویژگی (Feature Selection) یعنی دور ریختن ویژگیهایی که بدون افزودن سیگنال، فقط نویز اضافه میکنند. این دو در کنار هم، پربازدهترین فعالیت در یادگیری ماشین کلاسیک هستند.
مفهوم
خط لولهی ویژگی
ویژگیهای عددی
اعداد خام بهندرت آمادهی ورود به مدل هستند. تبدیلهای رایج عبارتاند از:
مقیاسبندی (Scaling): قرار دادن ویژگیها در یک بازهی یکسان تا الگوریتمهای مبتنی بر فاصله (K-Means ،KNN ،SVM) وزن برابری برای همهی ویژگیها قائل شوند. مقیاسبندی کمینه-بیشینه (Min-max scaling) دادهها را به بازهی [0, 1] میبرد. استانداردسازی یا نمرهی استاندارد (z-score) میانگین را به 0 و انحراف معیار را به 1 تبدیل میکند.
تبدیل لگاریتمی (Log transform): توزیعهای دارای چولگی به راست (درآمد، جمعیت، شمارش کلمات) را فشرده میکند و روابط ضربی را به جمعی تبدیل میسازد.
دستهبندی بازهای (Binning): تبدیل مقادیر پیوسته به دستهها. زمانی به کار میآید که رابطهی بین ویژگی و متغیر هدف غیرخطی اما پلهای باشد (مثلاً گروههای سنی).
ویژگیهای چندجملهای (Polynomial features): جملات ، و را میسازد. این کار به مدلهای خطی اجازه میدهد روابط غیرخطی را به قیمت افزایش تعداد ویژگیها به تصویر بکشند.
ویژگیهای دستهای
مدلها عدد میفهمند؛ بنابراین دستهها باید کدگذاری (Encoding) شوند.
کدگذاری وانهات (One-hot encoding): برای هر دسته یک ستون باینری میسازد. مثلاً «color = red/blue/green» به سه ستون is_green ،is_blue ،is_red تبدیل میشود. برای ویژگیهایی با تعداد دستههای محدود (low-cardinality) عالی کار میکند، اما با افزایش تعداد دستهها، ابعاد بهشدت بالا میرود.
کدگذاری برچسبی (Label encoding): هر دسته را به یک عدد صحیح نگاشت میکند: red=0 ،blue=1 ،green=2. این کار یک ترتیب ساختگی به دادهها تحمیل میکند (ممکن است مدل تصور کند green > blue > red). این روش فقط برای مدلهای مبتنی بر درخت مناسب است که روی مقادیر مجزا شاخهبندی میکنند.
کدگذاری هدفی (Target encoding): هر دسته را با میانگین متغیر هدف برای همان دسته جایگزین میکند. روشی قدرتمند اما خطرناک با ریسک بالای نشت داده. این محاسبات باید فقط روی دادههای آموزش انجام شود و سپس نتیجه روی دادههای آزمون اعمال گردد.
ویژگیهای متنی
بردارساز شمارشی (Count vectorizer): تعداد دفعات تکرار هر کلمه در سند را میشمارد. مثلاً عبارت «the cat sat on the mat» تبدیل میشود به {the: 2, cat: 1, sat: 1, on: 1, mat: 1}.
معیار TF-IDF: مخفف Term Frequency-Inverse Document Frequency. به کلمات بر اساس میزان متمایز بودنشان در کل اسناد وزن میدهد. کلمات متداول مانند «the» وزن پایینی میگیرند و کلمات نادر و کلیدی، وزن بالایی دریافت میکنند.
مقادیر گمشده
دادههای واقعی پر از جای خالی هستند. استراتژیهای برخورد با آنها:
- حذف ردیفها: فقط زمانی که دادههای گمشده اندک و کاملاً تصادفی باشند.
- جایگزینی با میانگین/میانه (Mean/median imputation): روشی ساده است که مرکز ویژگی را حفظ میکند (میانه در برابر دادههای پرت مقاومتر است)، اما واریانس را کاهش میدهد و همهی مقادیر پرشده را روی یک نقطه متمرکز میکند؛ بنابراین شکل توزیع تغییر مییابد.
- جایگزینی با مد (Mode imputation): برای ویژگیهای دستهای.
- ستون نشانگر (Indicator column): قبل از پر کردن جای خالی، یک ستون باینری به نام «was_this_missing» اضافه کنید؛ خودِ نبود داده میتواند حاوی اطلاعات معناداری باشد.
- تکمیل رو به جلو/عقب (Forward/backward fill): برای دادههای سری زمانی.
تعامل ویژگیها
گاهی اوقات رابطه در ترکیب متغیرها نهفته است. «قد» و «وزن» بهتنهایی قدرت پیشبینی کمتری نسبت به دارند. تعامل ویژگیها ابعاد فضا را چندبرابر میکند؛ پس برای انتخاب موارد مناسب باید از دانش دامنه (Domain knowledge) کمک بگیرید.
انتخاب ویژگی
ویژگیهای بیشتر همیشه بهتر نیست. متغیرهای نامربوط نویز اضافه میکنند، زمان آموزش را بالا میبرند و میتوانند باعث بیشبرازش (Overfitting) شوند.
روشهای پالایشی یا Filter (پیش از برازش مدل):
- همبستگی: حذف ویژگیهایی با همبستگی بالا با یکدیگر (افزونگی داده)
- اطلاعات متقابل (Mutual Information): سنجش اینکه دانستن یک ویژگی چقدر عدمقطعیت دربارهی متغیر هدف را کاهش میدهد
- آستانهی واریانس: حذف ویژگیهایی با تغییرات بسیار ناچیز
روشهای پوششی یا Wrapper (مبتنی بر مدل):
- منظمسازی L1 (روش Lasso): وزن ویژگیهای نامربوط را دقیقاً به صفر میرساند
- حذف بازگشتی ویژگی (RFE): آموزش مدل، حذف کماهمیتترین ویژگی و تکرار این چرخه
چرا انتخاب ویژگی اهمیت دارد: مدلی با 10 ویژگی خوب معمولاً عملکرد بهتری نسبت به مدلی با 10 ویژگی خوب و 90 ویژگی نویزدار ثبت میکند. ویژگیهای نویزدار دست مدل را برای بیشبرازش روی الگوهای غیرقابلتعمیم دادههای آموزش باز میگذارند.
پیادهسازی از صفر
مرحلهی 1: تبدیلهای عددی از صفر
import math


def min_max_scale(values):
    min_val = min(values)
    max_val = max(values)
    if max_val == min_val:
        return [0.0] * len(values)
    return [(v - min_val) / (max_val - min_val) for v in values]


def standardize(values):
    n = len(values)
    mean = sum(values) / n
    variance = sum((v - mean) ** 2 for v in values) / n
    std = math.sqrt(variance) if variance > 0 else 1.0
    return [(v - mean) / std for v in values]


def log_transform(values):
    return [math.log(v + 1) for v in values]


def bin_values(values, n_bins=5):
    min_val = min(values)
    max_val = max(values)
    bin_width = (max_val - min_val) / n_bins
    if bin_width == 0:
        return [0] * len(values)
    result = []
    for v in values:
        bin_idx = int((v - min_val) / bin_width)
        bin_idx = min(bin_idx, n_bins - 1)
        result.append(bin_idx)
    return result


def polynomial_features(row, degree=2):
    n = len(row)
    result = list(row)
    if degree >= 2:
        for i in range(n):
            result.append(row[i] ** 2)
        for i in range(n):
            for j in range(i + 1, n):
                result.append(row[i] * row[j])
return resultمرحلهی 2: کدگذاری دستهای از صفر
def one_hot_encode(values):
    categories = sorted(set(values))
    cat_to_idx = {cat: i for i, cat in enumerate(categories)}
    n_cats = len(categories)

    encoded = []
    for v in values:
        row = [0] * n_cats
        row[cat_to_idx[v]] = 1
        encoded.append(row)

    return encoded, categories


def label_encode(values):
    categories = sorted(set(values))
    cat_to_int = {cat: i for i, cat in enumerate(categories)}
    return [cat_to_int[v] for v in values], cat_to_int


def target_encode(feature_values, target_values, smoothing=10):
    global_mean = sum(target_values) / len(target_values)

    category_stats = {}
    for feat, target in zip(feature_values, target_values):
        if feat not in category_stats:
            category_stats[feat] = {"sum": 0.0, "count": 0}
        category_stats[feat]["sum"] += target
        category_stats[feat]["count"] += 1

    encoding = {}
    for cat, stats in category_stats.items():
        cat_mean = stats["sum"] / stats["count"]
        weight = stats["count"] / (stats["count"] + smoothing)
        encoding[cat] = weight * cat_mean + (1 - weight) * global_mean

return [encoding[v] for v in feature_values], encodingمرحلهی 3: ویژگیهای متنی از صفر
def count_vectorize(documents):
    vocab = {}
    idx = 0
    for doc in documents:
        for word in doc.lower().split():
            if word not in vocab:
                vocab[word] = idx
                idx += 1

    vectors = []
    for doc in documents:
        vec = [0] * len(vocab)
        for word in doc.lower().split():
            vec[vocab[word]] += 1
        vectors.append(vec)

    return vectors, vocab


def tfidf(documents):
    n_docs = len(documents)

    vocab = {}
    idx = 0
    for doc in documents:
        for word in doc.lower().split():
            if word not in vocab:
                vocab[word] = idx
                idx += 1

    doc_freq = {}
    for doc in documents:
        seen = set()
        for word in doc.lower().split():
            if word not in seen:
                doc_freq[word] = doc_freq.get(word, 0) + 1
                seen.add(word)

    vectors = []
    for doc in documents:
        words = doc.lower().split()
        word_count = len(words)
        tf_map = {}
        for word in words:
            tf_map[word] = tf_map.get(word, 0) + 1

        vec = [0.0] * len(vocab)
        for word, count in tf_map.items():
            tf = count / word_count
            idf = math.log(n_docs / doc_freq[word])
            vec[vocab[word]] = tf * idf
        vectors.append(vec)

return vectors, vocabمرحلهی 4: جایگزینی مقادیر گمشده از صفر
def impute_mean(values):
    present = [v for v in values if v is not None]
    if not present:
        return [0.0] * len(values), 0.0
    mean = sum(present) / len(present)
    return [v if v is not None else mean for v in values], mean


def impute_median(values):
    present = sorted(v for v in values if v is not None)
    if not present:
        return [0.0] * len(values), 0.0
    n = len(present)
    if n % 2 == 0:
        median = (present[n // 2 - 1] + present[n // 2]) / 2
    else:
        median = present[n // 2]
    return [v if v is not None else median for v in values], median


def impute_mode(values):
    present = [v for v in values if v is not None]
    if not present:
        return values, None
    counts = {}
    for v in present:
        counts[v] = counts.get(v, 0) + 1
    mode = max(counts, key=counts.get)
    return [v if v is not None else mode for v in values], mode


def add_missing_indicator(values):
return [0 if v is not None else 1 for v in values]مرحلهی 5: انتخاب ویژگی از صفر
def correlation(x, y):
    n = len(x)
    mean_x = sum(x) / n
    mean_y = sum(y) / n
    cov = sum((xi - mean_x) * (yi - mean_y) for xi, yi in zip(x, y)) / n
    std_x = math.sqrt(sum((xi - mean_x) ** 2 for xi in x) / n)
    std_y = math.sqrt(sum((yi - mean_y) ** 2 for yi in y) / n)
    if std_x == 0 or std_y == 0:
        return 0.0
    return cov / (std_x * std_y)


def mutual_information(feature, target, n_bins=10):
    feat_min = min(feature)
    feat_max = max(feature)
    bin_width = (feat_max - feat_min) / n_bins if feat_max != feat_min else 1.0
    feat_binned = [
        min(int((f - feat_min) / bin_width), n_bins - 1) for f in feature
    ]

    n = len(feature)
    target_classes = sorted(set(target))

    feat_bins = sorted(set(feat_binned))
    p_feat = {}
    for b in feat_bins:
        p_feat[b] = feat_binned.count(b) / n

    p_target = {}
    for t in target_classes:
        p_target[t] = target.count(t) / n

    mi = 0.0
    for b in feat_bins:
        for t in target_classes:
            joint_count = sum(
                1 for fb, tv in zip(feat_binned, target) if fb == b and tv == t
            )
            p_joint = joint_count / n
            if p_joint > 0:
                mi += p_joint * math.log(p_joint / (p_feat[b] * p_target[t]))

    return mi


def variance_threshold(features, threshold=0.01):
    n_features = len(features[0])
    n_samples = len(features)
    selected = []

    for j in range(n_features):
        col = [features[i][j] for i in range(n_samples)]
        mean = sum(col) / n_samples
        var = sum((v - mean) ** 2 for v in col) / n_samples
        if var >= threshold:
            selected.append(j)

    return selected


def remove_correlated(features, threshold=0.9):
    n_features = len(features[0])
    n_samples = len(features)

    to_remove = set()
    for i in range(n_features):
        if i in to_remove:
            continue
        col_i = [features[r][i] for r in range(n_samples)]
        for j in range(i + 1, n_features):
            if j in to_remove:
                continue
            col_j = [features[r][j] for r in range(n_samples)]
            corr = abs(correlation(col_i, col_j))
            if corr >= threshold:
                to_remove.add(j)

return [i for i in range(n_features) if i not in to_remove]مرحلهی 6: خط لولهی کامل و دمو
import random


def make_housing_data(n=200, seed=42):
    random.seed(seed)
    data = []
    for _ in range(n):
        sqft = random.uniform(500, 5000)
        bedrooms = random.choice([1, 2, 3, 4, 5])
        age = random.uniform(0, 50)
        neighborhood = random.choice(["downtown", "suburbs", "rural"])
        has_pool = random.choice([True, False])

        sqft_with_missing = sqft if random.random() > 0.05 else None
        age_with_missing = age if random.random() > 0.08 else None

        price = (
            50 * sqft
            + 20000 * bedrooms
            - 1000 * age
            + (50000 if neighborhood == "downtown" else 10000 if neighborhood == "suburbs" else 0)
            + (15000 if has_pool else 0)
            + random.gauss(0, 20000)
        )

        data.append({
            "sqft": sqft_with_missing,
            "bedrooms": bedrooms,
            "age": age_with_missing,
            "neighborhood": neighborhood,
            "has_pool": has_pool,
            "price": price,
        })
    return data


if __name__ == "__main__":
    data = make_housing_data(200)

    print("=== Raw Data Sample ===")
    for row in data[:3]:
        print(f"  {row}")

    sqft_raw = [d["sqft"] for d in data]
    age_raw = [d["age"] for d in data]
    prices = [d["price"] for d in data]

    print("\n=== Missing Value Handling ===")
    sqft_missing = sum(1 for v in sqft_raw if v is None)
    age_missing = sum(1 for v in age_raw if v is None)
    print(f"  sqft missing: {sqft_missing}/{len(sqft_raw)}")
    print(f"  age missing: {age_missing}/{len(age_raw)}")

    sqft_indicator = add_missing_indicator(sqft_raw)
    age_indicator = add_missing_indicator(age_raw)
    sqft_imputed, sqft_fill = impute_median(sqft_raw)
    age_imputed, age_fill = impute_mean(age_raw)
    print(f"  sqft filled with median: {sqft_fill:.0f}")
    print(f"  age filled with mean: {age_fill:.1f}")

    print("\n=== Numerical Transforms ===")
    sqft_scaled = standardize(sqft_imputed)
    age_scaled = min_max_scale(age_imputed)
    sqft_log = log_transform(sqft_imputed)
    age_binned = bin_values(age_imputed, n_bins=5)
    print(f"  sqft standardized: mean={sum(sqft_scaled)/len(sqft_scaled):.4f}, std={math.sqrt(sum(v**2 for v in sqft_scaled)/len(sqft_scaled)):.4f}")
    print(f"  age min-max: [{min(age_scaled):.2f}, {max(age_scaled):.2f}]")
    print(f"  age bins: {sorted(set(age_binned))}")

    print("\n=== Categorical Encoding ===")
    neighborhoods = [d["neighborhood"] for d in data]

    ohe, ohe_cats = one_hot_encode(neighborhoods)
    print(f"  One-hot categories: {ohe_cats}")
    print(f"  Sample encoding: {neighborhoods[0]} -> {ohe[0]}")

    le, le_map = label_encode(neighborhoods)
    print(f"  Label encoding map: {le_map}")

    te, te_map = target_encode(neighborhoods, prices, smoothing=10)
    print(f"  Target encoding: {({k: round(v) for k, v in te_map.items()})}")

    print("\n=== Text Features ===")
    descriptions = [
        "large modern house with pool",
        "small cozy cottage near downtown",
        "spacious family home with large yard",
        "modern apartment downtown with view",
        "rustic cabin in rural area",
    ]
    cv, cv_vocab = count_vectorize(descriptions)
    print(f"  Vocabulary size: {len(cv_vocab)}")
    print(f"  Doc 0 non-zero features: {sum(1 for v in cv[0] if v > 0)}")

    tf, tf_vocab = tfidf(descriptions)
    print(f"  TF-IDF vocabulary size: {len(tf_vocab)}")
    top_words = sorted(tf_vocab.keys(), key=lambda w: tf[0][tf_vocab[w]], reverse=True)[:3]
    print(f"  Doc 0 top TF-IDF words: {top_words}")

    print("\n=== Polynomial Features ===")
    sample_row = [sqft_scaled[0], age_scaled[0]]
    poly = polynomial_features(sample_row, degree=2)
    print(f"  Input: {[round(v, 4) for v in sample_row]}")
    print(f"  Polynomial: {[round(v, 4) for v in poly]}")
    print(f"  Features: [x1, x2, x1^2, x2^2, x1*x2]")

    print("\n=== Feature Selection ===")
    feature_matrix = [
        [sqft_scaled[i], age_scaled[i], float(sqft_indicator[i]), float(age_indicator[i])]
        + ohe[i]
        for i in range(len(data))
    ]

    print(f"  Total features: {len(feature_matrix[0])}")

    surviving_var = variance_threshold(feature_matrix, threshold=0.01)
    print(f"  After variance threshold (0.01): {len(surviving_var)} features kept")

    surviving_corr = remove_correlated(feature_matrix, threshold=0.9)
    print(f"  After correlation filter (0.9): {len(surviving_corr)} features kept")

    binary_prices = [1 if p > sum(prices) / len(prices) else 0 for p in prices]
    print("\n  Mutual information with target:")
    feature_names = ["sqft", "age", "sqft_missing", "age_missing"] + [f"neigh_{c}" for c in ohe_cats]
    for j in range(len(feature_matrix[0])):
        col = [feature_matrix[i][j] for i in range(len(feature_matrix))]
        mi = mutual_information(col, binary_prices, n_bins=10)
        print(f"    {feature_names[j]}: MI={mi:.4f}")

    print("\n  Correlation with price:")
    for j in range(len(feature_matrix[0])):
        col = [feature_matrix[i][j] for i in range(len(feature_matrix))]
        corr = correlation(col, prices)
        print(f"    {feature_names[j]}: r={corr:.4f}")
استفاده از ابزارهای واقعی
در scikit-learn، این تبدیلها در قالب خطوط لولهی ترکیبپذیر پیاده میشوند:
from sklearn.preprocessing import StandardScaler, OneHotEncoder, PolynomialFeatures
from sklearn.impute import SimpleImputer
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.feature_selection import mutual_info_classif, VarianceThreshold
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline

numeric_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
])

categorical_pipe = Pipeline([
    ("encoder", OneHotEncoder(sparse_output=False)),
])

preprocessor = ColumnTransformer([
    ("num", numeric_pipe, ["sqft", "age"]),
    ("cat", categorical_pipe, ["neighborhood"]),
])نسخههای پیادهسازیشده از صفر دقیقاً نشان میدهند درون هر تبدیل چه میگذرد. نسخههای کتابخانهای مواردی چون مدیریت حالتهای خاص، پشتیبانی از ماتریس خلوت (sparse matrix) و ترکیب در خط لوله را به همراه دارند، اما منطق ریاضی هر دو کاملاً یکسان است.
تحویل پروژه
خروجی این درس:
outputs/prompt-feature-engineer.md- یک پرامپت برای مهندسی سیستماتیک ویژگیها بر اساس دادههای خام
تمرینها
- مقیاسبندی مقاوم (Robust scaling - با استفاده از میانه و دامنهی میانچارکی بهجای میانگین و انحراف معیار) را به تبدیلهای عددی اضافه کنید. عملکرد آن را با مقیاسبندی استاندارد روی دادههای دارای مقادیر پرت شدید مقایسه کنید.
- کدگذاری هدفی یکیجاافتاده (Leave-one-out target encoding) را پیادهسازی کنید: برای هر سطر، میانگین متغیر هدف را بدون در نظر گرفتن مقدار هدف همان سطر حساب کنید. نشان دهید این کار چطور در مقایسه با کدگذاری هدفی ساده از بیشبرازش جلوگیری میکند.
- یک پایپلاین خودکار برای انتخاب ویژگی بسازید که آستانهی واریانس، فیلتر همبستگی و رتبهبندی بر اساس اطلاعات متقابل را ترکیب کند. آن را روی مجموعهدادهی مسکن اعمال کرده و عملکرد یک مدل رگرسیون خطی ساده را در دو حالت «همهی ویژگیها» و «ویژگیهای منتخب» مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | اصطلاح عامیانه | معنای واقعی |
|---|---|---|
| مهندسی ویژگی (Feature engineering) | «ساخت ستونهای جدید» | تبدیل دادههای خام به بازنماییهایی که الگوها را برای مدل آشکار میکنند |
| استانداردسازی (Standardization) | «نرمال کردن دادهها» | کم کردن میانگین و تقسیم بر انحراف معیار تا متغیر دارای میانگین 0 و انحراف معیار 1 شود |
| کدگذاری وانهات (One-hot encoding) | «ساخت متغیرهای دامی (Dummy)» | ساخت یک ستون باینری بهازای هر دسته؛ بهطوریکه در هر سطر فقط مقدار یک ستون 1 باشد |
| کدگذاری هدفی (Target encoding) | «کدگذاری با استفاده از پاسخ» | جایگزینی هر دسته با میانگین متغیر هدف در همان دسته، همراه با هموارسازی برای جلوگیری از بیشبرازش |
| معیار TF-IDF | «شمارش باکلاس کلمات» | حاصلضرب بسامد کلمه در معکوس بسامد سندی: وزندهی به کلمات بر اساس تمایز آنها در کل متنها |
| جایگزینی یا درونیابی (Imputation) | «پر کردن جاهای خالی» | پر کردن مقادیر گمشده با برآوردهای تخمینی (میانگین، میانه، مد یا پیشبینی مدل) |
| انتخاب ویژگی (Feature selection) | «دور ریختن ستونهای نامناسب» | حذف ویژگیهای نویزدار یا تکراری و نگهداشتن آنهایی که حاوی سیگنال مفید دربارهی هدف هستند |
| اطلاعات متقابل (Mutual information) | «یک چیز چقدر دربارهی چیز دیگر به ما میگوید» | معیاری برای سنجش کاهش عدمقطعیت دربارهی متغیر Y پس از مشاهدهی متغیر X |
| نشت داده (Data leakage) | «تقلب تصادفی» | استفاده از اطلاعاتی در زمان آموزش که هنگام پیشبینی واقعی وجود ندارند؛ عاملی که نتایجی بیشازحد خوشبینانه و کاذب تولید میکند |
منابع برای مطالعهی بیشتر
- مهندسی و انتخاب ویژگی (Max Kuhn & Kjell Johnson) - کتاب آنلاین و رایگانی که تمام جنبههای مهندسی ویژگی را پوشش میدهد
- راهنمای پیشپردازش در scikit-learn - مرجع کاربردی برای تمام تبدیلهای استاندارد
- کدگذاری هدفی اصولی (Micci-Barreca, 2001) - مقالهی اصلی دربارهی کدگذاری هدفی به همراه هموارسازی (Smoothing)