
در سیستمهای مبتنی بر مدلهای زبانی بزرگ، ارسال مداوم پرامپتهای سیستمی حجیم یا اسناد RAG در هر رفتوبرگشت مکالمه، هزینههای پردازش را به شدت بالا میبرد. با تکرار یک کانتکست چند هزار توکنی در تمام درخواستها، در واقع هزینهی پردازش متنی را میپردازید که هیچ تغییری نکرده است. کش کردن پرامپت (Prompt Caching) این امکان را فراهم میکند که پیشوند ثابت ورودی را در حافظهی سمت ارائهدهنده نگه دارید و در درخواستهای بعدی، تخفیفی بین 50 تا 90 درصد بگیرید.
استفادهی بهینه از توکنها برای توسعهدهندگان ایرانی اهمیتی دوچندان دارد؛ چرا که کارتهای بانکی ایرانی امکان پرداخت مستقیم به سرویسهای خارجی نظیر OpenAI و Anthropic را ندارند و خرید اعتبار ارزی از طریق واسطهها با چالش و هزینهی بالاتری همراه است. به کار بستن درست استراتژیهای کشینگ، صورتحساب APIهای بینالمللی یا گیتویهای واسط را بهشکل محسوسی پایین میآورد.
در این درس یاد میگیرید که مکانیزم کشینگ در سه ارائهدهندهی بزرگ (Anthropic، OpenAI و Google Gemini) چگونه کار میکند، چطور پرامپتهای خود را به شکل اصولی چینش کنید تا کش نسوزد، و چگونه نرخ برخورد (Hit Rate) و کاهش هزینهها را در محیط پروداکشن زیر نظر بگیرید.
پرامپت سیستمی شما 4,000 توکن است. زمینهی RAG شما هم 20,000 توکن حجم دارد. هر دوی اینها را با تکتک درخواستها ارسال میکنید و هر بار هم هزینهی هر دو را تماموکمال میپردازید. قابلیت کش کردن پرامپت (Prompt caching) به ارائهدهنده اجازه میدهد این پیشوند را در سمت خود گرم (Warm) نگه دارد و در استفادههای بعدی، فقط 10% نرخ معمول را فاکتور کند. اگر درست پیادهسازی شود، هزینهی اینفرنس (Inference) را بین 50 تا 90 درصد و تاخیر اولین توکن را بین 40 تا 85 درصد کاهش میدهد.
صورت مسئله
یک ایجنت برنامهنویسی در هر نوبت گفتوگو، همان پرامپت سیستمیِ 15,000 توکنی را برای Claude میفرستد. 20 نوبت گفتوگو با نرخ 3 دلار به ازای هر یک میلیون توکن ورودی، فقط 0.90 دلار هزینهی ورودی میتراشد؛ آن هم قبل از اینکه حتی یکی از پیامهای واقعی کاربر را به حساب بیاوریم. این عدد را در 10,000 مکالمهی روزانه ضرب کنید: روزانه 9,000 دلار برای متنی پرداخت میشود که حتی یک واو آن هم تغییر نمیکند.
نمیتوانید پرامپت را کوچک کنید چون کیفیت خروجی آسیب میبیند. نمیتوانید از فرستادنش هم صرفنظر کنید چون مدل در هر نوبت به آن نیاز دارد. تنها راه پیش رو این است: برای پیشوندی که ارائهدهنده قبلاً پردازش کرده، دیگر هزینهی کامل را نپردازید.
این راهکار همان کش کردن پرامپت است. Anthropic در اوت 2024 آن را عرضه کرد (و در 2025 نسخهای با مدتزمان اعتبار یا TTL یکساعته به آن افزود)، OpenAI اواخر همان سال این قابلیت را خودکار کرد، Google قابلیت کانتکست کشینگ صریح را همراه با Gemini 1.5 ارائه داد و حالا هر سه سرویسدهنده، آن را به عنوان قابلیتی درجهیک روی مدلهای مرزی خود در اختیارتان میگذارند.
مفاهیم پایه
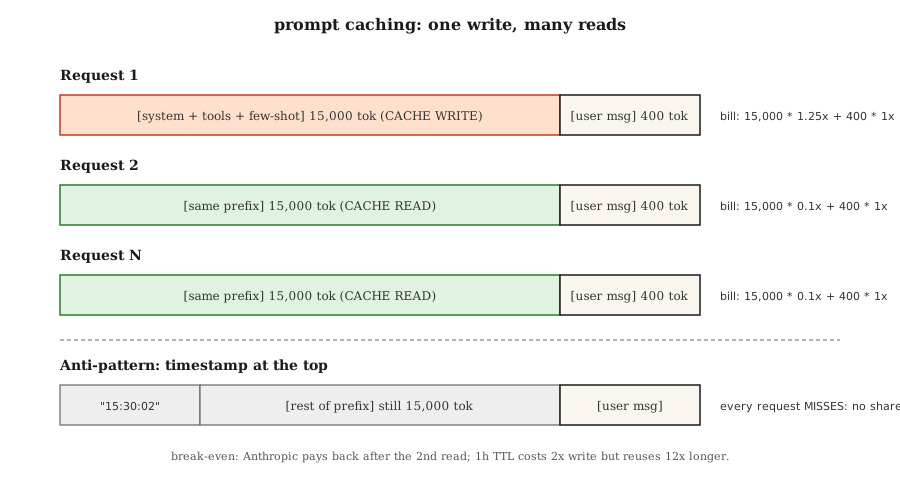
مکانیسم کار. وقتی پیشوند یک درخواست با پیشوند درخواستی اخیر مطابقت داشته باشد، ارائهدهنده به جای انکود دوبارهی توکنها، KV-cache اجرای قبلی را تحویل میدهد. دفعهی اول مبلغی جزئی به عنوان هزینهی نوشتن میپردازید و در دفعات بعدی، تخفیف چشمگیری برای خواندن از کش میگیرید.
سه رویکرد ارائهدهندگان در سال 2026.
| ارائهدهنده | شیوهی کار با API | تخفیف برخورد با کش (Hit) | هزینهی اضافهی نوشتن (Write) | TTL پیشفرض | حداقل توکن قابل کش |
|---|---|---|---|---|---|
| Anthropic | نشانگرهای صریح cache_control روی بلوکهای محتوا |
90% تخفیف ورودی | 25% هزینهی اضافه | 5 دقیقه (قابل افزایش تا 1 ساعت) | 1,024 توکن (Sonnet/Opus)، 2,048 توکن (Haiku) |
| OpenAI | تشخیص خودکار پیشوند | 50% تخفیف ورودی | بدون هزینهی اضافه | تا 1 ساعت (Best-effort) | 1,024 توکن |
| Google (Gemini) | کار با API صریح CachedContent |
محاسبه بر اساس فضای ذخیرهسازی؛ خواندن با حدود 25% نرخ عادی | هزینهی ذخیرهسازی بر اساس توکن در ساعت | تعیین توسط کاربر (پیشفرض 1 ساعت) | 4,096 توکن (Flash)، 32,768 توکن (Pro) |
اصل تغییرناپذیر. هر سه ارائهدهنده فقط پیشوندها را کش میکنند. اگر حتی یک توکن بین دو درخواست تفاوت داشته باشد، تمام بخشهای بعد از آن توکنِ متفاوت، کش را از دست میدهند (Miss میشوند). بخشهای ثابت را در بالا و بخشهای متغیر را در پایین قرار دهید.
چینش سازگار با کش
[system prompt]          <-- cache this
[tool definitions]       <-- cache this
[few-shot examples]      <-- cache this
[retrieved documents]    <-- cache if reused, else don't
[conversation history]   <-- cache up to last turn
[current user message]   <-- never cache (different every time)
اگر این ترتیب را به هم بزنید — مثلاً پیام کاربر را بالای پرامپت سیستمی بگذارید، یا نتایج پویای بازیابی را لابهلای مثالهای چندنمونهای (Few-shot) بچینید — هیچ درخواستی به کش برخورد نخواهد کرد.
محاسبهی نقطهی سربهسر
هزینهی اضافهی 25 درصدیِ نوشتن در Anthropic (با TTL پنجدقیقهای) همان بار اولِ خواندن جبران میشود؛ زیرا خواندن از کش فقط 0.1x هزینه دارد. 1 نوشتن + 1 خواندن، به طور میانگین هزینهی هر درخواست را به 0.675x میرساند (32% صرفهجویی)؛ 1 نوشتن + 10 خواندن، میانگین هزینه را به 0.205x کاهش میدهد (80% صرفهجویی). در TTL یکساعته، هزینهی نوشتن 2x محاسبه میشود؛ بنابراین آن بلوک حداقل به دو بار خواندن نیاز دارد تا بهصرفه شود. یک قاعدهی تجربی: هر بخشی را که پیشبینی میکنید در طول مدت TTL حداقل 3 بار استفاده میشود کش کنید؛ با این کار در هر دو مدل TTL از نقطهی سربهسر عبور میکنید.
پیادهسازی از صفر
گام 1: کش کردن پرامپت در Anthropic با نشانگرهای صریح
import anthropic

client = anthropic.Anthropic()

SYSTEM = [
    {
        "type": "text",
        "text": "You are a senior Python reviewer. Follow the rubric exactly.\n\n" + RUBRIC_15K_TOKENS,
        "cache_control": {"type": "ephemeral"},
    }
]

def review(code: str):
    return client.messages.create(
        model="claude-opus-4-7",
        max_tokens=1024,
        system=SYSTEM,
        messages=[{"role": "user", "content": code}],
    )
نشانگر cache_control به Anthropic اعلام میکند که این بلوک را به مدت 5 دقیقه ذخیره کند. استفادهی مجدد درون این بازه به کش برخورد میکند؛ اما استفاده پس از آن منقضی میشود و عملیات نوشتن دوباره انجام میگیرد.
فیلدهای مصرف در پاسخ:
response = review(code_a)
response.usage
# InputTokensUsage(
#     input_tokens=120,
#     cache_creation_input_tokens=15023,   # paid at 1.25x
#     cache_read_input_tokens=0,
#     output_tokens=340,
# )

response_b = review(code_b)
response_b.usage
# cache_creation_input_tokens=0
# cache_read_input_tokens=15023           # paid at 0.1x
هر دو فیلد را در CI بررسی کنید — اگر cache_read_input_tokens در طول درخواستها روی صفر ماند، کلیدهای کش شما دچار تغییر و انحراف شدهاند.
گام 2: افزایش مدت اعتبار (TTL) به یک ساعت
در جابهای دستهای (Batch) طولانی، مهلت 5 دقیقهای پیشفرض بین فواصل اجرای جابها منقضی میشود. مقدار ttl را تنظیم کنید:
{"type": "text", "text": RUBRIC, "cache_control": {"type": "ephemeral", "ttl": "1h"}}مدتزمان اعتبار 1 ساعته، هزینهی اضافی نوشتن را دو برابر میکند (50% بیشتر از خط مبنا به جای 25%)؛ اما برای هر پردازش دستهای که پیشوند را بیش از 5 بار بازخوانی کند، خیلی سریع این هزینه جبران میشود.
گام 3: کش خودکار در OpenAI
OpenAI تنظیمی پیش روی شما نمیگذارد. هر پیشوندی که بیش از 1,024 توکن باشد و با درخواستی اخیر مطابقت کند، به طور خودکار مشمول 50% تخفیف میشود.
from openai import OpenAI
client = OpenAI()

resp = client.chat.completions.create(
    model="gpt-5",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},   # long and stable
        {"role": "user", "content": user_msg},
    ],
)
resp.usage.prompt_tokens_details.cached_tokens  # the discounted portion
همان قاعدهی چینش سازگار با کش در اینجا هم صدق میکند. دو عامل کش OpenAI را باطل میکنند که روی Anthropic بیاثرند: تغییر فیلد user (که جزئی از کلید کش به حساب میآید) و به هم خوردن ترتیب ابزارها (Tools).
گام 4: کش کردن صریح کانتکست در Gemini
Gemini با کش مانند یک آبجکت مستقل و نامگذاریشده رفتار میکند:
from google import genai
from google.genai import types

client = genai.Client()

cache = client.caches.create(
    model="gemini-3.8-flash",
    config=types.CreateCachedContentConfig(
        display_name="rubric-v3",
        system_instruction=RUBRIC,
        contents=[FEW_SHOT_EXAMPLES],
        ttl="3600s",
    ),
)

resp = client.models.generate_content(
    model="gemini-3.8-flash",
    contents=["Review this code:\n" + code],
    config=types.GenerateContentConfig(cached_content=cache.name),
)
Gemini تا زمانی که کش زنده است، به ازای هر توکن در ساعت هزینهی ذخیرهسازی دریافت میکند و خواندن از آن حدود 25% نرخ ورودی عادی خرج برمیدارد. وقتی یک پرامپت بسیار بزرگ را قرار است طی چند روز بین نشستهای گوناگون استفاده کنید، این ساختار دقیقاً مناسب کار شماست.
گام 5: اندازهگیری نرخ برخورد با کش در محیط پروداکشن
برای بررسی یک سیستم شبیهسازیشدهی حسابداری روی سه ارائهدهنده که تعداد نوشتن، خواندن و عدم برخورد را ثبت کرده و هزینهی ترکیبی به ازای هر 1K درخواست را محاسبه میکند، فایل code/main.py را ببینید. فرآیند استقرار خود را به رسیدن به یک نرخ هدف مقید کنید — بیشتر سرویسهای پروداکشن Anthropic باید پس از دورهی وارمآپ (پیشگرمایش)، سهم خواندن از کشی بالای 80% ثبت کنند.
تلههایی که هنوز در سال 2026 دیده میشوند
- گذاشتن زمان متغیر در ابتدای پرامپت. قراردادن متنی مثل
"Current time: 2026-04-22 15:30:02"در بالای پرامپت سیستمی باعث میشود تکتک درخواستها کش را از دست بدهند. این زمانها را به زیر نقطهی شکست کش (Cache Breakpoint) منتقل کنید. - تغییر ترتیب ابزارها. ابزارها را همیشه با ترتیبی ثابت سریالایز کنید؛ جابهجایی کلیدهای یک دیکشنری بین دو دیپلوی، تمام برخوردهای کش را میسوزاند.
- متنهای آزاد تقریباً مشابه. تفاوت میان «You are helpful.» و «You are a helpful assistant.» در حد یک بایت است، اما کل کش را از بین میبرد.
- بلوکهای خیلی کوچک. ارائهدهندهی Anthropic برای ذخیرهسازی کف 1,024 توکن (و 2,048 توکن برای Haiku) را در نظر گرفته است. بلوکهای کوچکتر بدون نمایش هیچ خطایی کش نمیشوند.
- داشبوردهای هزینهی سردرگمکننده. حتماً در مانیتورینگ خود، «توکنهای ورودی» را به دو دستهی کششده و کشنشده تفکیک کنید. در غیر این صورت، افت ترافیک ورودی را به اشتباه پای موفقیتِ کش میگذارید.
استفاده از ابزارهای واقعی
انتخاب استک کش در سال 2026:
| شرایط سناریو | انتخاب مناسب |
|---|---|
| ایجنت با پرامپت سیستمی ثابت بالای 10 هزار توکن و نوبتهای گفتوگوی متعدد | ویژگی cache_control در Anthropic با TTL پنج دقیقهای |
| جاب دستهای که پیشوند را بیش از 30 دقیقه بازخوانی میکند | سرویس Anthropic با پارامتر ttl: "1h" |
| اندپوینتهای سرورلس روی GPT-5، بدون زیرساخت اختصاصی | کش خودکار OpenAI (تنها کافی است پیشوندتان ثابت و طولانی باشد) |
| استفادهی مجدد چندروزه از مجموعهای بزرگ از کدها یا مستندات | ساختار صریح CachedContent در Gemini |
| قابلیت فالبک بین ارائهدهندههای مختلف | چینش پیشوند کششدنی را بین همهی ارائهدهندهها یکسان نگه دارید تا روی هر کدام، کش کار کند |
این روش را با کش معنایی (فصل 11 · 11) برای لایهی پیامهای کاربر ترکیب کنید: کش کردن پرامپت به استفادههای مجدد توکنبهتوکن یکسان اختصاص دارد و کش معنایی برای استفادههای معنایی یکسان به کار میرود.
خروجی این درس
فایل outputs/skill-prompt-caching-planner.md را ذخیره کنید:
---
name: prompt-caching-planner
description: Design a cache-friendly prompt layout and pick the right provider caching mode.
version: 1.0.0
phase: 11
lesson: 15
tags: [llm-engineering, caching, cost]
---

Given a prompt (system + tools + few-shot + retrieval + history + user) and a usage profile (requests per hour, TTL needed, provider), output:

1. Layout. Reordered sections with a single cache breakpoint marked; explain which sections are stable, which are volatile.
2. Provider mode. Anthropic cache_control, OpenAI automatic, or Gemini CachedContent. Justify from TTL and reuse pattern.
3. Break-even. Expected reads per write within TTL; net cost vs no-cache with math.
4. Verification plan. CI assertion that cache_read_input_tokens > 0 on the second identical request; dashboard split by cached vs uncached tokens.
5. Failure modes. List the three most likely reasons the cache will miss in this setup (dynamic timestamp, tool reorder, near-duplicate text) and how you will prevent each.

Refuse to ship a cache plan that places a dynamic field above the breakpoint. Refuse to enable 1h TTL without a reuse count that makes the 2x write premium pay back.تمرینها
- ساده. یک مکالمهی 10 نوبتی با یک پرامپت سیستمی 5,000 توکنی را روی Claude اجرا کنید. بار اول بدون
cache_controlو بار دوم همراه با آن درخواست بزنید. فاکتور هزینهی توکن ورودی هر دو را گزارش کنید. - متوسط. یک محیط تست بنویسید که یک قالب پرامپت و لاگ درخواستها را بگیرد و نرخ برخورد با کش و میزان صرفهجویی دلاری را به تفکیک ارائهدهنده (Anthropic 5m، Anthropic 1h، OpenAI automatic و Gemini explicit) محاسبه کند.
- سخت. یک بهینهساز چینش پرامپت طراحی کنید: سیستمی که یک پرامپت و فهرستی از فیلدهای نشانهگذاریشده با
stable=True/Falseرا دریافت کند و پرامپت را به شکلی بازنویسی کند که یک نقطهی شکست کش، بدون افت محتوا در بهینهترین جایگاه ممکن قرار بگیرد. صحت کارکرد آن را روی یک اندپوینت واقعی Anthropic ارزیابی کنید.
اصطلاحات کلیدی
| اصطلاح | به زبان ساده | تعریف فنی و واقعی |
|---|---|---|
| Prompt caching | «پرامپتهای طولانی رو ارزون میکنه» | استفادهی مجدد از KV-cache سمت ارائهدهنده برای پیشوندهای تطبیقیافته؛ با 50 تا 90 درصد تخفیف روی توکنهای ورودی تکراری. |
cache_control |
«نشانگر Anthropic» | ویژگی بلوک محتوا که مشخص میکند «همهچیز تا این نقطه قابل کش شدن است»؛ با فرمت {"type": "ephemeral"}. |
| Cache write | «پرداخت هزینهی اضافه» | اولین درخواستی که کش را مقداردهی میکند؛ در Anthropic با ضریب ~1.25x نرخ ورودی فاکتور میشود و در OpenAI رایگان است. |
| Cache read | «همون تخفیفه» | درخواستهای بعدی که با پیشوند مطابقت دارند؛ با نرخ 10% (Anthropic)، 50% (OpenAI) و ~25% (Gemini) محاسبه میشوند. |
| TTL | «چقدر زنده میمونه» | مدت زمانی (به ثانیه) که کش در وضعیت گرم نگهداری میشود؛ در Anthropic به طور پیشفرض 5 دقیقه (با قابلیت افزایش به 1 ساعت)، در OpenAI تا 1 ساعت بر اساس Best-effort و در Gemini با تنظیم کاربر. |
| Extended TTL | «کش یکساعتهی Anthropic» | مقدار {"type": "ephemeral", "ttl": "1h"}؛ با هزینهی اضافهی نوشتن به میزان 2x، که برای پردازشهای دستهای کاملاً میارزد. |
| Prefix match | «چرا کش من کار نکرد؟» | کش تنها زمانی جواب میدهد که تمام توکنها از ابتدای درخواست تا نقطهی شکست کش، بایتبهبایت یکسان باشند. |
| Context caching (Gemini) | «کش صریح گوگل» | آبجکت ذخیرهسازی نامگذاریشده در گوگل که هزینهی نگهداری دارد؛ بهترین گزینه برای استفادهی مکرر از مجموعهدادههای حجیم طی چند روز. |
برای مطالعهی بیشتر
- Anthropic — Prompt caching — راهنمای
cache_control، مدت اعتبار 1 ساعته و جدولهای نقطهی سربهسر. - OpenAI — Prompt caching — تطبیق خودکار پیشوند.
- Google — Context caching — مستندات API آبجکت
CachedContentو قیمتگذاری فضای ذخیرهسازی. - Anthropic engineering — Prompt caching for long-context workloads — پست وبلاگ معرفی این قابلیت به همراه آمارهای تاخیر.
- فصل 11 · 05 (مهندسی کانتکست) — کانتکست را از کجا برش بزنیم تا کش بهترین کارایی را نشان دهد.
- فصل 11 · 11 (کشینگ و مدیریت هزینهها) — همگامسازی کش کردن پرامپت با کش معنایی روی پیامهای کاربر.
- Pope et al., "Efficiently Scaling Transformer Inference" (2022) — معماری حافظهی KV-cache که در قابلیت کش کردن پرامپت در اختیار کاربران قرار میگیرد؛ این مقاله توضیح میدهد چرا بازخوانی یک پیشوند کششده تقریباً 10 برابر ارزانتر از محاسبهی دوبارهی آن است.
- Agrawal et al., "SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills" (2023) — مرحلهی Prefill دقیقاً همان فرآیندی است که با کش کردن پرامپت میانبر میخورد؛ این مقاله روشن میکند که چرا تاخیر اولین توکن (TTFT) پس از برخورد به کش به شدت افت میکند، اما زمان به ازای هر توکن خروجی (TPOT) بدون تغییر میماند.
- Leviathan et al., "Fast Inference from Transformers via Speculative Decoding" (2023) — کش کردن پرامپت در کنار دیکودینگ حدسی (Speculative Decoding)، فلش اتنشن (Flash Attention) و MQA/GQA از اهرمهای اصلی شکستن منحنی هزینهی اینفرنس است؛ برای آشنایی با سه اهرم دیگر، این مقاله را بخوانید.