
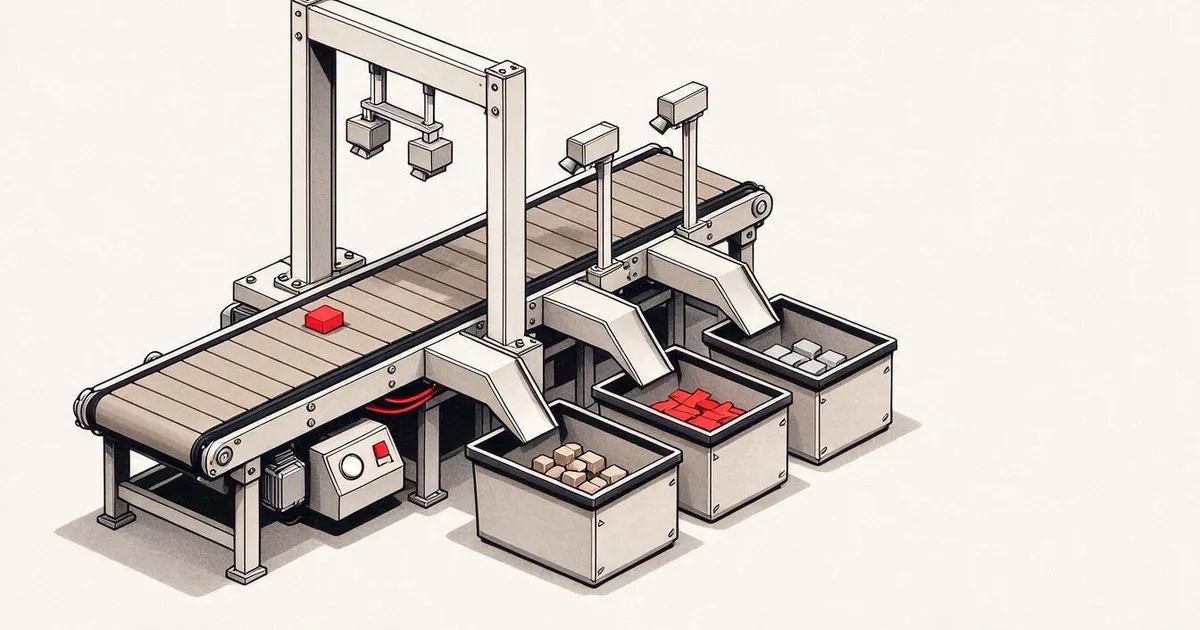
فیلتر کردن ورودی کاربر بهتنهایی برای تضمین سلامت پاسخهای مدل زبانی کافی نیست. حتی اگر پرامپت کاربر کاملاً بیخطر باشد، مدل ممکن است در پاسخ دچار توهم شود، اطلاعات هویتی و خصوصی (PII) موجود در دادههای آموزش را لو دهد، الفاظ نامناسب تولید کند یا پرامپت محرمانهی سیستم (System Prompt) را برملا سازد. تکیه بر بررسیهای ورودی، در برابر روشهای دورزدن جدید آسیبپذیر است و داشتن یک لایهی نظارت مستقل روی خروجی مدل ضرورتی جدی به شمار میآید.
در این درس یاد میگیرید چگونه سه کلاسیفایر سمت خروجی (تشخیص مسمومیت، تشخیص PII و بررسی نشت دستورالعمل) را همراه با سازوکارهای اختصاصی پاکسازی دادهها پیادهسازی کنید. همچنین یک مسیریاب خطمشی (Policy Router) واحد میسازید که با تجمیع احکام مختلف، شدت ریسک را ارزیابی کرده و اقدامات لازم نظیر مسدودسازی، پاکسازی، هشدار یا ثبت لاگ را روی خروجی نهایی مدل اعمال کند.
کلاسیفایرهای بخش خروجی به پرسش متفاوتی نسبت به قوانین بخش ورودی پاسخ میدهند. هر دو به یک مسیریاب خطمشی نیاز دارند.
صورت مسئله
ورودیها تنها سطح حمله (attack surface) نیستند. مدلی که از تمام بررسیهای ورودی با موفقیت عبور کرده، همچنان میتواند خروجی نامناسبی تولید کند: اطلاعات هویتی حساس (PII) را لو بدهد، توهینهای برگرفته از توزیع دادههای آموزش خود را تکرار کند، یا در پاسخ به یک پرسش هوشمندانه، پرامپت سیستم را عیناً به کاربر پس بدهد. کلاسیفایر سمت خروجی، پاسخ واقعی مدل را میبیند، نه پرامپت کاربر را؛ بنابراین پرسش متفاوتی مطرح میکند: فارغ از اینکه این پرامپت چطور به اینجا رسیده، آیا آنچه قصد داریم به کاربر تحویل دهیم قابل قبول است؟
تیمها اغلب از کلاسیفیکیشن خروجی صرفنظر میکنند، چون تصور میکنند بررسیهای ورودی کفایت میکند و کلاسیفایرهای خروجی تاخیر (latency) اضافه به بار میآورند. هر دو استدلال مردود است. نادیده گرفتن کلاسیفیکیشن خروجی، یک راه دورزدن تکضرب به مهاجم میدهد: هر دستهی جدید از حملات که پایپلاین ورودی پوشش ندهد، مستقیماً به دست کاربر میرسد. تاخیر مسئلهای واقعی است اما راهحل دارد: کلاسیفایرها میتوانند به موازات استریمینگ توکنها اجرا شوند؛ به این ترتیب که گیت، چانک نهایی را بافر میکند و حکم کلاسیفایر را درست پیش از ارسال (flush) روی آن اعمال میکند.
این پروژهی پایانی، سه کلاسیفایر مستقل سمت خروجی را پشت یک مسیریاب خطمشی (policy router) واحد به هم متصل میکند: مسمومیت کلامی یا Toxicity (تشخیص مبتنی بر قانون کلمات رکیک و آزار کلامی)، اطلاعات هویتی یا PII (رجکس برای ایمیل، شماره تلفن، رشتههای شبیه کدملی/SSN، شماره کارت اعتباری و آدرس IP) و نشت دستورالعمل یا Instruction leakage (یک روش هیوریستیک برای بازگویی پرامپت سیستم، از طریق مقایسهی همپوشانی ترایگرام بین خروجی و پرامپت سیستم مشخص). مسیریاب، احکام کلاسیفایرها را جمعآوری کرده، سطح شدت (severity) را تعیین میکند و خطمشی اقدام را پیش میگیرد: مسدودسازی (block)، پاکسازی دادههای حساس (redact)، هشدار (warn) یا ثبت لاگ (log).
مبانی نظری
هر کلاسیفایر یک شیء قابلفراخوانی (callable) است که خروجی آن یک ClassifierVerdict شامل نام (name)، امتیاز (score in [0,1])، شدت (severity با مقادیر none، low، medium، high) و یافتهها (findings به شکل فهرستی از رشتههای توصیفکنندهی موارد مشکوک) است. مسیریاب فهرستی از این احکام را میگیرد و جدول قوانین زیر را اعمال میکند:
| شدت | اقدام |
|---|---|
| high | مسدودسازی (حذف کامل خروجی و بازگرداندن امتناع مدل مبتنی بر خطمشی) |
| medium | پاکسازی دادههای حساس (اعمال ابزار پاکسازیِ مربوط به هر کلاسیفایر روی خروجی) |
| low | هشدار (ثبت لاگ و افزودن یک متن هشدار ملایم به انتهای پاسخ) |
| none | ثبت لاگ (ذخیرهی حکم در ردگیری محاسبات و ارسال خروجی بدون تغییر) |
مسیریاب بالاترین شدت را میان تمام کلاسیفایرها در نظر میگیرد و اقدام متناظر با آن را اجرا میکند. مسدودسازی همیشه برنده است. ترکیب پاکسازی + هشدار، به پاکسازی تبدیل میشود. ترکیب لاگ + هشدار، خروجی هشدار خواهد داشت. مسیریاب یک شیء Action شامل موارد verb، output، severity، verdicts و metadata صادر میکند. در پاییندست، گیت ایمنی درس 87 این فراداده را در یک ردگیری محاسبات (trace) ثبت میکند و سپس یکی از این سه کار را انجام میدهد: ارسال خروجی پاکسازیشده، ارسال متن اصلی همراه با هشدار، یا جایگزینی خروجی با امتناع مدل (refusal).
هر کلاسیفایر منطق پاکسازی خاص خود را دارد. کلاسیفایر PII آدرس name@example.com را با [redacted-email] و ارقام مشابه کارت اعتباری را با [redacted-card] جایگزین میکند. کلاسیفایر نشت دستورالعمل، خطوطی را که شبیه هدر پرامپت سیستم باشند حذف میکند. کلاسیفایر مسمومیت کلامی نیز واژههای رکیکِ شناساییشده را با [redacted-language] جایگزین میکند. این پاکسازیها مستقل از یکدیگرند؛ بنابراین متنی که هم حاوی مسمومیت کلامی و هم PII باشد، از فیلتر هر دو پاکساز عبور میکند.
کلاسیفایر مسمومیت کلامی عمداً مبتنی بر قانون طراحی شده است: فهرستی گلچینشده از کلیدواژههای آزاردهنده با تطبیق مرز فاصله (whitespace-bounded) و یک بررسی پنجرهی نفی کوتاه، تا عبارتی مانند «you are not a slur» به اشتباه این قاعده را فعال نکند. این فهرست آگاهانه کوتاه نگه داشته شده است (هدف این درس ساخت لولهکشی و زیرساخت اتصالات است، نه فرهنگ واژگان جامع). کلاسیفایر PII از رجکسهای استاندارد برای الگوهای رایج استفاده میکند. کلاسیفایر نشت دستورالعمل، هنگام ساخت یک پارامتر system_prompt دریافت میکند و میزان همپوشانی ترایگرام (trigram) آن را با خروجی میسنجد؛ همپوشانی بالا نشانهی نشت است.
پیادهسازی از صفر
فایل code/classifiers.py هر سه کلاسیفایر را تعریف میکند. هر کدام متدی به صورت classify(text) -> ClassifierVerdict و متد دیگری با امضای redact(text) -> str دارند. فایل code/main.py کلاس Router را همراه با متد decide(text, verdicts) -> Action و میانبر run(text) -> Action پیادهسازی میکند. کد نمایشی، این سه کلاسیفایر را پشت یک مسیریاب واحد قرار میدهد و مجموعهای از خروجیهای آزمایشی را روی آن اجرا میکند تا تمام سطوح شدت را به چالش بکشد.
استفاده از ابزارهای واقعی
دستور python3 main.py را اجرا کنید. برنامه، نوع اقدام (verb) را برای هر خروجی تستی چاپ میکند، گزارش را در outputs/classifier_report.json مینویسد و تأیید میکند که هر یک از حالتهای block، redact، warn و log حداقل روی یکی از سناریوهای تستی اجرا شده باشند. در اینجا تاخیر بهطور ساختگی صفر است، چون تمام کلاسیفایرها بر پایهی قوانین نوشته شدهاند؛ اما برای یک مدل واقعی با کلاسیفایرهای عصبی، پس از بالا رفتن تاخیر هر کلاسیفایر نیز دقیقاً همین ساختار اتصالات به کار میرود.
خروجی این درس
مستند outputs/skill-content-classifier-integration.md ساختارهای دادهای مربوط به حکم (verdict) و اقدام (action) را ثبت میکند تا گیت ایمنی درس 87 بتواند از آنها استفاده کند.
تمرینها
- یک کلاسیفایر چهارم برای تزریق کد (code injection) اضافه کنید (خروجیهایی که شامل
<script>،eval(و موارد مشابه باشند). خطمشی شدت آن را مشخص کرده و در پایپلاین ادغام کنید. - مسیریاب را به شکلی تغییر دهید که وزن شدت را به تفکیک کلاسیفایرها اعمال کند؛ طوری که PII اولویت بالاتری نسبت به مسمومیت کلامی داشته باشد. اثر این تغییر را روی همان دادههای آزمایشی نشان دهید.
- یک آستانه (threshold) اطمینان اضافه کنید تا احکامی که امتیاز پایینی دارند، یک درجه در سطح شدت تنزل پیدا کنند. این آستانه را تغییر دهید و بررسی کنید که نرخ مسدودسازی (block rate) چه تغییری میکند.
اصطلاحات کلیدی
| اصطلاح | کاربرد رایج | معنای دقیق |
|---|---|---|
| output classifier (کلاسیفایر خروجی) | مدلی که خروجیهای نامناسب را تشخیص میدهد | شیئی قابلفراخوانی که یک حکم ساختاریافته (شامل شدت، امتیاز و یافتهها) همراه با ابزار پاکسازی برمیگرداند |
| severity (شدت) | میزان نامناسب بودن محتوا | یکی از مقادیر none، low، medium یا high |
| router (مسیریاب) | یک سوییچ یا انشعابدهنده | تابعی که فهرستی از احکام را گرفته و اقدام مناسب (block، redact، warn، log) را برمیگرداند |
| redact (پاکسازی دادههای حساس) | پنهان کردن بخشهای نامناسب | جایگزینی اسپنهای منطبقشده با برچسبهایی نظیر [redacted-pii] به ازای هر کلاسیفایر |
| instruction leakage (نشت دستورالعمل) | مدل پرامپت سیستم را لو میدهد | یک روش هیوریستیک که خروجی مدل را بر اساس همپوشانی ترایگرام با پرامپت سیستم مشخص مقایسه میکند |
برای مطالعهی بیشتر
درس 86 یک موتور قوانین بیانی (declarative rules engine) برای محدودیتهایی اضافه میکند که ذاتاً در قالب کلاسیفایر نمیگنجند. در درس 87، هر دوی این ابزارها با دتکتور بخش ورودی ترکیب خواهند شد.