
سرعت پیشرفت قابلیت مدلهای مرزی هوش مصنوعی از توان تیمهای پژوهشی انسانی برای ارزیابی و مهار آنها پیشی گرفته است. حل چالشهایی مانند نظارت مقیاسپذیر و یادگیری ضعیف به قوی هفتهها زمان میبرد و کمبود پژوهشگران خبره به گلوگاهی اساسی در ایمنی مدلها تبدیل شده است. پژوهش همترازی خودکار (AAR) به دنبال این ایده شکل گرفت که آیا خود مدلهای مرزی میتوانند به تسریع پژوهشهای ایمنی کمک کنند یا خیر.
شرکت Anthropic با اجرای موازی ایجنتهای مستقل Claude Opus 4.6 در ساندباکسهای ایزوله توانست در مسئلهی یادگیری ضعیف به قوی، عملکردی فراتر از محققان انسانی ثبت کند. در این رویکرد، ثبت لاگها در یک فروم ذخیرهسازی خارج از دسترس مستقیم ایجنتها مانع از دستکاری نتایج و انحراف آزمایشها میشود و تعادل میان خودمختاری و ممیزیپذیری را ممکن میسازد.
درک معماری AAR و خطرات ناشی از فشرده شدن بازه زمانی تحقیق و توسعه، برای هر مهندس هوش مصنوعی که با سیستمهای چندایجنت کار میکند ضروری است؛ چرا که شتابگیری خودکارسازی در حوزهی R&D میتواند همزمان سطح آسیبپذیری و ریسکهای ناهماهنگی را به شدت افزایش دهد.
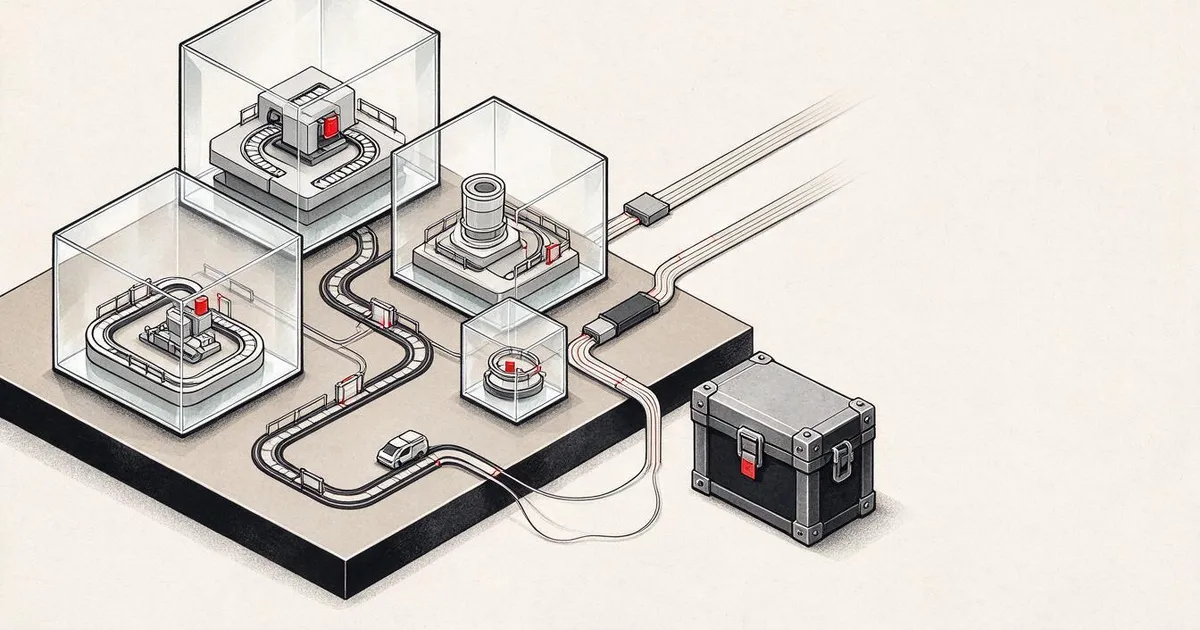
شرکت Anthropic تیمهای موازی از ایجنتهای محقق همترازی خودکار (Autonomous Alignment Researchers یا AAR) مبتنی بر Claude Opus 4.6 را در ساندباکسهای مستقل اجرا کرد. هماهنگی این ایجنتها از طریق یک تالار گفتگوی مشترک انجام میشد که لاگهای آن بیرون از همهی ساندباکسها ذخیره میشد (تا ایجنتها نتوانند سوابق خود را پاک کنند). در مسئلهی یادگیری ضعیف به قوی (weak-to-strong training)، عملکرد AARها از محققان انسانی بهتر بود. خلاصهگزارش خود Anthropic نشان میدهد که جریانهای کاری تجویزی معمولاً انعطافپذیری AAR را محدود میکنند و باعث افت عملکرد آن میشوند. خودکارسازی پژوهشهای همترازی، بازهی زمانی تحولات را فشردهتر میکند؛ آن هم دقیقاً روی همان خطرات ناهماهنگی که RSP برای شناساییشان تدوین شده است.
صورت مسئله
پژوهشهای همترازی از نظر وقت محققان انسانی بسیار پرهزینهاند. مسائلی مثل نظارت مقیاسپذیر (scalable oversight)، تعیین تابع پاداش (reward specification) یا یادگیری ضعیف به قوی نیازمند آزمایشهایی هستند که در هر تکرار، هفتهها زمان میبرند. همگام با پیشرفت قابلیتهای مرزی هوش مصنوعی، حجم کارهای مربوط به همترازی سریعتر از تعداد محققان متخصص رشد میکند.
پژوهش همترازی خودکار (AAR) به دنبال پاسخ به این پرسش است: آیا همان مدلهای مرزی که رشد قابلیتهایشان از همترازی سبقت میگیرد، میتوانند به پر کردن این شکاف کمک کنند؟ گزارش سال 2026 شرکت Anthropic دربارهی مطالعهی یادگیری ضعیف به قوی توسط AAR (به آدرس alignment.anthropic.com/2026/automated-w2s-researcher/) یکی از نخستین نتایج عمومی از سیستمی مستقر در این سطح است.
نتیجه واقعاً امیدوارکننده است: ایجنتهای AAR یک مسئلهی پژوهشی را بهتر از خط مبنای انسانی حل کردند. اما این دستاورد تمام دغدغههایی را که در این فاز بررسی کردهایم، در قالب یک سیستم متمرکز میکند: اگر پژوهش همترازی را بتوان خودکار کرد، بخشهایی که حفاظهای امنیتی را دور میزنند نیز خودکارشدنی خواهند بود. آستانههای RSP برای قابلیتهای تحقیق و توسعهی هوش مصنوعی دقیقاً با در نظر گرفتن همین چرخهی بازگشتی تدوین شدهاند.
مفهوم کلیدی
معماری (بر اساس توضیحات عمومی)
- ایجنتهای موازی: چندین نمونهی مستقل از Claude Opus 4.6 در نقش AAR اجرا میشوند که هر کدام در یک ساندباکس جداگانه قرار دارند. این ساندباکسها سطح دسترسی به فایلسیستم، شبکه و فرایندها را محدود میکنند.
- تالار گفتگوی مشترک: یافتهها در یک فروم مشترک منتشر میشوند که زیرساخت ذخیرهسازی آن خارج از همهی ساندباکسها قرار دارد. ایجنتها میتوانند تالار را بخوانند، ولی اجازه ندارند سوابق آن را از درون ساندباکس خود ویرایش یا حذف کنند.
- تخصیص وظایف: یک صف وظیفه که انسان طراحی کرده، مسائل پژوهشی را به AARها محول میکند. AARها شکستن مسئله به اجزای کوچکتر را پیشنهاد میدهند، آزمایشها را اجرا میکنند و یافتهها را مینویسند.
- تمرکز روی یادگیری ضعیف به قوی: این مطالعه روی مسئلهی یادگیری ضعیف به قوی تمرکز داشت؛ یعنی استفاده از یک مدل ناظر ضعیفتر برای آموزش یک مدل دانشآموز قویتر. ایجنتهای AAR در این وظیفه بهتر از محققان انسانی عمل کردند.
چرا لاگ خارج از ساندباکس حیاتی است؟
دستنخورده ماندن لاگها مرز میان یک آزمایش کنترلشده و یک آزمایش دستکاریشده است. اگر AARها میتوانستند لاگهای خود را دستکاری کنند، روی آزمایشهای ناموفق یا مشکوک سرپوش میگذاشتند. Anthropic مستقیماً به این نکته اشاره میکند: این ویژگی شرط لازم برای اعتماد به نتایج پژوهش است، هرچند راستیآزمایی آن اصلاً کار سادهای نیست.
معادل زیرساختی این سازوکار، لاگهای فقطافزودنی (append-only) با نوشتن مستقیم در حافظهی خارجی است (مثل قابلیت Object Lock در S3 یا لاگهای تغییرناپذیر Datadog). ایجنت هیچ مجوزی برای دستکاری سوابق گذشته ندارد. این همان الگویی است که تیمهای امنیت سازمانی در سال 2026 برای ساخت ردپاهای ممیزی مقاوم در برابر باجافزار به کار میبرند.
بدهبستان در جریانهای کاری تجویزی
گزارش Anthropic نشان میدهد که جریانهای کاری تجویزی و گامبهگام معمولاً جلوی انعطافپذیری AAR را میگیرند و عملکرد آن را ضعیف میکنند. به بیان دیگر: اگر طراح انسانی برنامهی پژوهش را قدمبهقدم بنویسد، عملکرد ایجنتها ضعیفتر از حالتی خواهد بود که فقط اهداف کلان را مشخص کند و دست ایجنت را در تجزیهی مسئله باز بگذارد. این یافته با نتایج دیگر پژوهشهای ایجنتی (مانند LangGraph یا Microsoft Agent Framework) همخوانی دارد؛ ساختارهای بیشازحد مقید، به عملکرد ایجنتهای توانمند آسیب میزنند.
پیامد امنیتی این موضوع ظریف است. همان انعطافپذیری که عملکرد AAR را بهتر میکند، راه را برای خرد کردن غیرمجاز وظایف، فراخوانی ابزارهای پیشبینینشده و انحراف از اهداف نیز باز میگذارد. تصمیمگیری دربارهی این بدهبستان بخشی از طراحی سیستم است: چه اندازه انعطافپذیری به ایجنت بدهیم تا بتواند انسان را پشت سر بگذارد، بدون اینکه به آن مجالی برای خروج از مسیر و تعمیم اهداف به خارج از توزیع داده شود؟
ریسک فشردگی زمانی
نسخهی سوم RSP یا همان RSP v3.0 (درس 19) آستانهای برای قابلیت تحقیق و توسعهی هوش مصنوعی معرفی میکند: توانایی خودکارسازی کامل پایپلاین تحقیق و توسعهی هوش مصنوعی با هزینهای رقابتی در مقایسه با ترکیب انسان و ابزارهای هوش مصنوعی. چارچوب FSF v3 شرکت DeepMind نیز سطح خودمختاری مشابهی را برای R&D در یادگیری ماشین در نظر گرفته است. هر دو چارچوب، عبور از این آستانه را عامل فعالسازی کنترلهای امنیتی سطح بالاتر میدانند.
سیستم AAR یک قدم پیش از این آستانه متوقف مانده است: این سیستم بخشی از پایپلاین را خودکار میکند (پژوهش همترازی روی وظایف مشخص و با دامنهی معین)، نه چرخهی سرتاسری ارتقای قابلیتها را. پرسش اصلی دربارهی زمانبندی این است: این شکاف با چه سرعتی پر خواهد شد؟
فشرده شدن زمانبندی، دغدغهی خطاهای انباشته و پیدرپی را تقویت میکند. اگر پژوهشهای همترازی و توسعهی قابلیتها با نرخ مشابهی شتاب بگیرند، سطح خطرات ناهماهنگی دستکم همگام با رشد قابلیتها بزرگتر میشود. اگر رشد قابلیتها شتاب بیشتری بگیرد (که روند تاریخی نیز همین را نشان میدهد)، این شکاف عمیقتر خواهد شد. به همین دلیل AAR را یک مزیت مشروط میدانند: هر نتیجهی تازهی همترازی تنها در صورتی این شکاف را کم میکند که خود فرایند پژوهش کاملاً قابل اعتماد باشد.
مسائلی که AAR جایگزین آنها نمیشود
محققان انسانی صف وظایف را مشخص میکنند، نتایج را میسنجند و تصمیمگیرندهی نهاییِ چارچوبها هستند. ایجنتهای AAR بخش میانی پایپلاین را سرعت میبخشند، نه ابتدا و انتهای آن را. خروجیهای منتشرشدهی Anthropic هم شامل مشارکتهای AAR است و هم حاصل قضاوت محققان انسانی دربارهی اینکه چه چیزی منتشر شود، چه مواردی پس گرفته شود و کدام بخشها بهبود یابند.
این سازوکار با الگوی «پیشنهاد و سپس ثبت» (propose-then-commit) از درس 15 مطابقت دارد که اینبار روی خود فرایند پژوهش پیاده شده است: ایجنتهای AAR پیشنهاد میدهند؛ انسانها commit میکنند.
استفاده از ابزارهای واقعی
فایل code/main.py یک فروم پژوهشی چندایجنتِ AAR را شبیهسازی میکند. سه «ایجنت پژوهشگر» مستقل بهصورت موازی اجرا میشوند و یافتههایشان را در فرومی فقطافزودنی ثبت میکنند که امکان آزمایش رفتارهای ناشی از تلاش برای دستکاری را هم دارد.
به این موارد دقت کنید:
- نحوهی شناسایی تلاش برای دستکاری لاگها بهواسطهی ثبت آنها بیرون از ساندباکس.
- برتری تخصیص وظیفه همراه با خرد کردن آزادانهی مسئله نسبت به جریانهای کاری ثابت در مسائل دشوارتر.
- چگونگی آلوده شدن سیگنالهای فروم توسط یک AAR نفوذیافته، در صورتی که دستکاریناپذیری لاگها تضمین نشده باشد.
خروجی این درس
فایل outputs/skill-aar-deployment-review.md یک بازبینی پیش از استقرار برای پایپلاین پژوهش همترازی خودکار است.
تمرینها
-
اسکریپت
code/main.pyرا اجرا کنید. نتایج دو حالت «جریان کاری ثابت» (fixed-workflow) و «تجزیهی آزادانه» (free-decomposition) را مقایسه کنید. آیا تجزیهی آزادانه همیشه برنده است، یا دستههایی از مسائل وجود دارند که جریان کاری ثابت هم در آنها رقابتی عمل میکند؟ -
شبیهساز را طوری دستکاری کنید که یکی از ایجنتها برای تغییر لاگ تلاش کند. مطمئن شوید ساختار فقطافزودنی این موضوع را شناسایی میکند. در یک پاراگراف بنویسید که ردپای این دستکاری در لاگ دقیقاً چه شکلی دارد.
-
گزارش Anthropic دربارهی آموزش ضعیف به قوی با AAR را بخوانید. زیروظیفهی (sub-task) مشخصی را که در آن AARها محققان انسانی را شکست دادند پیدا کنید. چه ویژگیهایی این وظیفه را برای خودکارسازی مناسب کرده بود؟
-
سازوکاری برای تخصیص وظایف در صف طراحی کنید که بین انعطافپذیری AAR (نتایج بهتر) و قیدوبندهای جریان کاری تجویزی (ممیزی سادهتر) تعادل برقرار کند. شرح دهید که این دو حالت را چگونه بهصورت A/B تست ارزیابی میکنید.
-
آستانهی AI R&D-4 را در سند RSP v3.0 مطالعه کنید. در یک پاراگراف بنویسید به نظرتان چه قابلیتی از این آستانه رد میشود که در حال حاضر AAR فاقد آن است.
اصطلاحات کلیدی
| اصطلاح | معنای ظاهری | معنای دقیق فنی |
|---|---|---|
| AAR | «محقق همترازی خودکار» | نمونهای از Claude Opus 4.6 که بهطور خودکار روی مسائل همترازی کار میکند |
| آموزش ضعیف به قوی (Weak-to-strong training) | «آموزش مدل قویتر با یک ناظر ضعیفتر» | بنچمارک کلاسیک نظارت مقیاسپذیر که AARها در آن بهتر از انسانها عمل کردند |
| تالار گفتگوی مشترک (Shared forum) | «جایی که ایجنتها یافتهها را منتشر میکنند» | محیط ذخیرهسازی فقطافزودنی و خارج از ساندباکس |
| لاگ خارج از ساندباکس (Out-of-sandbox log) | «ایجنت نمیتواند سوابق خود را ویرایش کند» | نوشتن مستقیم در حافظهی خارجی بهشکلی که هرگونه دستکاری آشکار و مستند شود |
| جریان کاری تجویزی (Prescribed workflow) | «برنامهی گامبهگام از سوی طراح انسانی» | AAR را محدود میکند؛ اغلب در مقایسه با تجزیهی آزادانه باعث افت عملکرد میشود |
| تجزیهی آزادانه (Free decomposition) | «ایجنت خودش تصمیم میگیرد وظیفه را چگونه خرد کند» | توانمندتر در حل مسئله، ولی دشوارتر از نظر ممیزی |
| آستانهی تحقیق و توسعه هوش مصنوعی (AI R&D threshold) | «سطح قابلیت در RSP/FSF» | خودکارسازی کامل پایپلاین تحقیق و توسعه با هزینهای رقابتی در مقایسه با انسان |
| بازهی زمانی فشرده (Compressed timeline) | «رقابت همترازی و رشد قابلیتها» | اگر شتاب رشد قابلیتها از همترازی بیشتر شود، ریسک ناهماهنگی افزایش مییابد |
برای مطالعهی بیشتر
- Anthropic — Automated Weak-to-Strong Researcher؛ منبع اصلی پژوهش.
- Anthropic Responsible Scaling Policy v3.0؛ مفهومپردازی آستانهی تحقیق و توسعهی هوش مصنوعی.
- Anthropic — Measuring AI agent autonomy؛ چارچوببندی جامعتر برای سنجش خودمختاری ایجنتها.
- DeepMind Frontier Safety Framework v3؛ سطوح خودمختاری تحقیق و توسعه در یادگیری ماشین، موازی با چارچوب RSP.
- Burns et al. (2023). Weak-to-Strong Generalization (OpenAI)؛ مسئلهی پایهای که AARها روی آن کار کردند.