
منبع: این نوشته برداشت و تحلیل فارسی نکست ادمین از مطلب Redesigning source control at Anthropic است که تیم کنترل نسخهی Anthropic در ۱۳ اکتبر ۲۰۲۶ منتشر کرده.
خلاصه در یک نگاه
- در Anthropic حالا بخش بزرگی از کد را Claude مینویسد. با این تغییر، گلوگاه دیگر «نوشتن کد» نیست، بلکه زیرساختهایی است که برای سرعت انسان ساخته شده بودند: کنترل نسخه، build و CI.
- ادغامهای روزانه در مونوریپوی شرکت از حدود ۲٬۵۰۰ در ماه مه به بیش از ۳۰٬۰۰۰ در سپتامبر ۲۰۲۶ رسید؛ یعنی بیش از ۱۲ برابر در چهار ماه.
- یک تیم هفتنفره در پنج ماه سیستم کنترل نسخهی تازهای به نام Scion، ابزار بازبینی کد Antique و چند سیستم جانبی ساخت و مونوریپو را از گیت به آن منتقل کرد.
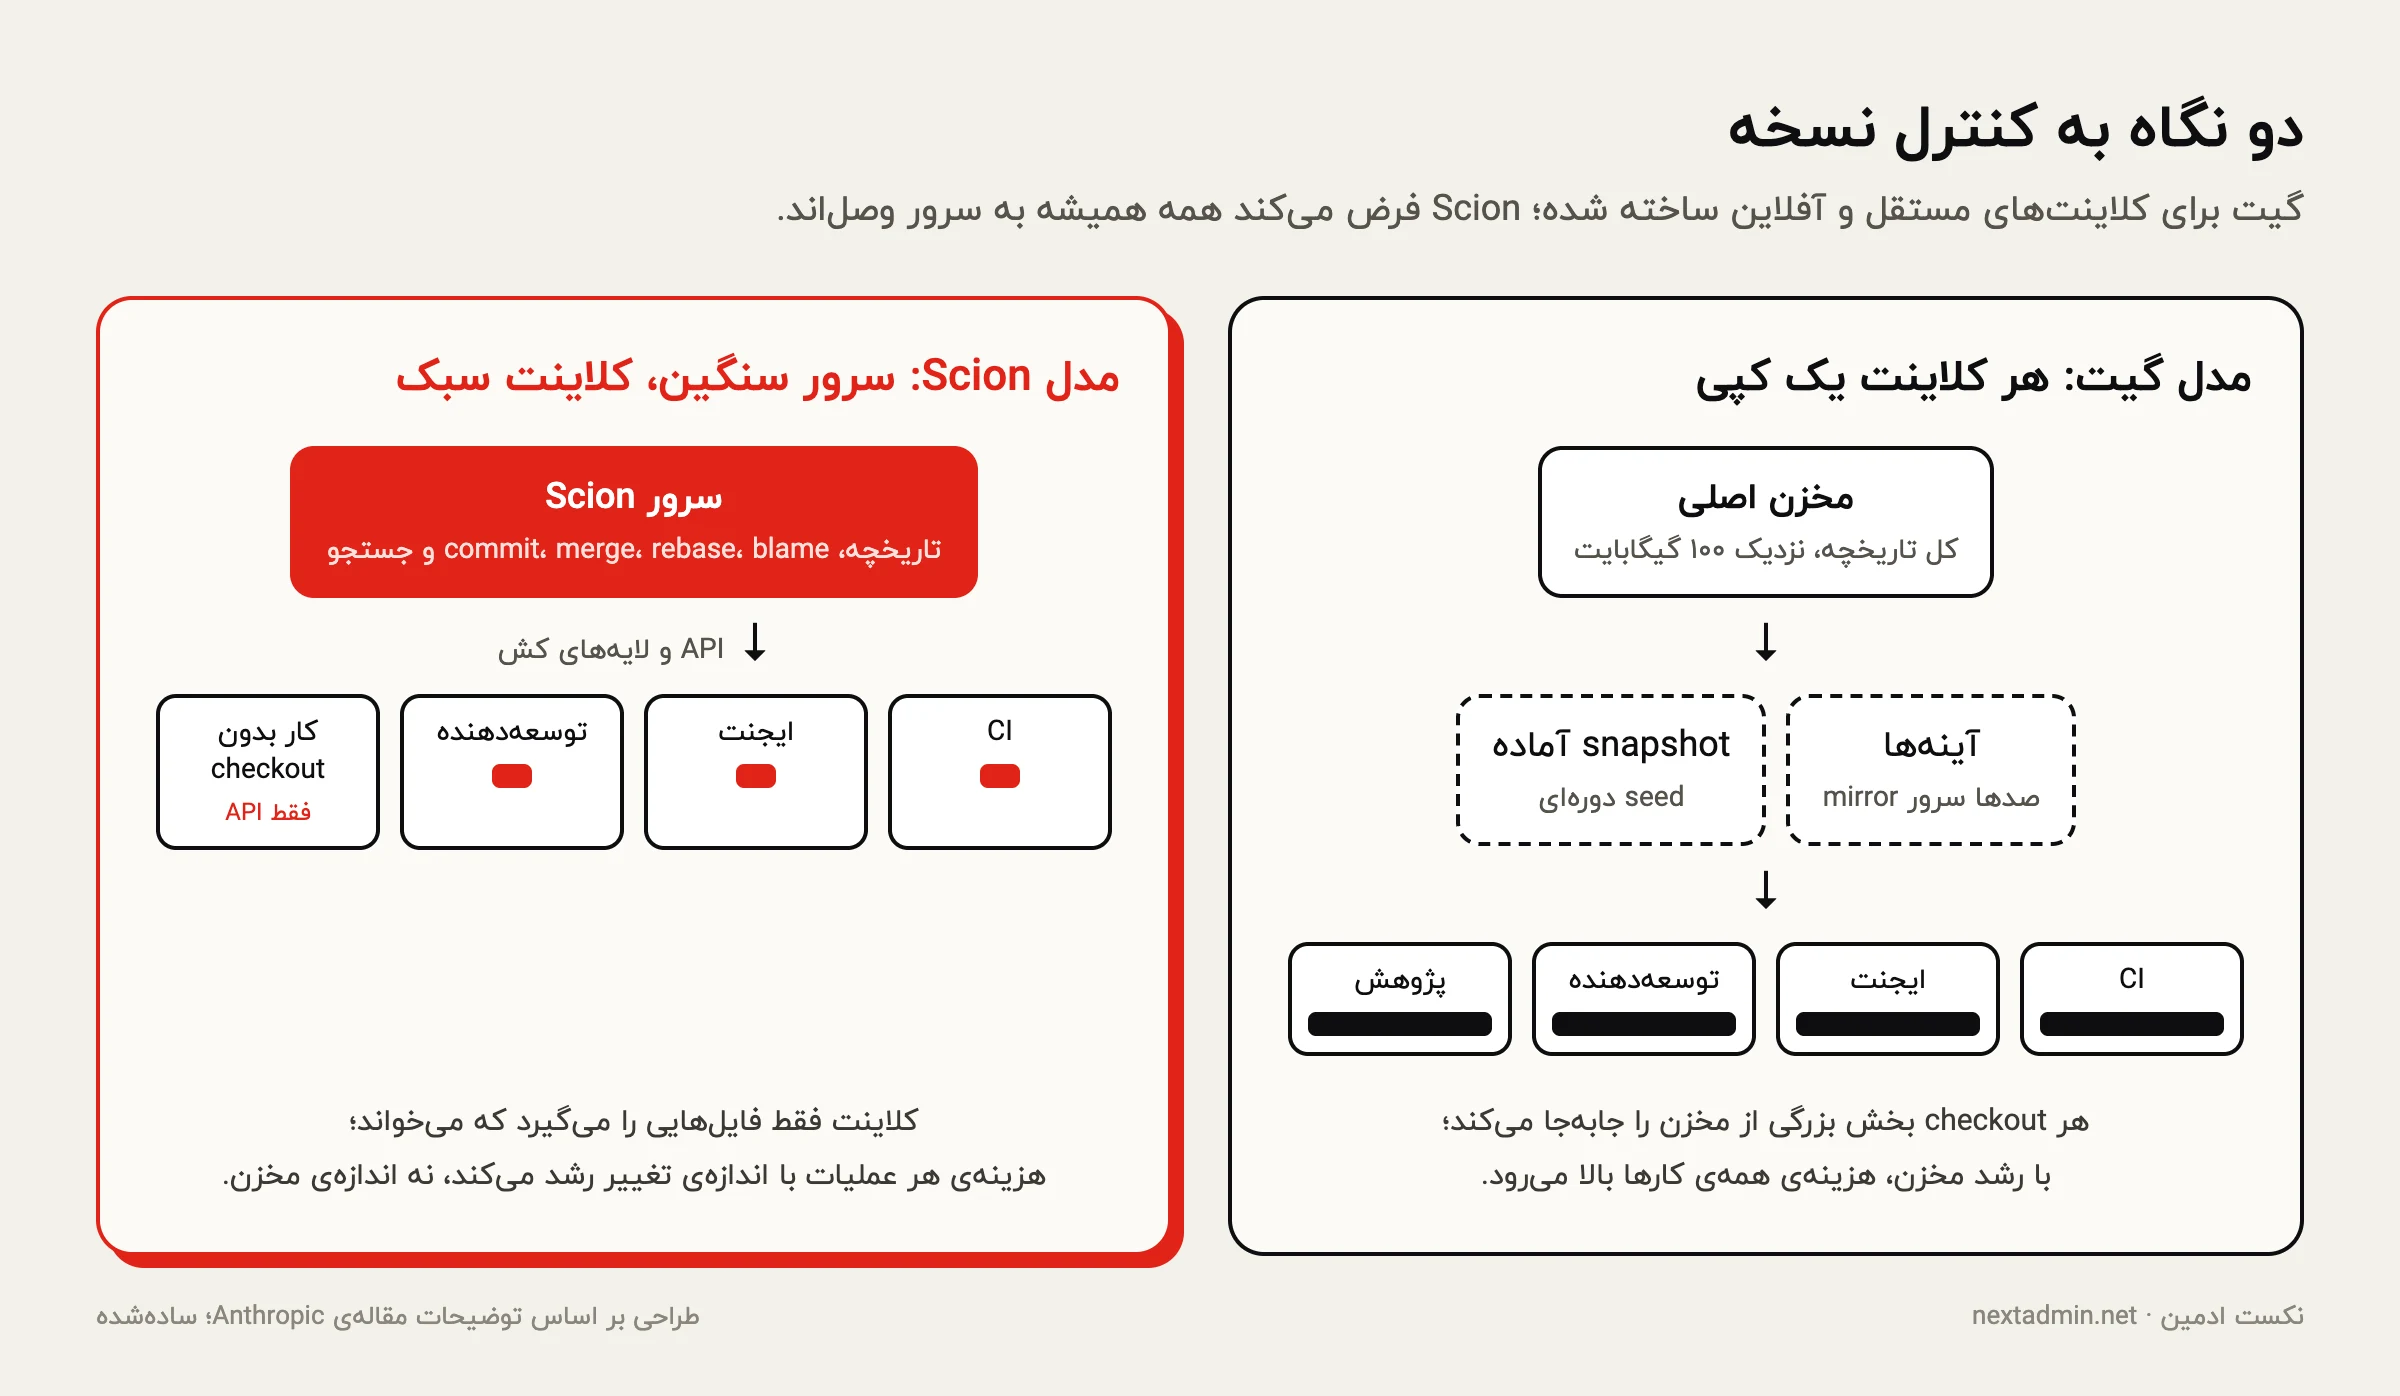
- ایدهی اصلی ساده است: کلاینتها همیشه آنلایناند، پس کار سنگین مثل نگهداری تاریخچه، merge و blame روی سرور انجام شود و کلاینت فقط فایلهایی را بگیرد که واقعاً میخواند.
- نتیجه: checkout در چند ثانیه به جای چند دقیقه، زیرساختی حدود ۲۰۰ برابر سبکتر و ۲۵٪ ظرفیت پردازندهی آزادشده در CI.
- Anthropic تأکید میکند Scion جایگزین عمومی گیت نیست و به جای انتشار آن، ایدههایش را به پلتفرمهای گیت پیشنهاد میدهد.
مسئله: وقتی سرعت نوشتن کد دیگر گلوگاه نیست
ابزارهای توسعه سالها با یک فرض پنهان طراحی شدهاند: تغییرات را آدمها مینویسند، با سرعت آدمها. یک برنامهنویس در روز چند تغییر ادغام میکند و هر تغییر چند اجرای CI دارد. وقتی ایجنتها به صورت موازی کد مینویسند، این عددها چند ده برابر میشوند. هر ایجنت یک محیط کاری میخواهد، هر تغییر تست میشود و هر تست یک checkout تازه لازم دارد.
عددهایی که Anthropic گزارش کرده، اندازهی مسئله را نشان میدهند:
| شاخص | مقدار |
|---|---|
| ادغام روزانه در مونوریپو | از حدود ۲٬۵۰۰ (مه ۲۰۲۶) به بیش از ۳۰٬۰۰۰ (سپتامبر ۲۰۲۶) |
| حجم تاریخچهی شاخهی اصلی | نزدیک ۱۰۰ گیگابایت |
| حجم فشردهی یک کپی کاری | بیش از ۲۵ گیگابایت |
| checkout روزانه فقط برای CI | حدود ۲۵ میلیون، بدون احتساب محیطهای توسعه، سندباکس ایجنتها و کارهای پژوهشی |
| ترافیک فرضی اگر هر checkout کامل و ساده انجام میشد | بیش از ۶۰۰ پتابایت در روز |
تیم پیش از Scion همان راهحلهای آشنا را امتحان کرده بود: صدها سرور آینه (mirror) برای پخش بار، snapshotهای آمادهای که دورهای بهروز میشدند تا هر کلاینت از صفر شروع نکند، و clone جزئی. این ترفندها وقت خریدند، اما با بالا رفتن تعداد ادغامها، نگهداری خودشان به یک مسئلهی عملیاتی تبدیل شد.
چرا مشکل از خود مدل گیت است
گیت برای همکاری توزیعشده ساخته شد: هر clone یک مخزن کامل است، تقریباً همهی عملیات روی ماشین خود کاربر انجام میشود و سرور بیشتر نقش انبار را دارد. این طراحی برای برنامهنویسی که در هواپیما هم میخواهد commit کند عالی است.
اما مشتریهای اصلی یک مونوریپوی بزرگ در دوران ایجنتها شکل دیگری دارند. یک کار CI یا یک سندباکس ایجنت عمر کوتاهی دارد، همیشه به شبکه وصل است و معمولاً فقط چند پوشه را میخواند. فرستادن تاریخچهی ۱۰۰ گیگابایتی به چنین کلاینتی، یا حتی بخش بزرگی از آن، هزینهای است که هیچ سودی ندارد. Anthropic به این نتیجه رسید که مشکل در پیادهسازی نیست، در فرضهای اولیه است.
اصول طراحی Scion
Scion از تجربهی سیستمهای مشابه در شرکتهای بزرگ الهام گرفته، بهخصوص Piper در گوگل و Sapling در متا. Anthropic صریحاً میگوید سرور Sapling، یعنی Mononoke، و مدل دادهی آن (Bonsai) پیشتر بسیاری از این تکنیکها را به کار برده بود. اصول اصلی Scion را میشود اینطور خلاصه کرد:
- کلاینت همیشه آنلاین است. به جای اینکه هر کلاینت بتواند جدا از بقیه کار کند، فرض بر این است که سرور همیشه در دسترس است.
- سرور سنگین، کلاینت سبک. تاریخچه، blame، ساختن commit، merge و rebase روی سرور انجام میشود. کلاینت فقط یک کش محدود و فایلهای کپی کاری را نگه میدارد.
- کنترل نسخه به شکل سرویس. همهی پرسشها از طریق API در دسترساند. خیلی از کارها، مثلاً خواندن یک فایل در یک نسخهی خاص یا ساختن یک commit کوچک، اصلاً به کپی محلی مخزن نیاز ندارند.
- مقیاسپذیری افقی. داده بین ماشینها پخش میشود و هیچجا یک کپی کامل از کل مخزن وجود ندارد. خبری از packfile و کارهای نگهداری دورهای مخزن هم نیست.
- commit ارزان، افزایشی و بدون قفل. هزینهی هر commit به اندازهی تغییر بستگی دارد، نه به اندازهی مخزن. استفاده از ارجاعهای سراسری که همه باید روی آنها قفل بگیرند هم تشویق نمیشود.
- کپی کاری اختیاری و جزئی. بسیاری از کارهای CI بدون checkout انجام میشوند. وقتی هم کپی کاری لازم باشد، کلاینت فقط فایلهایی را میگیرد که واقعاً باز میکند.
Scion از درون
changeset به جای snapshot کامل
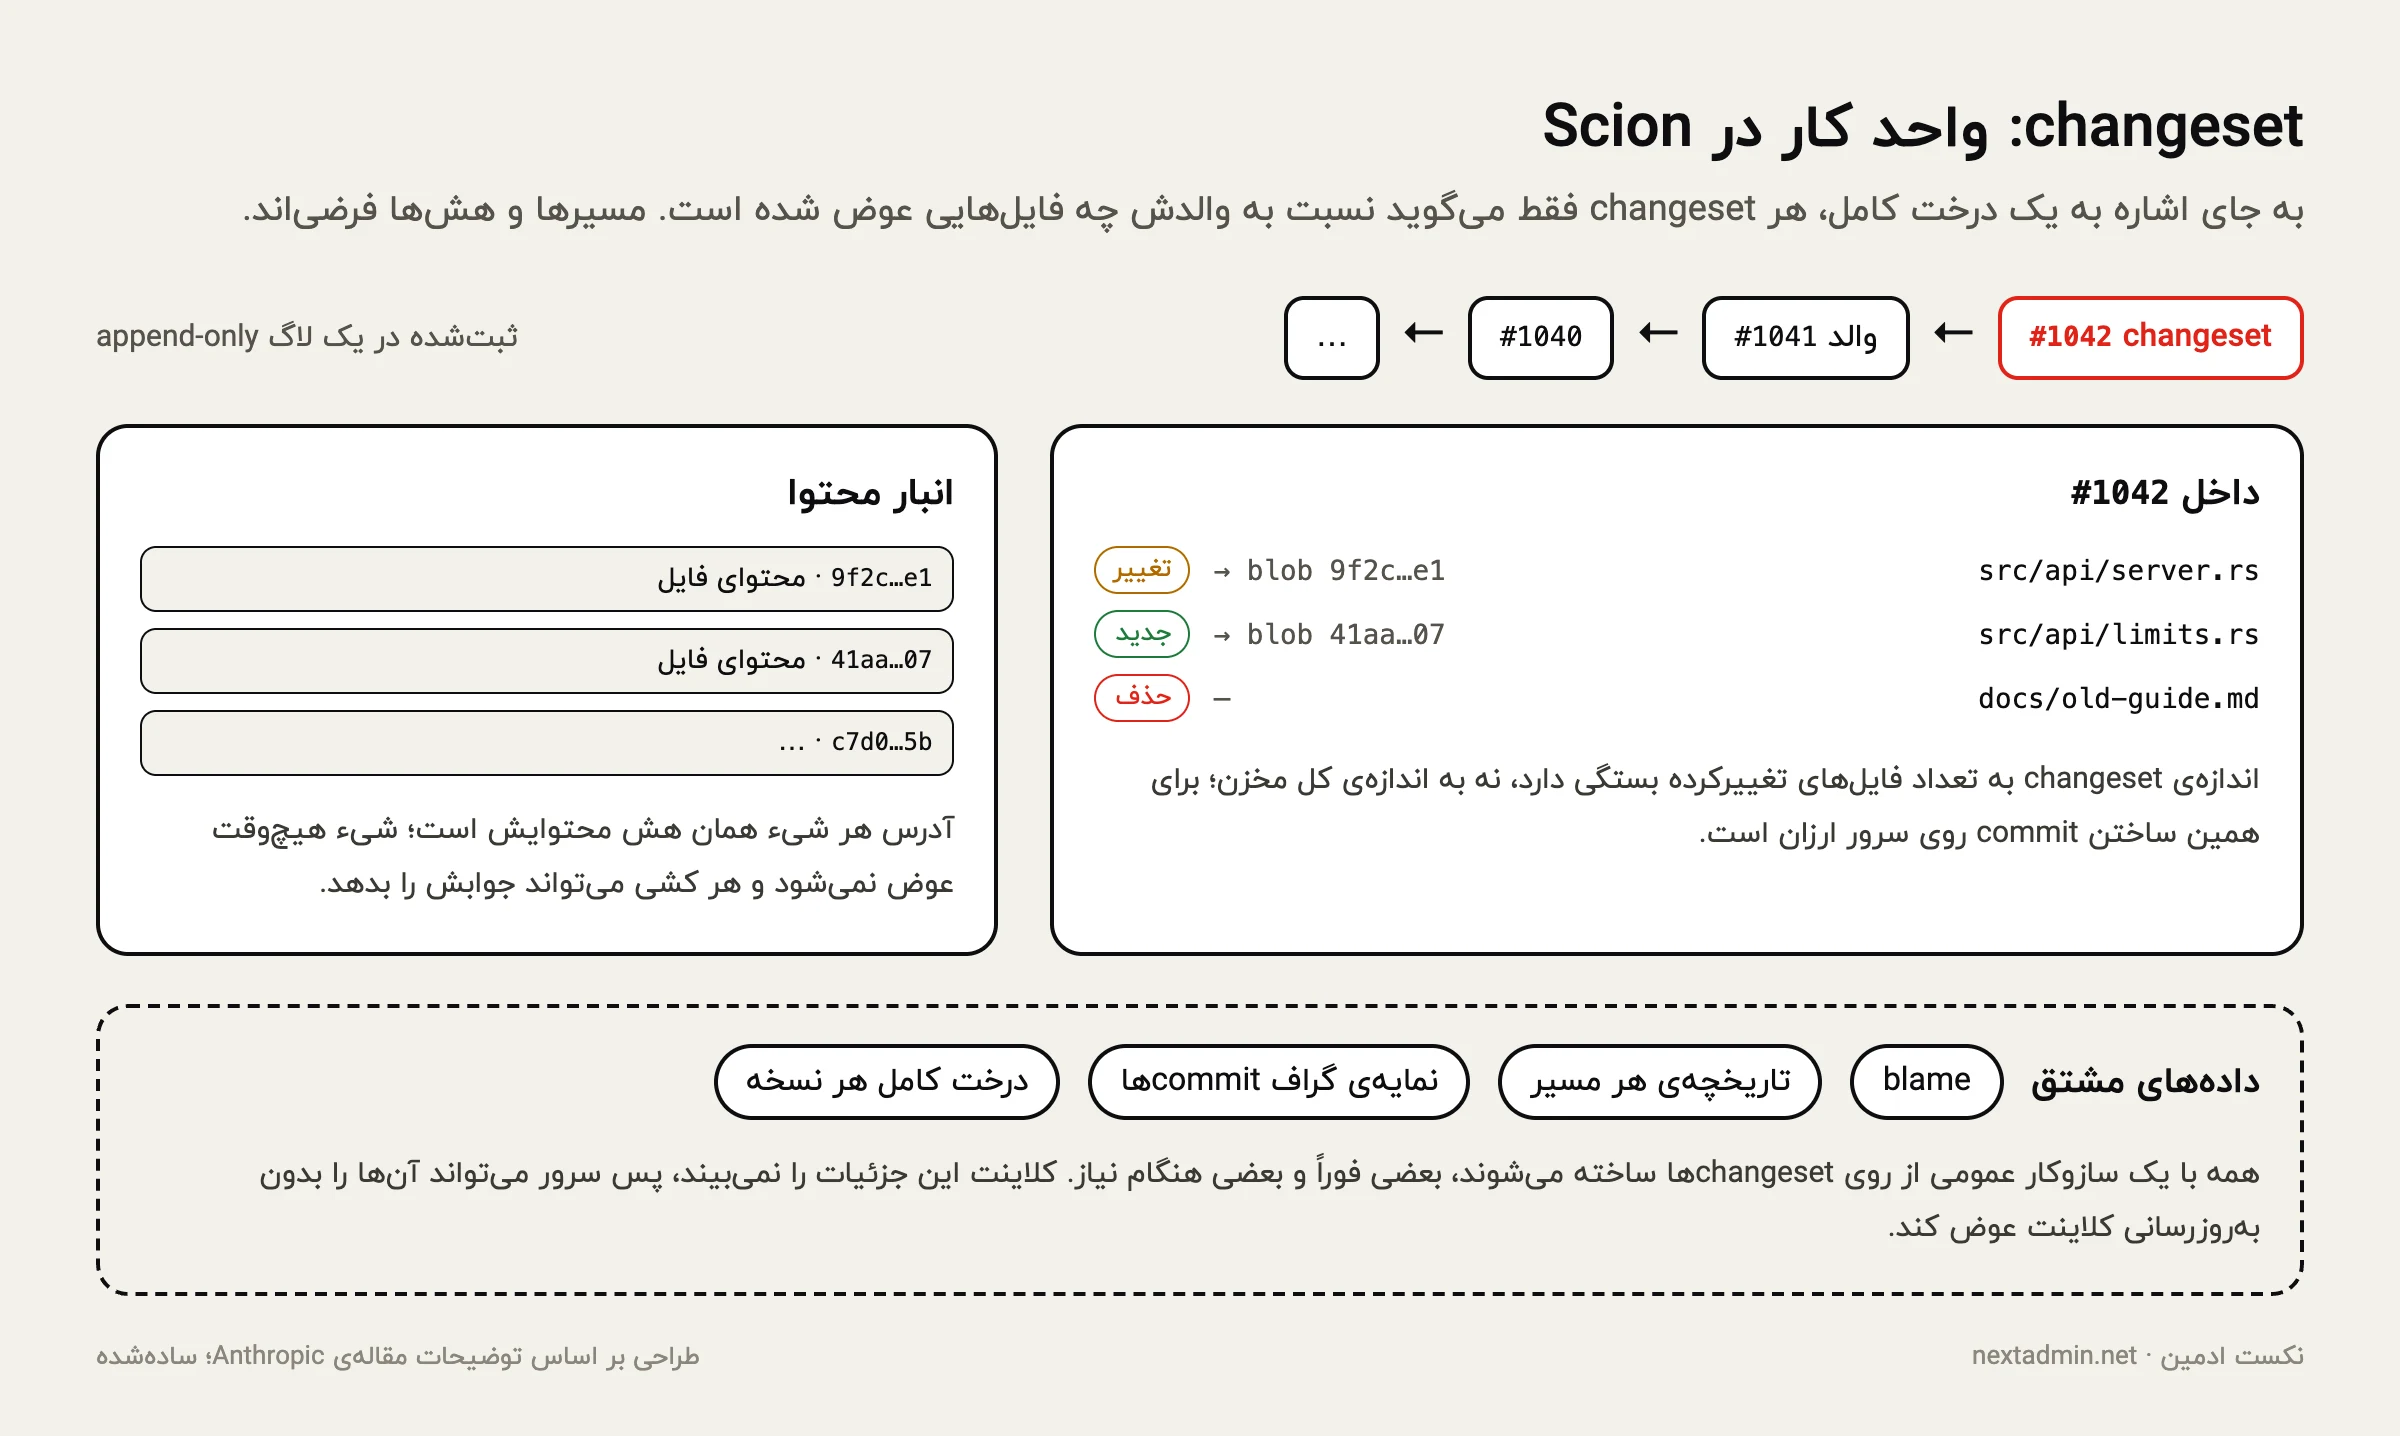
در گیت هر commit به درخت کامل پروژه اشاره میکند (هرچند زیردرختهای بدون تغییر بین commitها مشترکاند). واحد کار در Scion یک changeset است: فهرست فایلهایی که نسبت به والد اول تغییر کردهاند، و برای هر فایل یک اشارهگر به محتوایش در انبار. آدرس هر محتوا همان هش آن است (content-addressed)، پس یک محتوای ثابت همیشه همان آدرس را دارد. changesetها در یک لاگ پیشنویس (write-ahead log) ثبت میشوند.
مزیت این مدل این است که ساختن یک commit روی سرور فقط به اندازهی همان تغییر کار دارد. وقتی روزانه دهها هزار تغییر کوچک ادغام میشود، این تفاوت تعیینکننده است.
دادههای مشتق
چیزهایی مثل blame، تاریخچهی یک مسیر یا نمایهی گراف commitها مستقیماً ذخیره نمیشوند. همه با یک سازوکار عمومی و بازگشتی از روی changesetها محاسبه میشوند. برای هر نوع میشود تصمیم گرفت که فوراً پس از هر تغییر ساخته شود یا هنگام اولین درخواست. چون کلاینت این جزئیات را نمیبیند، تیم میتواند آنها را عوض یا بهینه کند بدون اینکه کسی کلاینتش را بهروز کند.
پروتکل واکشی
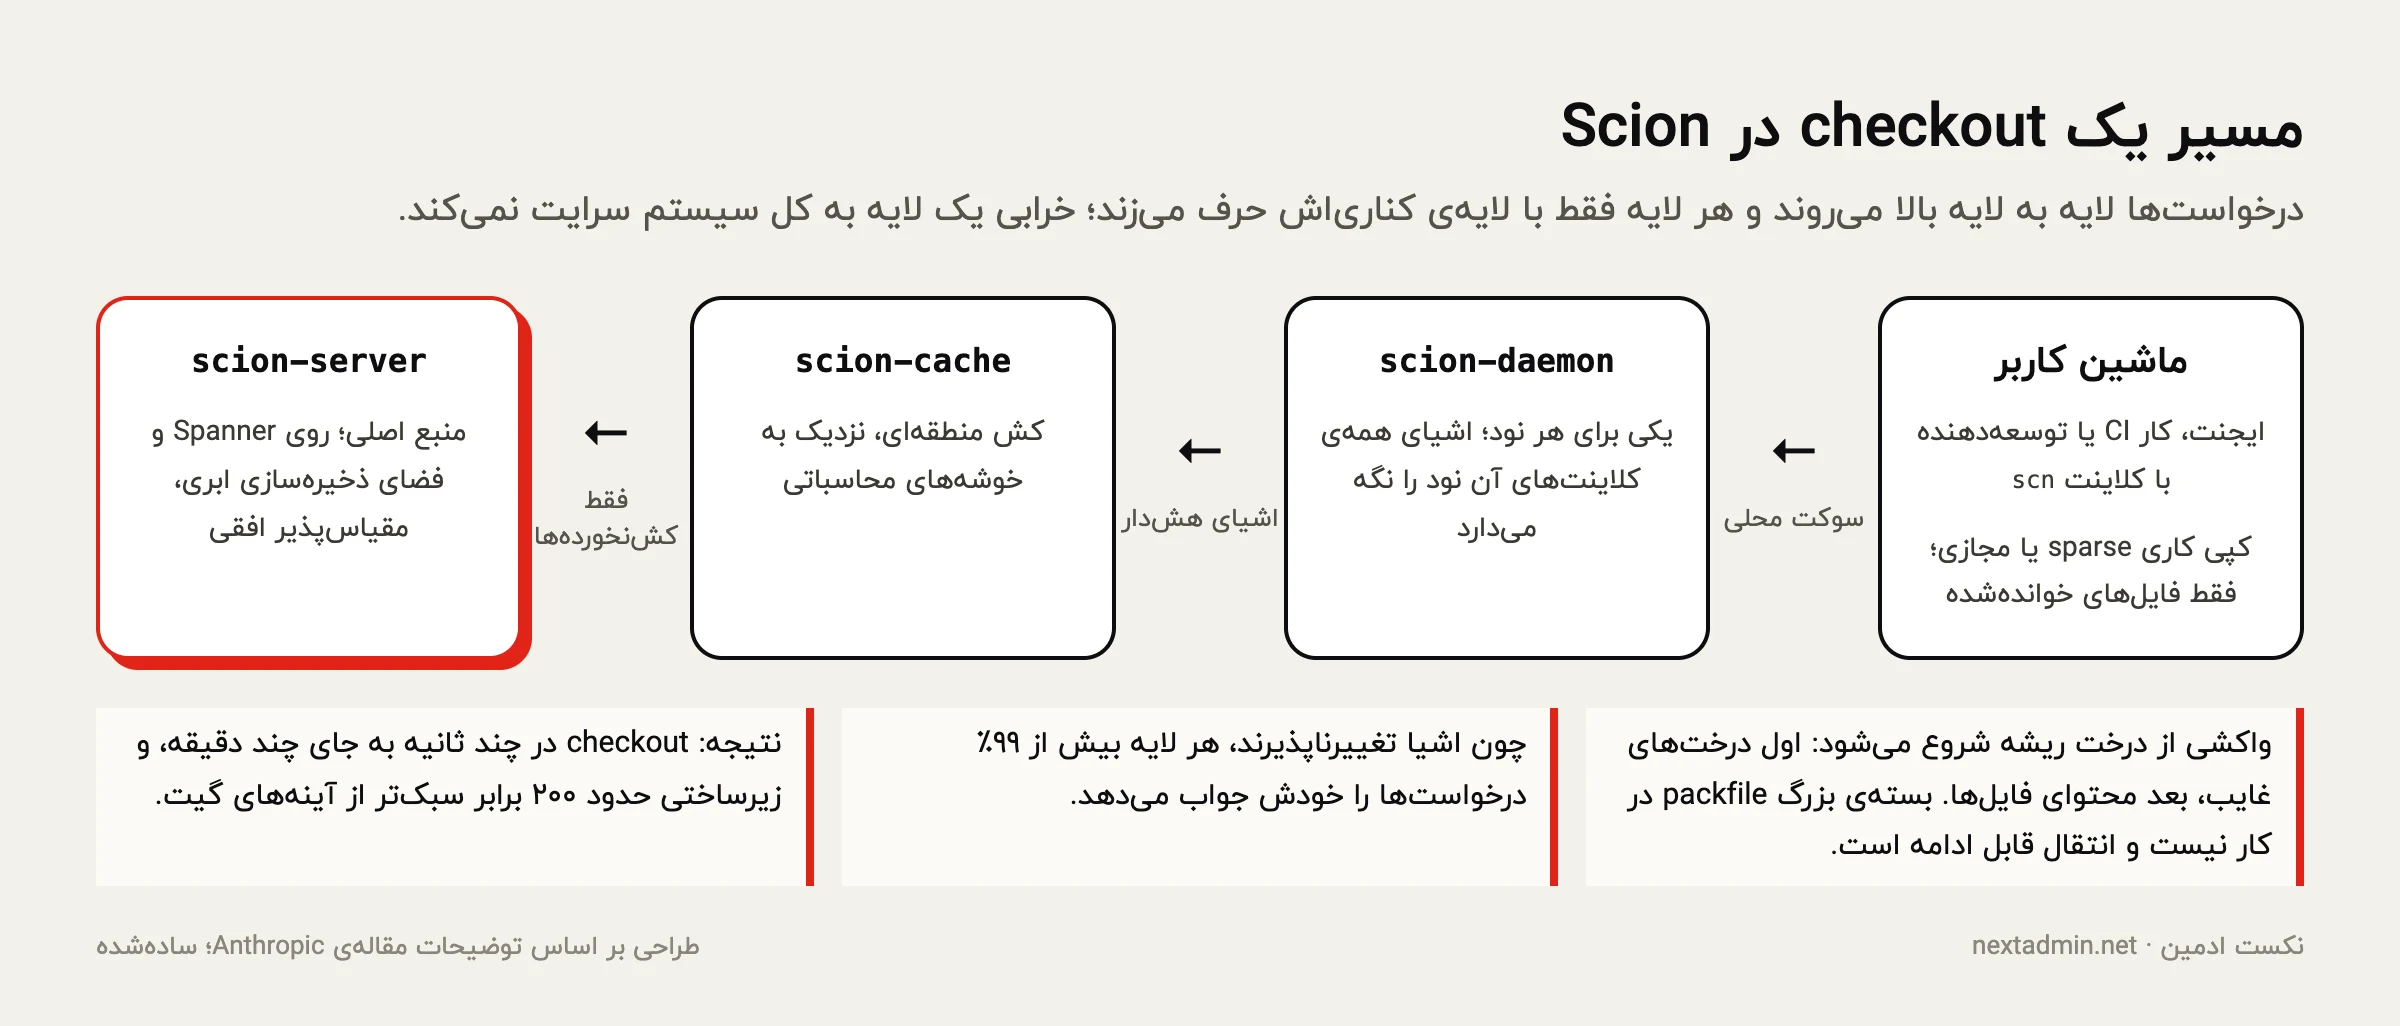
کلاینت Scion که scn نام دارد، از درخت ریشهی نسخهی موردنظر شروع میکند. اول درختهایی را که ندارد میگیرد و بعد محتوای فایلها را. هر درخواست برای یک شیء تغییرناپذیر با هش مشخص است، پس هر کشی در مسیر میتواند جوابش را بدهد. برخلاف گیت، یک بستهی بزرگ packfile ساخته نمیشود و اگر انتقال وسط کار قطع شود، از همانجا ادامه پیدا میکند. checkout جزئی (فقط چند پوشه) و checkout مجازی (فایلها هنگام باز شدن دانلود میشوند) هم بدون ترفند خاصی کار میکنند.
کش لایهای
روی هر ماشین یک scion-daemon اجرا میشود که اشیای همهی کلاینتهای آن ماشین را نگه میدارد. پشت آن کشهای منطقهای (scion-cache) قرار دارند و در آخر سرورهای اصلی (scion-server) که روی Spanner و فضای ذخیرهسازی ابری کار میکنند. هر لایه فقط با لایهی کناریاش حرف میزند تا خرابی یک بخش به همهجا سرایت نکند. چون اشیا هیچوقت عوض نمیشوند، هر لایه بیش از ۹۹٪ درخواستها را خودش جواب میدهد.
نتایج
| شاخص | نتیجه |
|---|---|
| مصرف پردازنده و حافظهی زیرساخت | حدود ۲۰۰ برابر کمتر از مجموعهی آینههای گیت |
| سرعت checkout برای CI و پژوهش | حدود دو مرتبهی بزرگی سریعتر؛ چند ثانیه به جای چند دقیقه |
| ظرفیت پردازندهی آزادشده در CI | حدود ۲۵٪ |
| نرخ پاسخ از کش | بیش از ۹۹٪ در هر لایه |
| تیم و زمان | هفت نفر، پنج ماه؛ در همین مدت ادغامهای روزانه حدود ۱۰ برابر شد |
درسهایی که فراتر از کنترل نسخهاند
جالبترین بخش گزارش Anthropic شاید نه خود Scion، که روش ساختن آن باشد. بخش بزرگی از کد را Claude نوشته و چند نکته از این تجربه برای هر تیمی که با ایجنتها کار میکند آموزنده است:
- نقش مهندس عوض شد. مهندسان قیدهای طراحی و اهداف مقیاس را تعیین میکردند و کار اصلیشان رد کردن خروجیهایی بود که این قیدها را میشکست؛ مثلاً اسکن کامل لاگ commitها در جایی که باید از سرویس بازبینی کد پرسیده میشد. بازبینی هم از «خط به خط» به «بررسی نیت تغییر» رسید.
- ایجنت هم اشتباههای خودش را دارد. Claude گاهی بیش از حد مهندسی میکرد یا الگوهای پروژه را رعایت نمیکرد. بازبینی سختگیرانه هم گاهی نتیجهی عکس داشت و کد را پر از اعتبارسنجیهای غیرضروری میکرد.
- کیفیت با ابزار بهتر. Claude شبیهسازیهای ایزوله از تعامل با زیرساخت، fuzzing و محدودسازی نرخ ساخت و چند بهینهسازی واقعی هم پیدا کرد؛ از جمله ایندکسی که در یک پرسش اجدادی استفاده نمیشد. بازنویسی خط لولهی انتقال داده از گیت به Scion هم با ۲۰ برابر حافظهی کمتر و ۴ برابر سرعت بیشتر تمام شد.
- امنیت دقیقتر. Scion دسترسی را در سطح مخزن و حتی پوشه کنترل میکند. قوانین بازبینی هم تغییرات کمخطر مثل اصلاح یک کامنت را از تغییر در منطق حساس جدا میکنند تا بازبین انسانی وقتش را روی پرریسکترین تغییرات بگذارد.
- عملیات با ایجنت. برای هر مؤلفه، مثل daemon، کش یا صف ادغام، یک نمونهی Claude با تلهمتری و لاگها آن را زیر نظر دارد و مشکلهای ظریفی را میبیند که هشدارهای ثابت از دست میدهند. هشدارهای سنتی هم کنار گذاشته نشدهاند.
- صف ادغام بدون قفل سراسری. قفل سراسری روی صف ادغام با این حجم جور درنمیآمد. Anthropic به جای آن به تستهای خودکار پس از ادغام و پیش از استقرار تکیه میکند. تعارض بین تغییرهای همزمان پیش میآید، اما به گفتهی تیم، Claude معمولاً زودتر از آنکه انسانی متوجه شود آن را حل میکند.
Scion جایگزین گیت نیست
Anthropic صریحاً میگوید Scion فقط برای مونوریپوهای خیلی بزرگ یا بار سنگین ایجنتها منطقی است. چون از مدل گیت فاصله میگیرد، استفاده از آن یعنی مهاجرت کل چرخهی توسعه، از بازبینی کد تا جستجو و CI، و ابزارهای داخلی شرکت هم بهشدت اختصاصیاند. به همین دلیل انتشار یک نسخهی عمومی که برای همه مناسب باشد را عملی نمیداند.
در عوض، این ایدهها را برای پلتفرمهای گیت پیشنهاد میکند:
- سرور گیت لازم نیست ساختاری شبیه کلاینت گیت داشته باشد و میتواند معماری کاملاً متفاوتی داشته باشد.
- سرورها مجموعهی کاملی از RPCهای سمت سرور ارائه کنند، ترجیحاً استاندارد بین GitHub، GitLab و بقیه، تا ابزارها بدون clone کار کنند.
- پروتکل مذاکرهی گیت (negotiation) از نو طراحی شود.
- قابلیتهای sparse و shallow طوری طراحی شوند که با هم خوب ترکیب شوند.
Anthropic گفته مایل است در این مسیر با GitHub، GitLab و جامعهی متنباز همکاری کند.
برای تیمهای ما چه معنایی دارد؟
بیشتر تیمهای ایرانی مونوریپوی ۱۰۰ گیگابایتی ندارند و قرار هم نیست سیستم کنترل نسخهی خودشان را بسازند. اما روندی که Anthropic توصیف میکند به همه میرسد: هر چه سهم ایجنتها در نوشتن کد بیشتر شود، تعداد تغییرها، اجراهای CI و checkoutها بیشتر میشود. خبر خوب این است که بخش مهمی از ایدههای Scion همین امروز با خود گیت قابل استفاده است.
۱. کل تاریخچه را جابهجا نکنید
clone جزئی محتوای فایلها را فقط هنگام نیاز دانلود میکند و sparse checkout فقط پوشههای لازم را روی دیسک میآورد. ترکیب این دو، نزدیکترین چیز به کلاینت سبک Scion در دنیای گیت است:
git clone --filter=blob:none --no-checkout https://git.example.com/team/monorepo.git
cd monorepo
git sparse-checkout set services/api libs/shared
git checkout main
اگر مخزن بزرگی دارید، scalar clone که همراه گیت نصب میشود همین تنظیمات را بهاضافهی نگهداری پسزمینه یکجا انجام میدهد. در CI هم معمولاً یک واکشی سطحی کافی است:
git init -q repo && cd repo
git remote add origin https://git.example.com/team/monorepo.git
git fetch --depth=1 --filter=blob:none origin "$COMMIT_SHA"
git checkout -q FETCH_HEAD
۲. کش را نزدیک ماشینها بیاورید
لایهی کش منطقهای Scion برای ما معنای ملموستری دارد: دسترسی به GitHub و سرویسهای خارجی از داخل کشور کند و ناپایدار است. یک آینهی داخلی (مثلاً Gitea یا GitLab با قابلیت mirror) در همان شبکهی runnerهای CI، هم سرعت را بالا میبرد و هم وابستگی به اینترنت بینالملل را کم میکند. برای runnerهای ماندگار، نگه داشتن یک clone محلی و استفاده از git clone --reference هم ارزان و مؤثر است.
۳. بپرسید آیا اصلاً checkout لازم است
خیلی از کارها، مثل خواندن یک فایل تنظیمات، بررسی فهرست فایلهای تغییرکرده یا گذاشتن برچسب روی یک PR، با API پلتفرم انجام میشوند. برای نمونه gh api repos/OWNER/REPO/contents/path?ref=main یک فایل را بدون clone برمیگرداند. این همان اصل «کنترل نسخه به شکل سرویس» در مقیاس کوچک است.
۴. برای حجم بالای تغییرها آماده شوید
اگر ایجنتها PR باز میکنند، صف ادغام (merge queue) و تستهای پس از ادغام را جدی بگیرید. قوانین مالکیت کد (CODEOWNERS) و بازبینی متناسب با ریسک، همان کاری را میکنند که Anthropic با جدا کردن تغییرات کمخطر از پرخطر انجام داده است.
۵. نقش بازبین را بازتعریف کنید
شاید مهمترین درس این گزارش این باشد که با ورود ایجنتها، کار مهندس از نوشتن کد به تعیین قیدها و بررسی نیت تغییر منتقل میشود. قیدهای معماری را مکتوب کنید تا هم انسان و هم ایجنت بتوانند خروجی را با آنها بسنجند.
پرسشهای رایج
Scion چیست؟
Scion سیستم کنترل نسخهی داخلی Anthropic است که برای مونوریپوی این شرکت و بار سنگین ایجنتها ساخته شده. در آن، تاریخچه و عملیات سنگین روی سرور انجام میشود و کلاینتها فقط فایلهایی را میگیرند که لازم دارند.
آیا Scion متنباز است یا میشود از آن استفاده کرد؟
خیر. Scion ابزار داخلی Anthropic است و این شرکت انتشار نسخهی عمومی آن را عملی نمیداند. به جای آن، ایدههایش را برای پلتفرمهای گیت و جامعهی متنباز توضیح داده است.
آیا این یعنی گیت منسوخ شده است؟
نه. خود Anthropic میگوید Scion فقط برای مخزنهای خیلی بزرگ یا بار سنگین ایجنتها منطقی است. برای بیشتر تیمها گیت، بههمراه clone جزئی، sparse checkout و کش داخلی، کاملاً کافی است.
Scion چه ربطی به Piper و Sapling دارد؟
Piper در گوگل و Sapling در متا سیستمهای کنترل نسخه برای مونوریپوهای بسیار بزرگاند. Scion از تجربهی آنها استفاده کرده و Anthropic اشاره میکند که سرور Sapling، یعنی Mononoke، و مدل دادهی Bonsai پیشتر بسیاری از این تکنیکها را به کار برده بودند.
تیم کوچک ما از کجا شروع کند؟
زمان checkout و حجم انتقال در CI را اندازه بگیرید. بعد clone جزئی و sparse checkout را امتحان کنید، یک آینهی داخلی نزدیک runnerها راه بیندازید و کارهایی را که فقط به خواندن یک فایل نیاز دارند به API پلتفرم منتقل کنید.
منبع
Nick G. and the source control team, Redesigning source control at Anthropic, Anthropic، ۱۳ اکتبر ۲۰۲۶. عددها و ادعاهای فنی این نوشته از همین منبع است؛ نمودارها را نکست ادمین بر اساس توضیحات آن بازطراحی کرده و بخش «برای تیمهای ما چه معنایی دارد؟» تحلیل خود ماست.